تصور کنید یک برنامهنویس برای تست یک تغییر کوچک در کد، باید ۶ ساعت در صف انتظار بماند تا فقط ۳۰ ثانیه خروجی بگیرد. این کابوس در Ai2 به پایان رسیده و حالا همان تسکهای دیباگ در کمتر از ۵ دقیقه اجرا میشوند.
این جهش در بهرهوری نتیجهی یک تصمیم جسورانه است: حذف کامل سطوح اولویت (Priority) و جایگزینی آن با یک سیستم سختگیرانهی بودجهبندی زمان واحد پردازش گرافیکی (GPU) — شبیه به مدیریت حساب بانکی که هر پروژه سهمی مشخص از موجودی کل دارد.
مدیریت هزاران پردازندهی NVIDIA H100، B200 و B300 در خوشههایی با ظرفیت ۸۸ تا ۱۰۲۴ گره، نبردی دائمی علیه «تراژدی منابع مشترک» است. طبق گزارش داخلی این مؤسسه، تقاضا برای GPUها همیشه ۲ تا ۳ برابر ظرفیت فیزیکی است؛ یعنی برای هر ساعت محاسباتی، سه پروژه مختلف در حال رقابت هستند. این چالش با یافتههای پژوهشی دربارهی تأثیر رقابت آزاد در GPUها بر افزایش تأخیر استنتاج همسو است که نشان میدهد نبود مدیریت متمرکز میتواند بهرهوری را به شدت کاهش دهد.
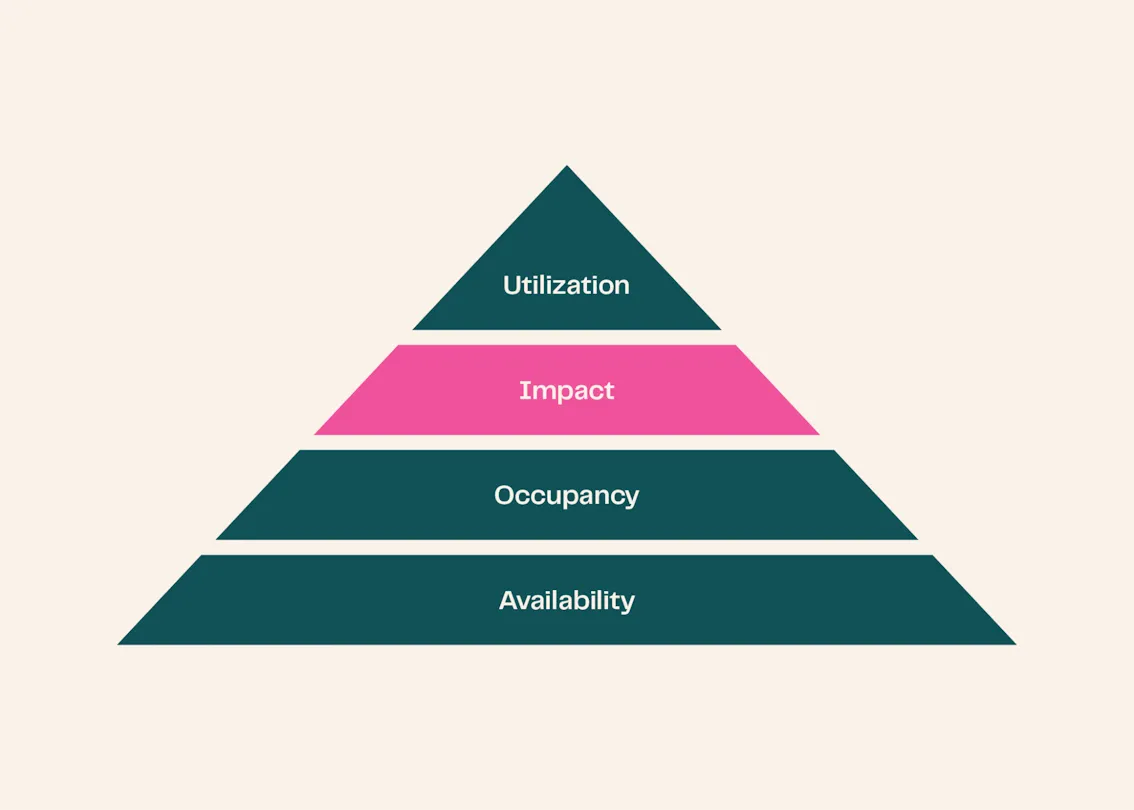
تیم زیرساخت Ai2 وظیفهی خود را در قالب یک هرم چهارلایه تعریف میکند: در قاعده، در دسترس بودن (Availability) سختافزار قرار دارد، سپس میزان اشغال (Occupancy)، در لایهی سوم تأثیرگذاری (Impact) پروژهها و در رأس هرم، بهرهوری (Utilization) نهایی قرار میگیرد.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی مراکز داده اشاره کردیم، مدیریت منابع در مقیاس بزرگ بدون سیاستهای سختگیرانه به هرجومرج میانجامد. تا پیش از اکتبر ۲۰۲۶، Ai2 از سیستم اولویتبندی استفاده میکرد که منجر به پدیدهی «اشغال غیرقانونی GPU» شده بود. پژوهشگران برای اینکه جایگاه خود را در صف از دست ندهند، کدهای بیهودهای را اجرا میکردند تا فقط جایگاهشان را رزرو کنند.
این وضعیت باعث «تورم اولویتها» شد؛ جایی که در نهایت ۱۰۰٪ کارهای ارسالی با برچسب «اولویت بالا» علامت میزدند و سیستم عملاً فلج میشد. مهندسان سیستم نیز بخش زیادی از وقت خود را صرف مذاکره با پژوهشگران میکردند تا متقاعدشان کنند کارهایشان را برای تعمیرات سختافزاری متوقف کنند.
تیم زیرساخت ابتدا سعی کرد با کنترل شدیدتر روی تنظیمات یا اختصاص انحصاری GPU به پروژههای خاص، مشکل را حل کند. اما این روش بیش از حد خشک بود. به دلیل ماهیت فصلی پژوهشها، وقتی یک تیم کاری نداشت، GPUهای اختصاصیاش بیکار میماند در حالی که تیمهای دیگر در صف انتظار میسوختند.
این مشکل دقیقاً مشابه یافتههای یک مقاله در سال ۲۰۱۱ دربارهی «انصاف در منابع غالب» است. در آن پژوهش اشاره شده بود که کاربران برای حفظ ماشینهای اختصاصی، کدهای خود را با حلقههای بینهایت پر میکنند تا نرخ بهرهوری را بهصورت مصنوعی بالا ببرند. Ai2 دریافت که پژوهشگران انگیزهی این را دارند که ارزش واقعی کارشان را پنهان کنند تا منابع بیشتری را در اختیار بگیرند.
برای حل این بحران، تیم زیرساخت از «رزرو جایگاه» به «تخصیص زمان» تغییر مسیر داد. آنها سیستمی سلسلهمراتبی ایجاد کردند که در آن مدیران ارشد مانند سرمایهگذاران عمل میکنند و بر اساس تأثیر احتمالی هر پروژه، درصدی از کل ظرفیت خوشه را به آن اختصاص میدهند.
بر اساس مستندات جدید Ai2، این مکانیزم سه رکن اصلی دارد:
- درخواستهای بودجهمحور: هر درخواستی برای حفاظت در برابر پیشدستی (Preemption) باید بودجه داشته باشد. دیگر هیچ اولویتی «رایگان» نیست.
- توزیع منصفانه سلسلهمراتبی: مدیران سهم هر پروژه را تعیین میکنند. مثلاً پروژه A1 فارغ از وضعیت سایر صفها، حق ادعای ۳۵٪ از کل ظرفیت را دارد.
- هزینهی تقلب: اشغال بیهودهی GPU حالا از بودجهی واقعی تیم کسر میشود. بنابراین تقلب در سیستم، گرانتر از درخواست صادقانهی زمان است.
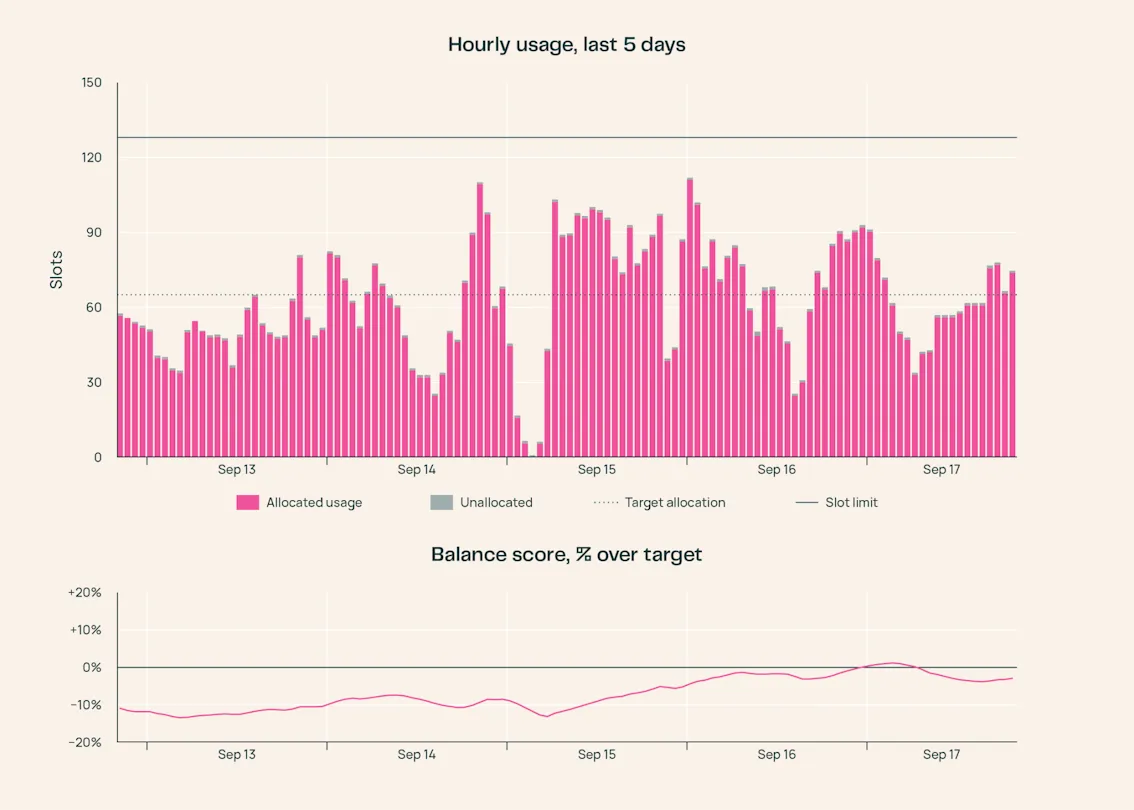
در کنار بودجهبندی، یک زمانبند «سهم منصفانه» (Fair-share) طراحی شد که از مدلهای قدیمی مانند Hadoop و SLURM الهام گرفته است. این سیستم میزان اشغال را در یک بازهی ۷ روزه رصد میکند و پروژههایی که کمتر از سهم خود استفاده کردهاند را در اولویت قرار میدهد.
این ساختار اجازه میدهد تیمها در زمانهای پیک، بیش از سهم خود از منابع استفاده کنند (Bursting)، به شرطی که در روزهای قبل از ظرفیت خود استفاده نکرده باشند. سیستم دو نوع اشغال را تعریف میکند: «اشغال تخصیصی» که از بودجه کسر شده و محافظت میشود، و «اشغال غیرتخصیصی» که رایگان است اما هر لحظه ممکن است توسط یک درخواست بودجهدار حذف شود.
برای جلوگیری از مسدود شدن خوشه توسط کارهای طولانیمدت، Ai2 «قرارداد زمانبندی» را معرفی کرد. کاربران باید یک «حداقل زمان اجرا» را اعلام کنند تا پیشرفت معناداری در کارشان حاصل شود. در این بازهی زمانی، کار محافظت میشود و پس از آن، سیستم میتواند برای بازتوزیع منابع، کار را متوقف کرده و دوباره در صف قرار دهد.
چرخهی حیات یک تسک اکنون اینگونه است: ارسال با حداقل زمان اجرا $ \rightarrow $ زمانبندی بر اساس سهم منصفانه $ \rightarrow $ اجرا و کسر از بودجه $ \rightarrow $ تداوم اجرا در صورت اولویت $ \rightarrow $ توقف یا تکمیل.
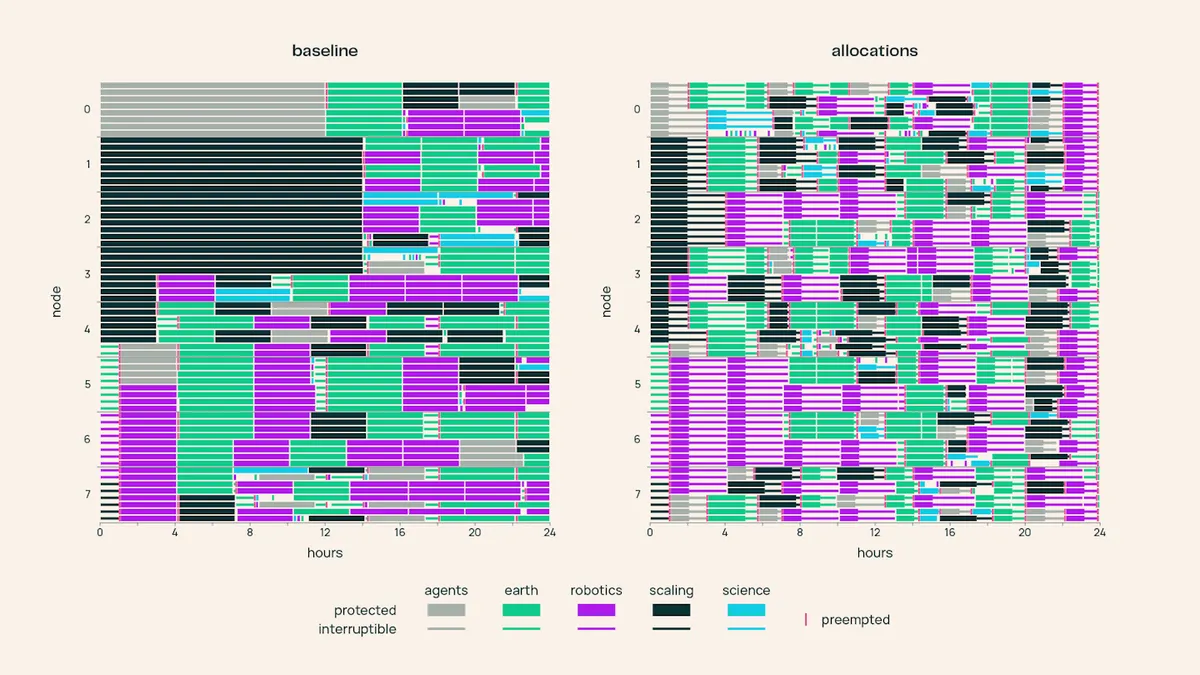
به دلیل حساسیت بالای این تغییرات، Ai2 یک محیط شبیهساز ساخت تا زمانهای انتظار را پیشبینی کند. آنها بهطور خاص «تسکهای دیباگ» (تعداد GPU کم و زمان اجرای زیر ۱۵ دقیقه) را تست کردند. شبیهسازیها پیشبینی میکردند که زمان انتظار p90 از ۶ ساعت به ۵ دقیقه کاهش یابد.
طبق گزارش منتشر شده در ۹ اکتبر ۲۰۲۶، نتایج واقعی حتی از شبیهسازیها هم بهتر بود:
- تأخیر دیباگ: زمان انتظار p90 برای کارهای کوچک از ۲ ساعت به تنها ۳۰ ثانیه رسید.
- صفهای عمومی: میانگین انتظار در بزرگترین خوشهی H100 از ۵ دقیقه به ۲۴ ثانیه کاهش یافت. این بهینهسازی در مقیاس H100 اهمیت ویژهای دارد، چرا که برای سرویسدهی یک تریلیون توکن در مدل Llama 3.3، به ۳۶۷ پردازنده H100 نیاز است.
- نرخ اشغال: اشغال خوشه در ۹۸٪ ثابت ماند و ۱۸٪ از زمانها توسط درخواستهای غیرتخصیصی پر شد تا هیچ GPUیی بیکار نماند.
- کاهش زحمت عملیاتی: نیاز به دخالت انسانی برای تخلیهی گرههای معیوب ۷۴٪ کم شد، چون گرهها پس از پایان حداقل زمان اجرا، بهطور خودکار تخلیه میشوند.
البته این انتقال بدون چالش نبود. پژوهشگران با از دست دادن جلسات تعاملی طولانیمدت (Interactive Sessions) دچار مشکل شدند، زیرا سقف محافظت ۸ ساعت است و پس از آن وضعیت حافظهی موقت (Volatile State) از بین میرود.
برای حل این مشکل، Ai2 دو پروژه را در نقشهی راه خود قرار داده است: ایجاد یک خوشهی مخصوص CPU برای آمادهسازی دادهها و توسعهی سیستمی برای بازیابی جلسات پس از توقف اجباری.
گام بعدی شما
- اگر مدیر زیرساخت هستید، مدل «بودجهبندی زمان» را جایگزین «سطوح اولویت» کنید تا از تورم اولویتها جلوگیری شود.
- برای تسکهای سریع، مفهوم «حداقل زمان اجرا» را تعریف کنید تا تعادل بین پیشرفت پروژه و بهرهوری خوشه برقرار شود.
- از ابزارهای شبیهسازی برای پیشبینی زمان انتظار قبل از اعمال تغییرات در زمانبند (Scheduler) استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو