
دقت رباتیک معمولاً زمانی شکست میخورد که مهندسان سعی میکنند تکتک حرکات یک تسک پیچیده را دیکته کنند. AlphaNIST، رویکرد جدیدی که در گزارش ۱۳ اکتبر ۲۰۲۶ در وبسایت alpha-nist.github.io منتشر شد، ثابت میکند رباتها اگر تنها یک پاداش باینری (Binary Reward) برای موفقیت و تجربهای وسیع داشته باشند، میتوانند راهکارهای خلاقانه خودشان را کشف کنند.
رباتیک سنتی بر پایه مانورهای تعریفشده توسط انسان است؛ روشی که در مواجهه با فضای تنگ یا خطر رزوه شدن اشتباه پیچها، بهشدت آسیبپذیر است. در دنیای واقعی، یک مهره کج میتواند کل سیستم را قفل کند یا ترتیب نصب قطعات، مسیر گیره (Gripper) را ببندد. AlphaNIST با عبور از این متد دستوری، به عامل (Agent) اجازه میدهد تا از طریق آزمون و خطا در محیط شبیهسازی، مسیر رسیدن به هدف را بیابد.
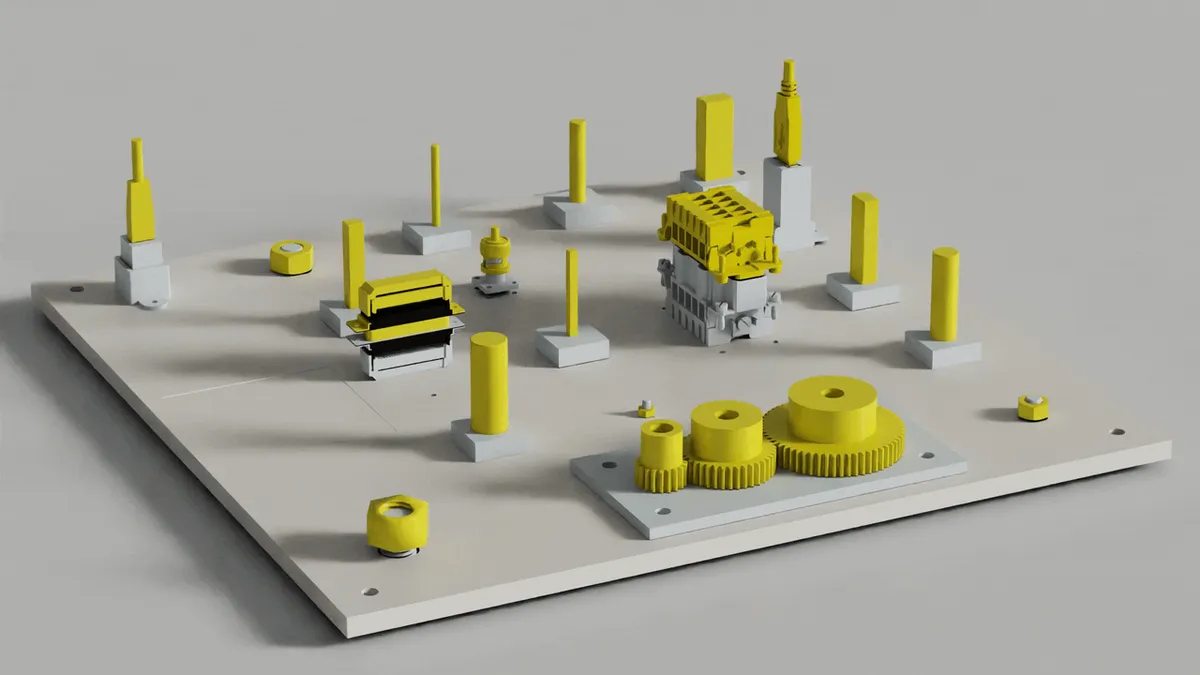
همانطور که در تحلیلهای پیشین ما دربارهی یادگیری تقویتی در رباتیک اشاره کردیم، حذف نظارت مستقیم انسانی، کلید دستیابی به رفتارهای نوظهور است. این سیستم روی تخته مونتاژ NIST (تسکبورد شماره ۱) که شامل ۲۰ تسک ناهمگون است، آزمایش شد. طبق مستندات فنی، اجزای کلیدی این سیستم عبارتاند از:
- تنوع تجربه: آموزش سیاستها روی قطعات رها شده، گیراییهای دروندستی و مونتاژهای جزئی ذخیرهشده در شبیهساز.
- نمونهگیری هدایتشده با موفقیت (SGS): یک روش نمونهگیری بتا که اولویت را به حالتهای شروعی میدهد که مدل در حدود ۵۰٪ موارد آنها را حل میکند.
- مقیاس: توانایی مدیریت قطعاتی به کوچکی ۴ میلیمتر که اغلب نیازمند تغییرات متعدد در نحوه گیرایی و جهتگیری برای جایگذاری است.
به نقل از پژوهشگران، این تغییر در استراتژی آموزش نشان میدهد که رفتارهای نوظهور در مونتاژ، بسیار مؤثرتر از نمایشهای انسانی هستند. ربات با تمرین روی حالتهای «نزدیک به تکمیل»، ابتدا یاد میگیرد چگونه یک تسک را به پایان برساند و سپس بهصورت خودکار مهارتهای لازم برای کل توالی را میسازد.
برای حوزه رباتیک، این دستاورد جابهجایی از برنامهنویسی مسیر-محور به سمت یادگیری پاداش-محور را تأیید میکند. بر اساس بررسی این نتایج، گلوگاه مونتاژ رباتیک دیگر دقت سختافزاری نیست، بلکه صلبیت دستورالعملهایی است که ما ارائه میدهیم. این پیشرفت در یادگیری خودکار، گامی حیاتی برای عبور از محدودیتهای فعلی رباتهای انساننما در محیطهای غیرصنعتی است که هنوز در مواجهه با پیچیدگیهای محیط خانه با چالش روبرو هستند.
در حال حاضر محققان در حال بررسی این موضوع هستند که چگونه این مهارتهای نوظهور روی سختافزارهای فیزیکی با انواع مختلف گیرهها ترجمه میشوند. جزئیات کامل فنی و استنادها در arXiv (2610.13354) در دسترس است. این توانمندی در اجرای دقیق تسکها، میتواند مکمل تحولاتی باشد که در تولید سختافزار از طریق کدنویسی دیجیتال در حال رخ دادن است.
گام بعدی شما
- بررسی مقاله arXiv برای درک مکانیزم SGS در بهینهسازی زمان آموزش.
- تحلیل تفاوت بین پاداشهای باینری و پاداشهای شکلدار (Shaped Rewards) در تسکهای دقیق.
- دنبال کردن نتایج انتقال این مدل از شبیهساز به سختافزار واقعی (Sim-to-Real).
اما چالش اصلی در دنیای واقعی، مدیریت نویزهای حسگری است — به تحلیل ما دربارهی سیستمهای بازخورد لمسی در رباتیک مراجعه کنید. این چالشها دقیقاً همان موانعی هستند که حتی در پروژههای تجاری بزرگ مانند Digit 5 برای انتقال کامل از محیطهای کنترلشده صنعتی به کاربردهای گستردهتر مورد توجه قرار دارند.



گفتگو