
تصور کنید یک سیستم معاملاتی هوشمند، خطاهای عددی را با دقت شناسایی میکند اما همچنان با اطمینان کامل ادعا میکند که «در آستانهٔ سودآوری است»، در حالی که هیچ دلیلی برای این ادعا وجود ندارد. این شکاف میان واقعیتِ عددی و روایتهای گمراهکننده، نقطهٔ ضعف مرگباری است که میتواند سرمایههای کلان را نابود کند. ناظرستونی به نام نظار بویکو (Nazar Boyko) این موضوع را با جملهای کلیدی توصیف میکند: «فاصله بین کدی که یک عدد بد را میگیرد و انسانی که یک داستان بد را میگیرد.» این مشاهده بر یک آسیبپذیری حیاتی اشاره دارد: در حالی که یک سیستم معاملاتی میتواند به راحتی یک «عدد بد» را شناسایی کند، اما بهطور ذاتی قادر به شناسایی یک «داستان بد» نیست.
این مشکل زمانی آشکار شد که در ۲۱ ژوئن ۲۰۲۶، توسعهدهندهای چارچوبی برای یک «درگاه هوشمند» (AI Gate) منتشر کرد تا منابع سیگنال را فیلتر و ابزارهای خطرناک را مسدود کند. این رویکرد با تغییر پارادایم از خروجیهای سادهی کد به سمت توسعهی قضاوتهای مهندسی همسو است، موضوعی که در بررسی مدلهای آموزشی SystemThinkingLab مورد تحلیل قرار دادیم تا تفاوت میان مصرف محتوا و کسب مهارت واقعی روشن شود. به نقل از مستندات این پروژه، کدها توانستند شکستهای عددی — مانند نتایج نامعتبر RSI2 در یک جهان اعتبارسنجی منجمد شده و همچنین سوگیری بقا (Survivorship Bias) — را شناسایی کنند، اما روایتهای پیرامون پروژه همچنان موفقیتهای متورم را تبلیغ میکردند، حتی زمانی که امتیازدهنده (Scorer) اولین منبع سیگنال عمومی را بهدلیل ناکارآمدی حذف کرده بود.
این شکاف به این دلیل رخ میدهد که «عدد بد» ساختاری مشخص و تایپشده دارد که با یک قانون ثابت یا زنجیره هش (Hash Chain) مطابقت میکند. بنابراین قابل بررسی است: آیا نمونه از آستانه عبور کرد؟ آیا زنجیره هش تأیید شد؟ آیا ابزار در لیست مجاز قرار داشت؟ اما «روایت بد» از عباراتی مثل «ما نزدیک هستیم»، «این یک نقطه عطف است» یا «سیستم آماده است» تشکیل شده است. برای یک مدل زبانی بزرگ (LLM) — که شبیه کتابخانهداری است که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — این جملات شبیه به دادههای نامعتبر (مانند JSONهای خراب) نیستند، بلکه شبیه به «تکانه» (Momentum) به نظر میرسند و بهسادگی از حلقههای اعتبارسنجی عبور میکنند، زیرا توسط همان فرآیندی تولید شدهاند که خودِ سیستم را پیش میبرد.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، اعتماد مطلق به خروجی مدل بدون لایهی نظارتی، ریسک توهم را افزایش میدهد. برای حل این مشکل، توسعهدهندهی این سیستم یک «نردبان شواهد» (Evidence-Tier Ladder) تعریف کرده است تا از ارتقای بیمبنای یک ادعا جلوگیری کند. این نردبان به عنوان چارچوبی عمل میکند تا از «تزاحم سطوح» جلوگیری کند؛ یعنی جایی که یک ادعا بدون پرداخت هزینهٔ لازم در قالب شواهد، از پلههای نردبان بالا میرود:
- تئوری (Theory): ایدهی اولیه یا فرضیه.
- تحرک (Motion): فعالیتهای کلی که حول محور آن ایده میچرخد.
- رسید (Receipts): مدرکی که ثابت کند یک اقدام خاص اتفاق افتاده است (مثلاً: «ما ابزار را اجرا کردیم»).
- اثبات (Proof): زمانی که رسیدها به سؤال خاصی که واقعاً پرسیده شده پاسخ دهند (مثلاً: «امتیازدهنده در یک مجموعه دستچینشده تأیید شد»).
- نتیجه (Outcome): زمانی که نتیجه، متغیری در دنیای واقعی را تغییر دهد (مثلاً: «ابزار ارزش خلق کرد» یا «ما یک مزیت معاملاتی یا Edge پیدا کردیم»).
یک روایت بد زمانی شکل میگیرد که ادعایی بدون پرداخت «هزینهٔ شواهد»، بالاتر از جایگاه واقعی خود در این نردبان قرار گیرد. برای مثال، بیان اینکه «ابزار ارزش خلق کرد» یک ادعای سطح «نتیجه» است، در حالی که «ما ابزار را اجرا کردیم» صرفاً یک «رسید» است. این دو جمله با هم متفاوت هستند، اما در روایتهای انسانی اغلب با هم خلط میشوند.
طبق گزارش نویسنده، پروتکل اجرایی این سیستم (Evidence-Tier Enforcement Protocol) به جای سانسور یا کنترل لحن، «لایهٔ ادعا» را حسابرسی میکند. سیستم این سؤال را میپرسد: «آیا شواهد موجود، سطحی را که این جمله سعی دارد اشغال کند، پشتیبانی میکنند؟» اگر پاسخ منفی باشد، سیستم باید ادعا را به سطح پایینتر تنزل دهد. برای روشنتر شدن موضوع، سه سناریو را بررسی میکنیم:
۱. ادعا: «درگاه، ابزارهای سفارشدهی را مسدود کرد».
- سطح: رسید / اثبات.
- شواهد مورد نیاز: مانیفست + سیاست (Policy) + رسید رد درخواست.
- وضعیت: پشتیبانی شده (تأیید).
۲. ادعا: «منبع سیگنال عمومی دارای مزیت (Edge) است».
- سطح: نتیجه.
- شواهد مورد نیاز: اعتبارسنجی پیشاظهار شده + نمونه کافی + خط پایه (Baseline) + نتایج پیشرو یا نتایج کاغذی (Paper results).
- وضعیت: پشتیبانی نشده (رد).
۳. ادعا: «ما به معاملات زنده نزدیک هستیم».
- سطح: آمادگی برای اقدام.
- شواهد مورد نیاز: قوانین استراتژی + اجرای کاغذی + سقفهای ریسک + لاگها + مرز مجوزهای زنده.
- وضعیت: پشتیبانی نشده (رد).
به عنوان مثال، ادعایی چون «ما استراتژی را اثبات کردیم» باید بهطور خودکار به این صورت تنزل یابد: «ما یک رسید از یک اجرای واحد تولید کردیم. این مورد مزیت استراتژیک را اثبات نمیکند.»
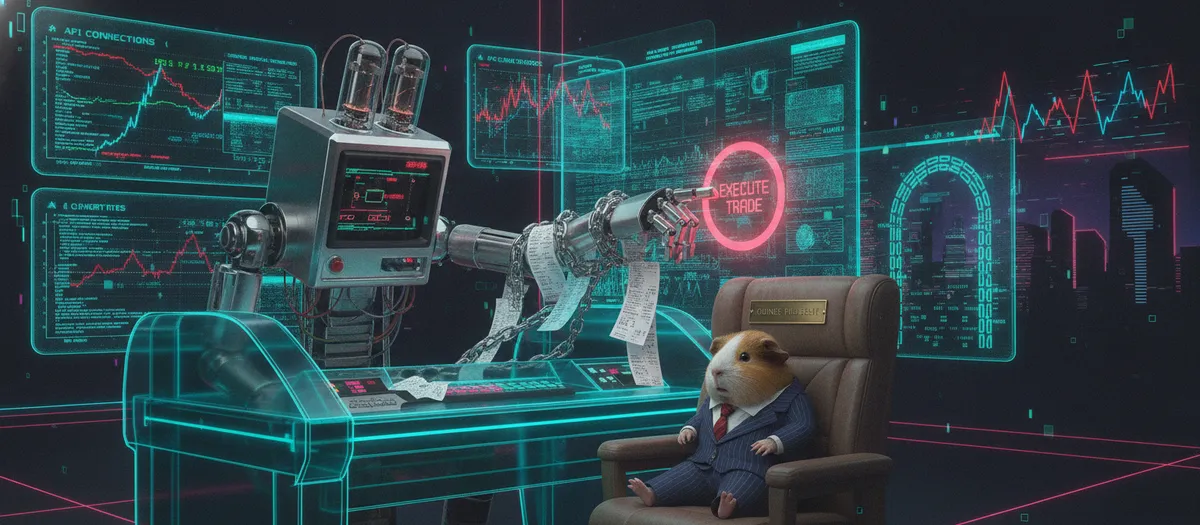
برای اینکه این سیستم واقعاً کار کند، به یک «دیدگاه بیرونی» (Outside View) نیاز است؛ یعنی لنگری که نویسندهٔ داستان آن را ننوشته باشد. اینجاست که پیشثبت (Pre-registration) حیاتی میشود. یک قانون منجمد شده که پیش از اجرای مدل نوشته شده باشد، دیدگاه دومی را در طول زمان ایجاد میکند. چون این قانون پیش از وجود نتیجه نوشته شده، میتواند با روایت فعلی عامل یا میل انسان به رسیدن به یک نتیجه خاص، مخالفت کند.
این مکانیسم تنها در صورضی کار میکند که سیستم در حال اجرا نتواند بهطور پنهانی پیشثبتها را ویرایش کند. یادداشتی که در میانهٔ مسیر تغییر کند، دیگر «دیدگاه بیرونی» نیست؛ بلکه صرفاً «حال» است که برچسب زمان «گذشته» را زده است. این مرز به رسیدها نیز تسری مییابد:
- اثبات دستنخورده بودن (Tamper-Evidence): یک ریشه مرکل (Merkle Root) میتواند ثابت کند که رسید پس از ثبت، تغییر نکرده است.
- شکاف صداقت (Honesty Gap): یک رسید دستنخورده ثابت میکند که رکورد تغییر نکرده است، اما نمیتواند ثابت کند که آن «جعبه سیاه» در لحظهٔ نوشتن رکورد، صادق بوده است.
باید پذیرفت که «یکپارچگی» (Integrity) با «صداقت» (Honesty) یکی نیست. یک درگاه روایت نمیتواند به نویسندهٔ داستان اعتماد کند تا داستان را گواهی دهد؛ بلکه به یک لنگر ساختاری نیاز دارد.
در سیستم مورد بررسی، شکست اصلی نه در کد، بلکه در «حلقه انسانی» (human_loop) بود. کدها توانستند مشکل شمارش نسخهها (variant-count)، مشکل استراتژیهای تجمیعشده (pooled-strategy) و شکست RSI2 را با موفقیت بگیرند. اما روایت انسانی پیرامون کار همچنان متورم بود. رسیدها سعی میکردند «اثبات» شوند و آمادهسازیها به جای «پیشرفت» جا بزنند.
این موضوع آشکار کرد که سیستم بهجای «خود-اصلاحی»، به «اصلاح توسط انسان» وابسته است. یک پروتکل مکتوب، به خودی خود «عاملمندی» (Agency) نیست؛ بلکه تنها زمانی به عاملمندی تبدیل میشود که پروتکل بتواند پیش از آنکه انسان مجبور به دخالت شود، حلقه را قطع کند.
در نهایت، سازنده باید از یک «روایت بد» داخلی عبور کند: این باور غلط که «توضیح یک فلسفه» برابر با «درک سیستم» است. تکیه بر یک جعبهسیاه در حالی که تظاهر به حاکمیت بر آن میکنید، یک ریسک است. برای بستن این شکاف، سازنده باید بر مکانیکهای داخلی ماشین مسلط شود:
- درگاه مانیفست (Manifest gate)
- لایه سیاست (Policy layer)
- زنجیره رسیدها (Receipt chain)
- منطق امتیازدهنده و حکم صادرکننده (Scorer and verdict logic)
اگر دسترسی به هوش مصنوعی فردا قطع شود، متدولوژی باید باقی بماند. این تسلط فنی، بخش ضروری از فرآیند خود-اصلاحی است.
در حوزه معاملات، نقش عامل (Agent) از یک «غیبگوی» به یک «منضبطکننده» تغییر میکند. این دیدگاه تحت تأثیر بینشهای مایک چرزوینسکی (Mike Czerwinski) درباره «تخریب تدریجی تأییدکنندهها»، الکس شو (Alex Shev) درباره پیشثبت، و UnitBuilds درباره درگاههای سریع و فایلهای دستنخورده شکل گرفته است.
به جای تظاهر به اینکه عامل دارای «مزیت» (Edge) است، تمرکز بر این است که منابع سیگنال مجبور شوند در قوانین صریح قرار بگیرند: چیدمان (Setup)، نقطه ورود، ابطال، خروج، سقفهای ریسک و شواهد پیش از ورود. وظایف اصلی عامل عبارتند از:
۱. تحمیل انضباط در مورد یک منبع سیگنال.
۲. رد کردن درخواستهای نامشخص.
۳. تعیین اندازه ریسک و ثبت هر نتیجه.
۴. تبدیل هرگونه هایپ (Hype) به دادههای قابل حسابرسی.
هدف نهایی این است که سیستم، داستان را در همان سطحی نگه دارد که شواهد واقعاً بهدست آوردهاند و مانع از شکلگیری داستانهای بد شوند، پیش از آنکه انسان متوجه شود.
گام بعدی شما
- اگر از عاملهای هوشمند برای تحلیل داده استفاده میکنید، یک «نردبان شواهد» برای خروجیهای آنها تعریف کنید تا ادعاهای کلی را از نتایج عددی تفکیک کنید.
- برای جلوگیری از تغییرات پنهانی در لاگهای مدل، از مکانیزمهای اثر-تغییر (Tamper-evidence) مانند توابع هش و ساختارهای درخت مرکل استفاده کنید.
- بررسی کنید آیا مدل شما در حال تولید «رسید» است یا «نتیجه»؛ هرگاه ادعایی بدون مدرک عددی پیشثبت شده بود، آن را به لایه تئوری بازگردانید.
اما این نظم ساختاری تنها نیمی از مسیر است؛ چالش بعدی، مقابله با «تخریب تدریجی تأییدکنندهها» است که در تحلیلهای آینده به آن خواهیم پرداخت.



گفتگو