تصور کنید یک راهنمای سفر شما را به رستورانی بفرستد که سال گذشته تعطیل شده است؛ در این لحظه تمام تکنولوژیهای پیشرفتهی پشت آن برنامه بیفایده میشوند. برای حل این مشکل، Citysense یک دیوار سخت بین دادههای واقعی و متنهای تولیدی کشیده است تا هوش مصنوعی هرگز یک «جواهر پنهان» خیالی را اختراع نکند.
بیشتر مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — اولویت را به «محتمل بودن» میدهند تا «حقیقت». آنها اغلب جزئیات را برای حفظ لحنی روان، توهم میزنند (Hallucinate). این شکاف بین یک پاسخ «محتمل» و یک پاسخ «صحیح»، جایی است که اکثر برنامهریزهای سفر مبتنی بر هوش مصنوعی شکست میخورند. یک هوش مصنوعی ممکن است با اطمینان کامل، بال موزهای را پیشنهاد دهد که برای بازسازی بسته شده است یا خط ترامی را معرفی کند که حتی پیش از رزرو پرواز شما، از مدار خارج شده است. Citysense با تغییر نقش هوش مصنوعی از «منبع دانش» به «کیوریتور یا گزینشگر»، این مشکل را حل کرده است.
معماری دو لایهای
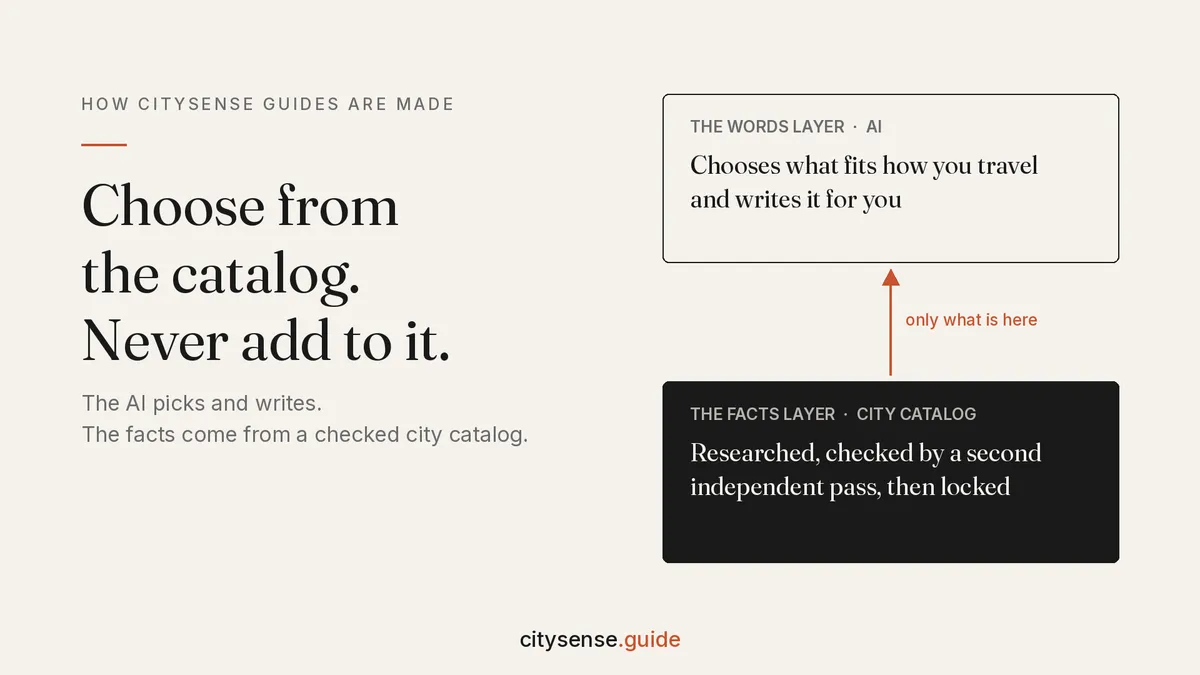
این سامانه بر اساس دو لایهی مجزا عمل میکند. لایهی اول، لایهی واقعیت (Facts Layer) است؛ کاتالوگی پیشساخته برای هر شهر که شامل محلهها، نقاط دیدنی و کدهای محلی تأیید شده است. این لایه شامل جزئیات دقیقی است درباره اینکه مردم شهر چگونه غذا میخورند، روشهای تردد چگونه است، عبارات ضروری چه هستند و هنجارهای فرهنگی چیست؛ از نحوه سلام و احوالپرسی و ساعات صرف غذا گرفته تا پوشش مناسب برای بازدید از کلیساها. این رویکرد یادآور تلاشهایی است که در آن ترکیب دادههای مکانی با عاملهای هوش مصنوعی برای رفع نقاط کور محیطی مدلها به کار گرفته شد.
لایهی دوم، لایهی کلمات (Words Layer) است. در اینجا هوش مصنوعی کاتالوگ و ترجیحات کاربر را میخواند تا تصمیم بگیرد چه چیزی را و چگونه ارائه دهد. مدل تحت یک قانون ساده و سختگیرانه عمل میکند: هوش مصنوعی باید فقط از کاتالوگ انتخاب کند و هرگز نباید چیزی به آن اضافه کند.
ساختار سختگیرانهی واقعیتها
به نقل از گزارش وبسایت dev.to در ۸ اکتبر ۲۰۲۶، لایهی واقعیت از طریق یک بازرسی دو مرحلهای توسط هوش مصنوعی ساخته میشود:
- پیشنویس: یک نشست هوش مصنوعی کاتالوگ را میسازد و برای هر ادعای نامدار یا تاریخدار، الزاماً یک منبع ذکر شده (Cited Source) ارائه میدهد.
- حسابرسی: یک نشست مستقل دیگر، پیشنویس را از صفر بازرسی میکند. این نشست هیچ دسترسی به منابع، استدلالها یا نتایج نشست اول ندارد و هر ادعا را بهطور کاملاً مستقل جستوجو میکند. این متدولوژی تأیید میکند که بازرسی دقیق خروجیها میتواند بسیار مؤثرتر از مهندسی پیچیده پرامپت برای تضمین صحت باشد.
- تأیید نهایی: اصلاحات به کاتالوگ بازمیگردند و هر موردی که نیاز به قضاوت داشته باشد، پیش از قفل شدن نهایی کاتالوگ، به یک ویراستار انسانی ارجاع میشود.
- مراجع مشترک: واقعیتهایی که در شهرهای مختلف تکرار میشوند (مانند قوانین کلی ورود بازدیدکنندگان)، در یک مرجع مشترک ذخیره میشوند. این کار مانع از آن میشود که یک جملهی قدیمی بهطور بیصدا در پنج راهنمای مختلف کپی شود.
همانطور که در تحلیلهای قبلی ما دربارهی مبنیسازی (Grounding) مدلها اشاره کردیم، محدود کردن فضای پاسخدهی مدل، تنها راه مقابله با توهمات در کاربردهای حساس است.
پایداری از طریق «تیپبندی»
برای جلوگیری از قدیمی شدن دادهها، Citysense بهجای آدرسهای دقیق، «تیپ» مکانها را پیشنهاد میکند. راهنمایی که نام یک بار خاص را میبرد، به محض اینکه آن بار تغییر مالکیت دهد یا بسته شود، منقضی میشود. در مقابل، این سیستم به «یک تراطور خانوادگی نزدیک بازار قدیمی»، «یک تالار بازار سرپوشیده» یا «محلهای که پیاده قابل پیمایش است» اشاره میکند.
با گره زدن توصیهها به نقاط شهری که ثابت میمانند و تیپهای مکانی که ماهیتشان تغییر نمیکند، راهنما در طول هفتهی واقعی سفر کاربر، همچنان کاربردی باقی میماند.
شخصیسازی در برابر حقیقتیابی
این رویکرد دو محصول متمایز ایجاد میکند:
۱. راهنمای شهری: یک متن استاندارد که هر بازدیدکنندهای به آن نیاز دارد، مستقیماً از کاتالوگ استخراج میشود و برای همه یکسان است.
۲. راهنمای شخصیسازی شده: نسخهای که بر اساس ۵ دقیقه پرسش و پاسخ ساخته میشود. در اینجا هوش مصنوعی از واقعیتهای تأییدشده استفاده میکند تا آنها را با سرعت سفر و علایق خاص کاربر تطبیق دهد.
برای کاربر، این یعنی هوش مصنوعی شخصیسازی را مدیریت میکند — مثلاً تنظیم برنامه برای یک شکمپرست شبگرد در مقابل یک علاقهمند به تاریخ که صبح زود بیدار میشود و میخواهد هستهی باستانی شهر را در ابتدای مسیر داشته باشد — بدون اینکه ریسک اختراع موزههای خیالی وجود داشته باشد.
با اولویت دادن به صحت بر خلاقیت، Citysense پذیرفته است که سرعت گسترش به شهرهای جدید کندتر شود. این سبک و سنگین کردن (Trade-off) تضمین میکند که نقش هوش مصنوعی محدود به تطبیق و قاببندی باشد، در حالی که دادههای زیرین به عنوان یک مرجع ایستا و بررسیشده باقی بمانند.
این مکانیسم نقش هوش مصنوعی را از یک «موتور دانش» به یک «لایه رابط کاربری» (UI Layer) برای یک پایگاهداده ساختاریافته تبدیل میکند. این موضوع ثابت میکند که استقرار هوش مصنوعی در یک محیط قفلشده و بازرسیشده، برای اپلیکیشنهای کاربردی (Utility-based)، بسیار ارزشمندتر از خلاقیت خام مدل است.
گام بعدی شما
- اگر در حال توسعه اپلیکیشنهای کاربردی هستید، مدل «تفکیک لایهی داده از لایهی تولید متن» را جایگزین RAGهای ساده کنید.
- برای بررسی کیفیت این تفکیک، صفحات رایگان راهنمای شهرها را در citysense.guide تست کنید.
- روی استفاده از «تیپهای مکانی» بهجای «آدرسهای سخت» برای افزایش طول عمر محتوا تمرکز کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو