تصور کنید پروژهای که بهطور معمول سالها تلاش مهندسان ارشد را میطلبد، تنها در ۳۰ روز به نتیجه برسد. این اتفاق برای درایور واحد پردازش گرافیکی (GPU) مدل M4 در مکمینی و مکبوک نئو رخ داده است. در دنیای مهندسی سیستم، عبارت «سالها مهندسی دستی» خط زمانی معمول برای عرضه یک درایور GPU کاملاً کاربردی است، اما یک تیم دو نفره همین حالا این مسیر را در حدود یک ماه طی کرده است.
به نقل از گزارش منتشر شده در ۱۵ سپتامبر ۲۰۲۶، توسعهدهندهای به نام کودی هو (Cody Ho) و همکارش نیکلاس، با بهرهگیری از عاملهای هوش مصنوعی (AI Agents) — سیستمهایی که میتوانند بهطور مستقل برنامهریزی کنند و ابزارها را به کار بگیرند — سختافزار اختصاصی اپل را مهندسی معکوس کردند تا یک درایور استاندارد OpenGL ES 3.0 پیادهسازی کنند.
ساخت درایور GPU یکی از دشوارترین کارهای برنامهنویسی سیستم است. این کار نیازمند درک تعامل پیچیده میان هسته سیستمعامل، سفتافزار (Firmware) و سختافزار است. برای سیلیکون اپل، این موضوع بهدلیل وابستگی GPU مدل AGX به یک سیستمعامل بیدرنگ اختصاصی به نام RTKit پیچیدهتر میشود؛ RTKit شبیه به یک نگهبان سختگیر است که هر دسترسی بین سیستمعامل و سختافزار را کنترل میکند و به عنوان یک لایه واسط عمل میکند.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، دسترسی به لایههای زیرین سختافزار همیشه چالشبرانگیز بوده است. اکثر توسعهدهندگانی که برای چنین کاری تلاش میکنند، ماهها وقت صرف نقشهبرداری از رابطهای برنامهنویسی سفتافزار (Firmware ABI) میکنند. اما تیم هو با استفاده از یک هایپروایزر (Hypervisor) برای ثبت ردپای زنده سختافزار و تغذیه این دادهها به عاملهای هوش مصنوعی، این مسیر طولانی و خستهکننده را به چند هفته تست و اصلاح تبدیل کردند. این رویکرد یک تلاش چندساله را به چند هفته پرامپتنویسی تکرار شونده و آزمایش تبدیل کرد.
معماری AGX و جداسازی لایهها
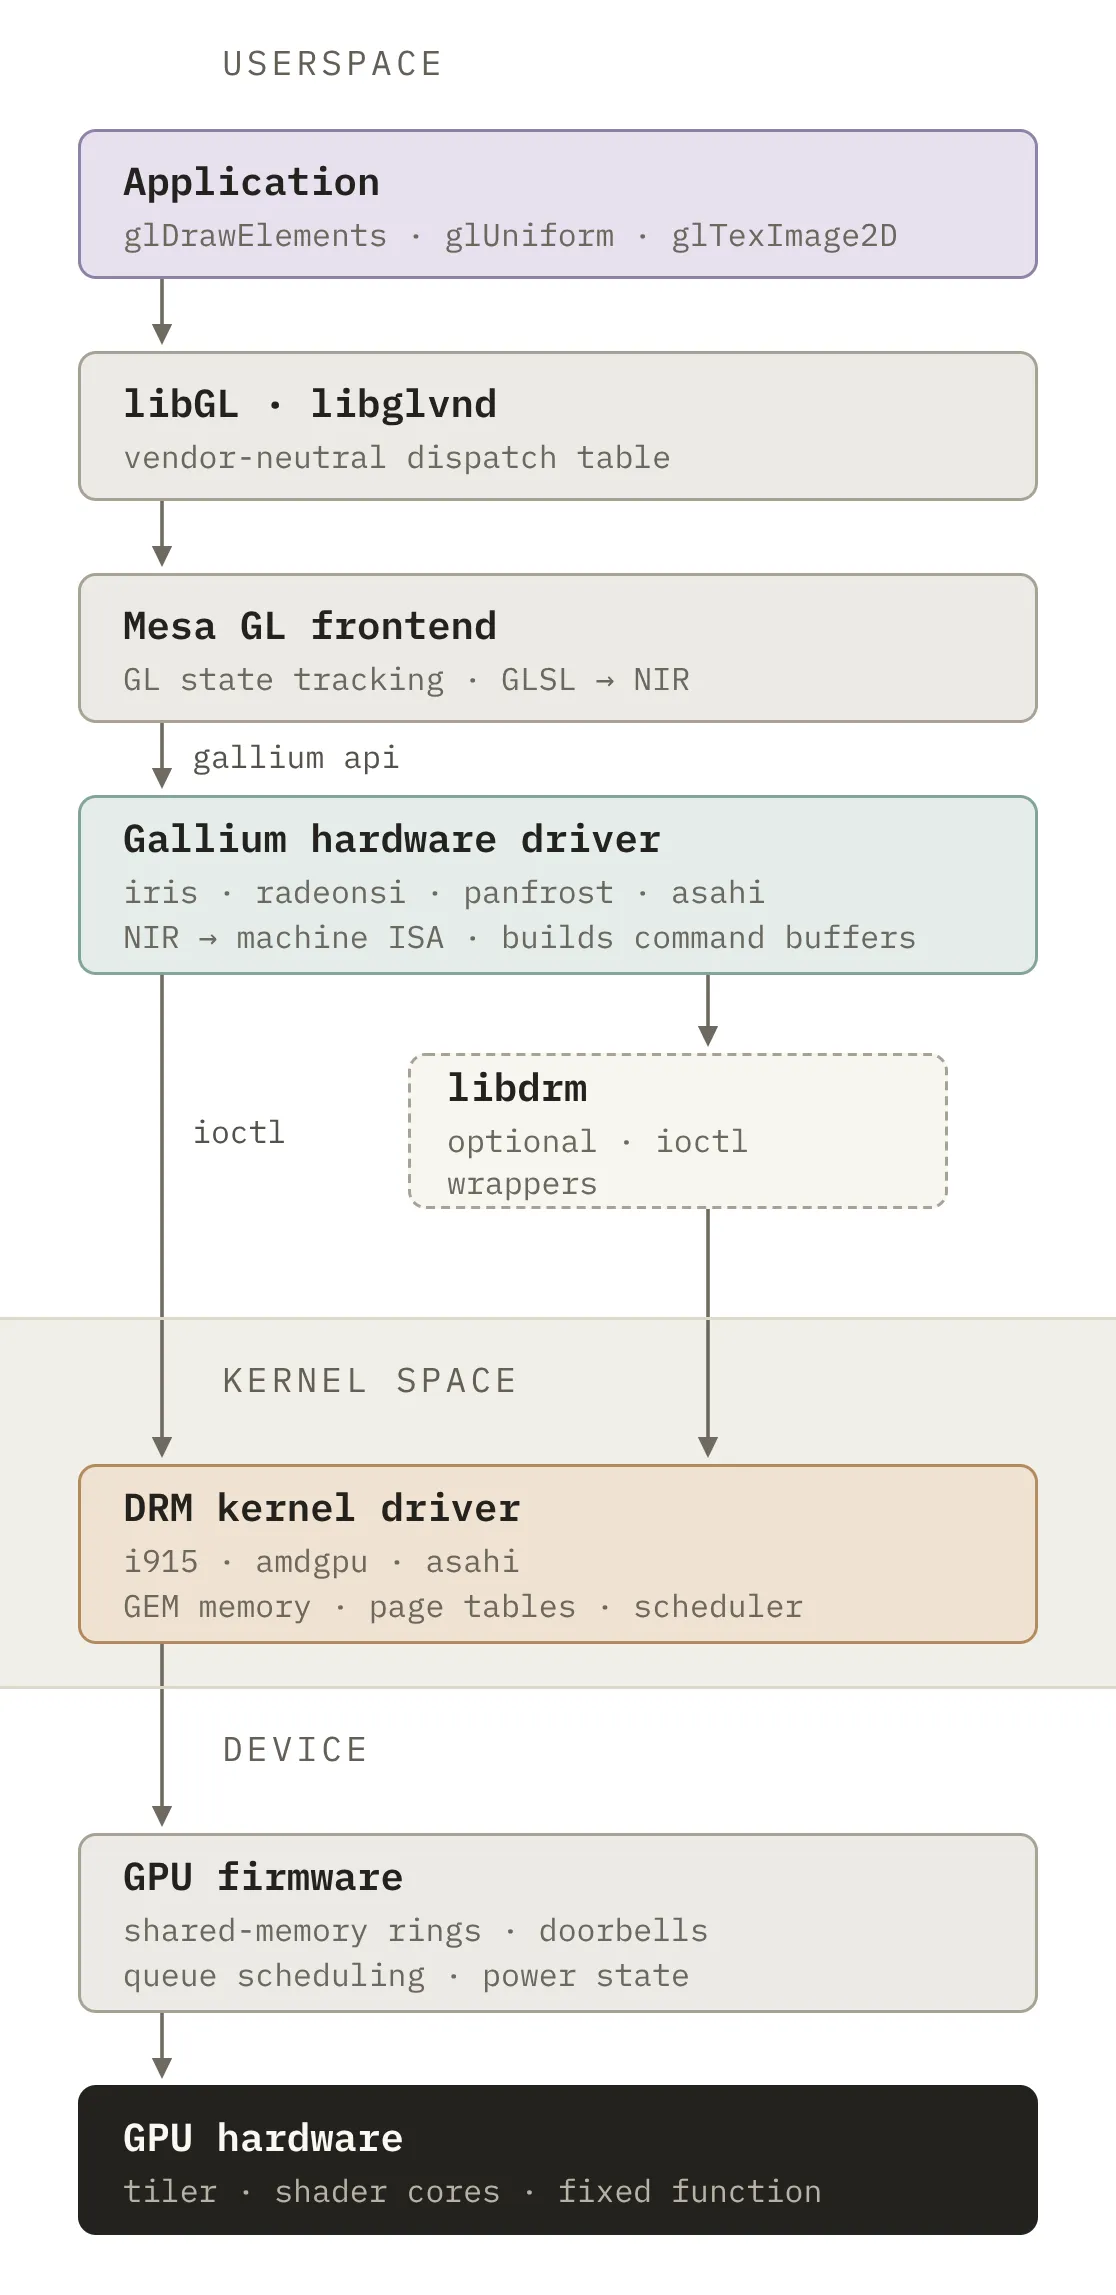
درایورهای مدرن GPU به دو بخش متمایز تقسیم میشوند: فضای هسته (Kernel Space) و فضای کاربر (User Space). هسته مسئول ارتباط با سفتافزار، تخصیص بافرها و مدیریت زمانبندی (Scheduling) است. در این لایه، محتوای واقعی بافرها برای برنامهنویس نامشخص و کدر (Opaque) است.
فضای کاربر جایی است که منطق اصلی قرار دارد. این بخش مسئول درک نحوه عملکرد GPU و پر کردن آن بافرها با دادههای لازم است. برای تراشههای M4 و A18 Pro، این کار شامل تعامل با یک رندرر کاشیمحور (Tile-based Deferred Renderer) است که بهطور خاص برای چارچوب اختصاصی Metal اپل طراحی شده است. این بهینهسازیهای سختافزاری در معماری اپل همواره مورد توجه بوده است؛ برای مثال در بررسیهای پیشین ما روی تراشه M2، مشاهده شد که واحد ANE در محاسبات ماتریسی حتی از GPU نیز پیشی میگیرد.
تیم برای رعایت استانداردهای «اتاق پاک» (Clean Room) و جلوگیری از کپیبرداری مستقیم، از بررسی کدهای باینری اپل پرهیز کرد. آنها بهجای آن، بر ردپاهای سختافزاری استخراج شده از هایپروایزر و شیدرهایی (Shaders) که خودشان ساخته بودند تکیه کردند. در مواردی که استفاده از فایلهای باینری (Blobs) اپل ضروری بود، آنها با این فایلها به عنوان اشیاء کدر برخورد کردند و از یکی از دوستانشان خواستند تا مستنداتی درباره آنها بنویسد تا تیم بتواند منطق برنامه را بهصورت کورکورانه پیادهسازی کند تا زمانی که کد در عمل کار کند.
شکستن رمز فضای هسته
اولین مانع، رابط سفتافزار (Firmware ABI) بود که هو آن را مجموعهای «آزاردهنده» از ساختارهای حافظه مشترک (Shared Memory Structs) توصیف کرد. در سیلیکون اپل، درایور هسته مستقیماً با سختافزار حرف نمیزند، بلکه با سفتافزار RTKit ارتباط میگیرد. اپل در واقع یک درایور هسته معمولی را به دو نیمه تقسیم کرده است؛ یک نیمه در سفتافزار AGX و نیمه دیگر در هسته میزبان قرار دارد و این دو از طریق ساختارهای حافظه مشترک با هم ارتباط برقرار میکنند.
این ساختارها بهویژه دشوار هستند زیرا فیلدهای متعلق به سفتافزار (که هرگز نباید تغییر کنند) با فیلدهای تحت کنترل میزبان در هم تنیده شدهاند. رابط سفتافزار A18 Pro بهطور قابل توجهی پیچیدهتر از نسخههای M1 و M2 است؛ بهطوری که تعداد ساختارهای آن ۱.۵ برابر و اشارهگرهایش ۲ برابر شده و فرآیند ارسال دستورات (Work Submission) بسیار پیچیدهتر شده است.
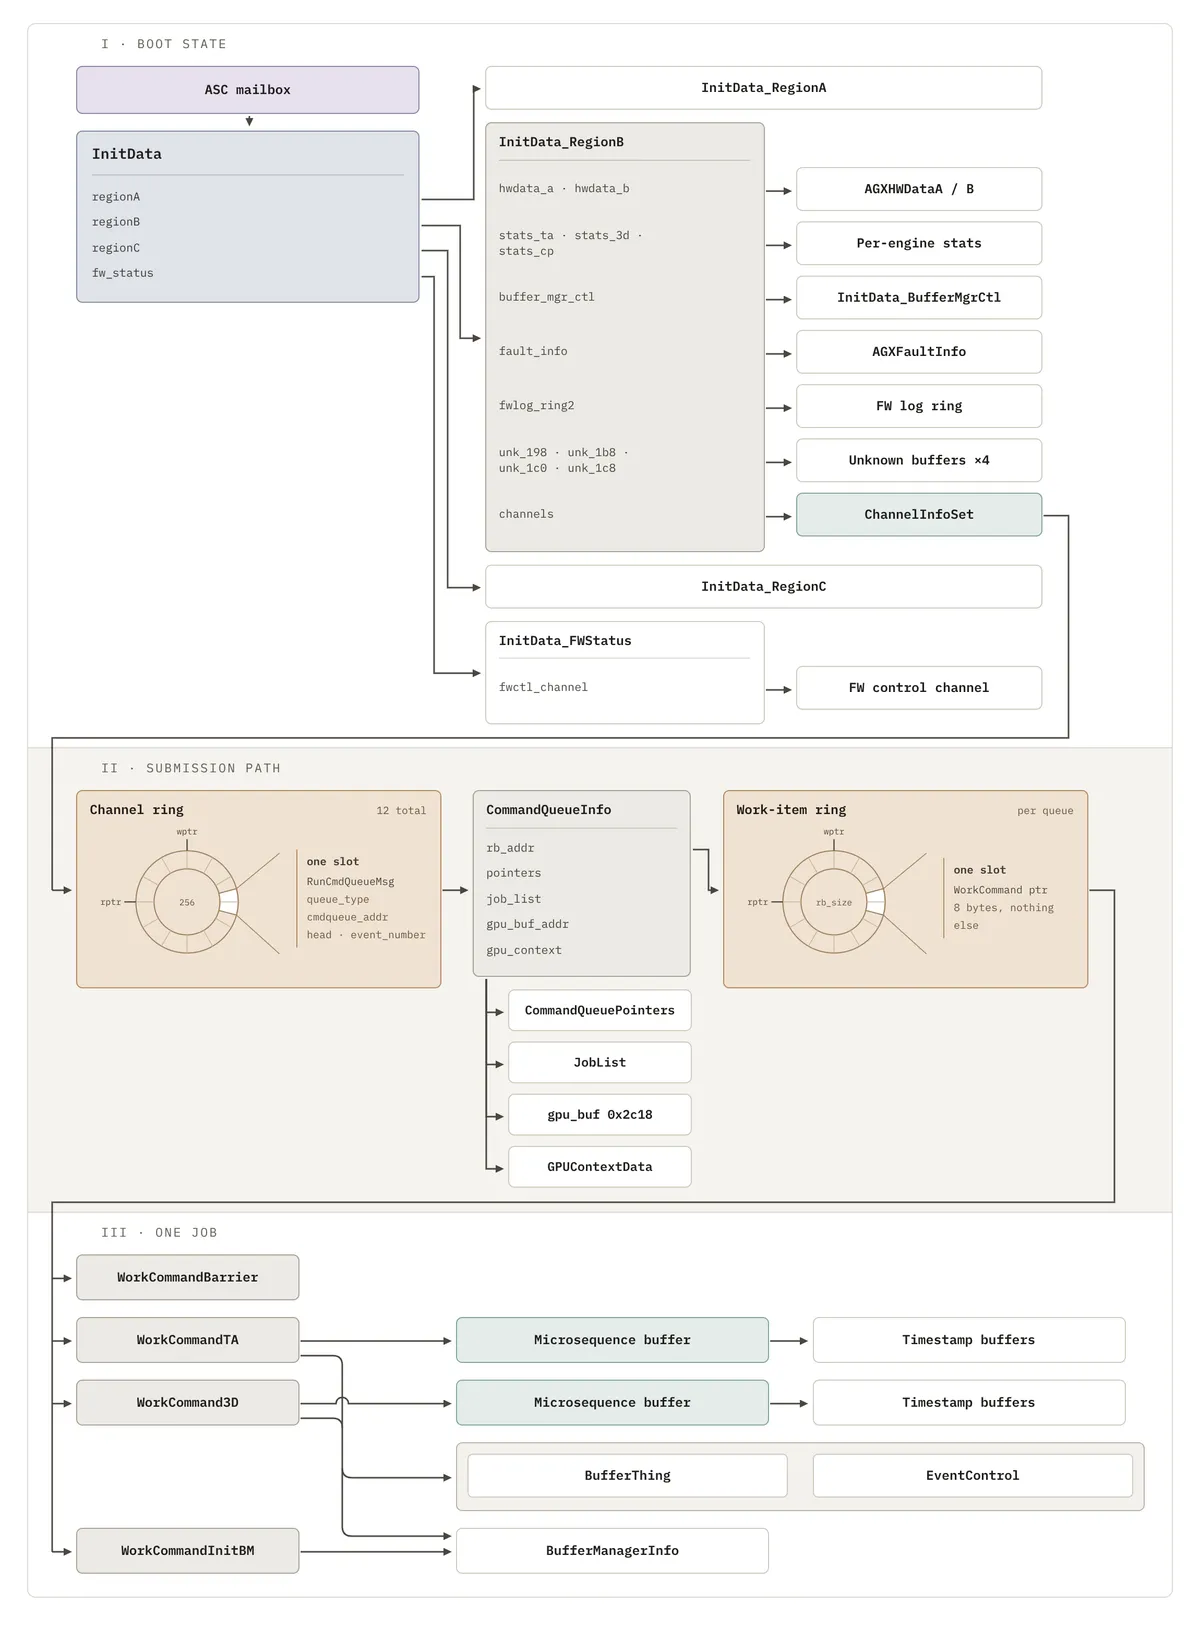
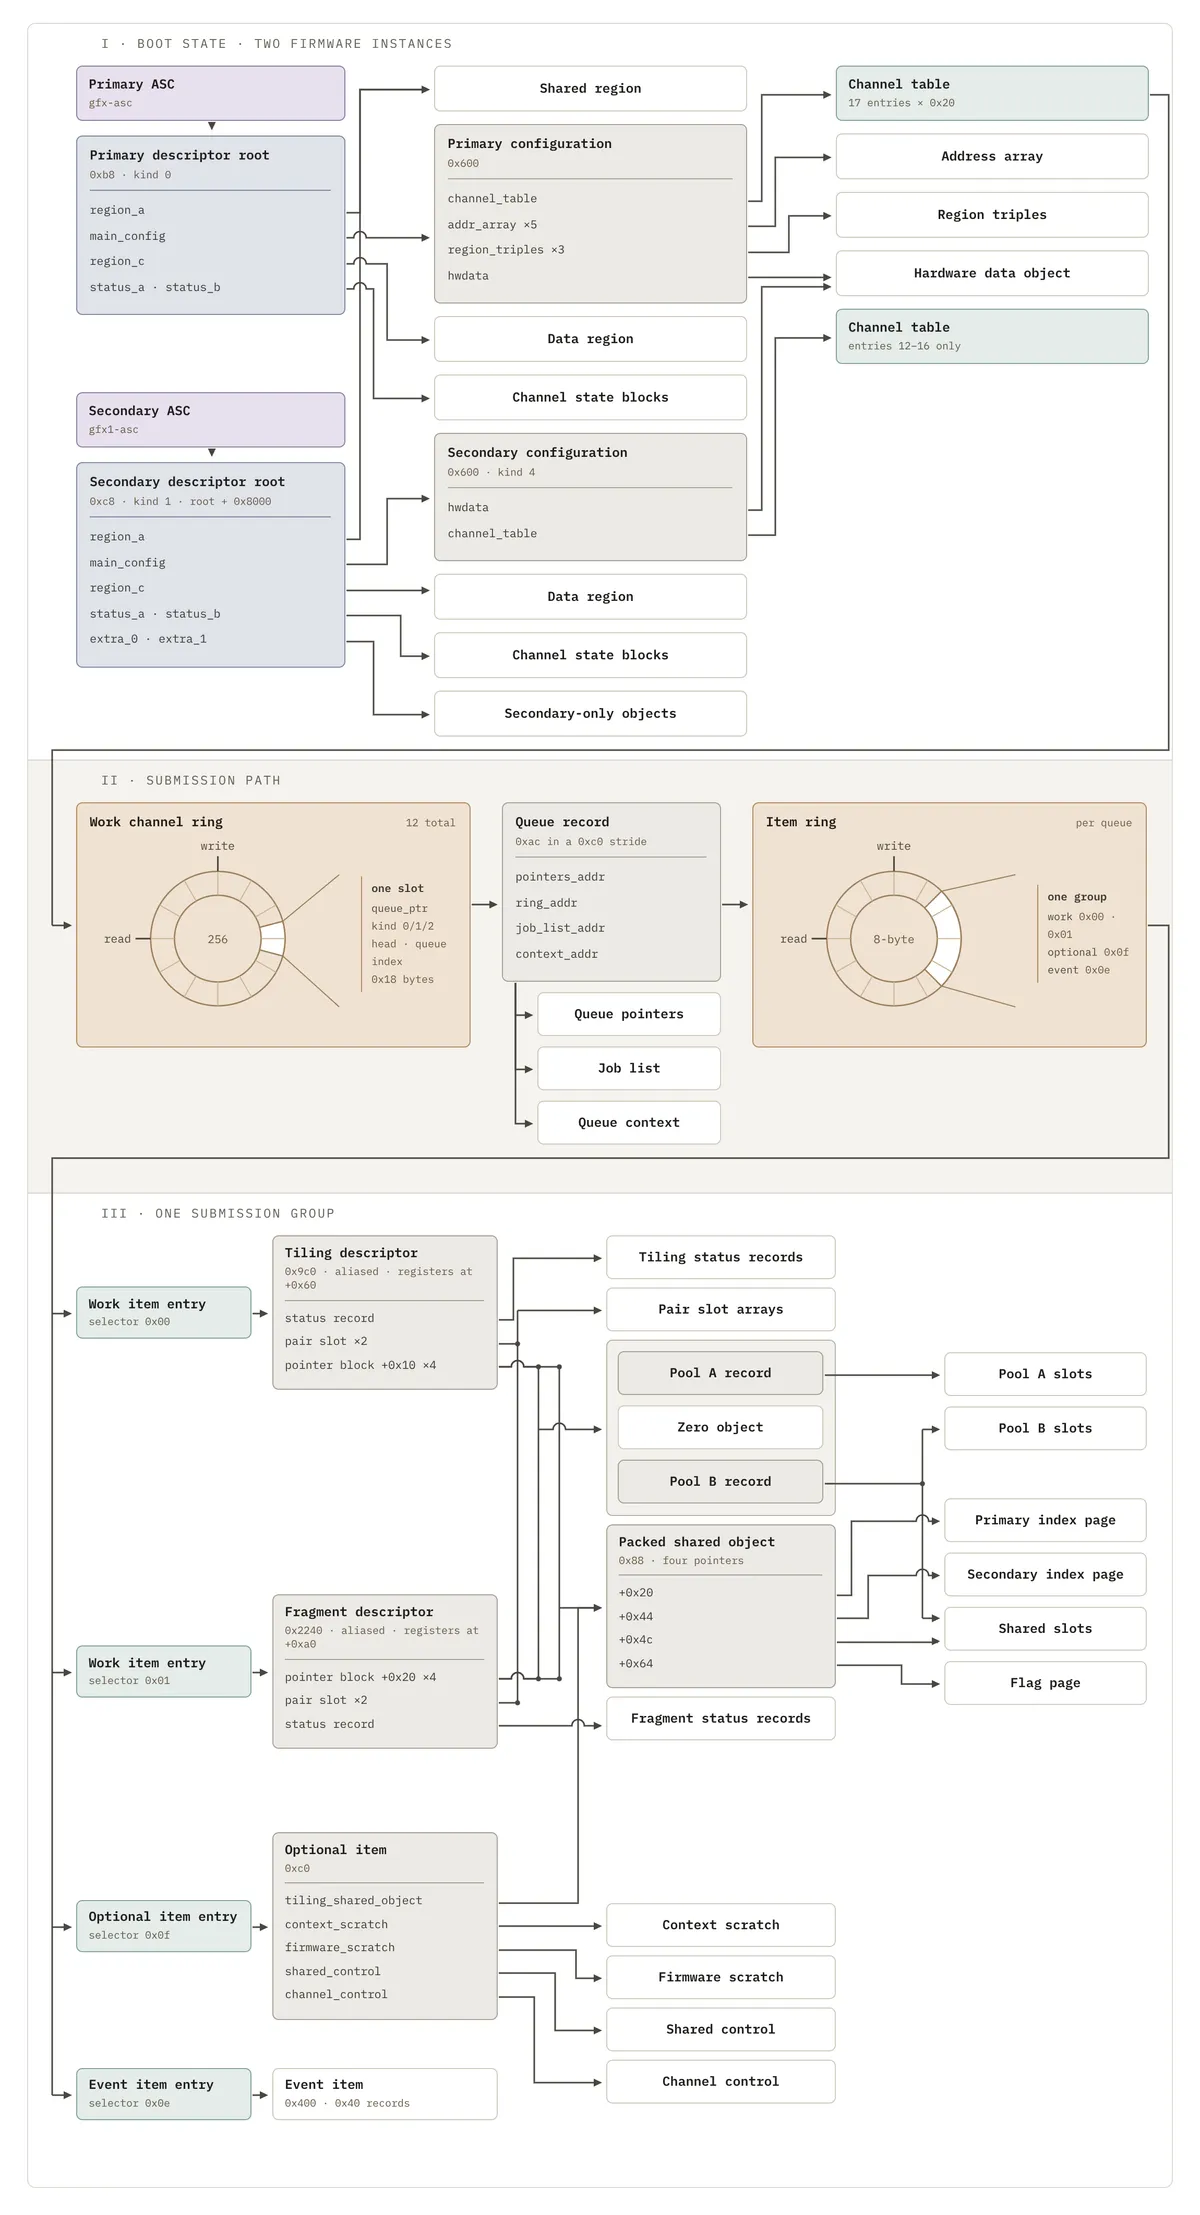
برای حل این مشکل، هو از Codex (با قدرت GPT-5.6 Sol و GPT-6 Astra) استفاده کرد تا استراتژی «ثبت و بازپخش» (Capture and Replay) را اجرا کند. عامل هوش مصنوعی مراحل زیر را طی میکرد:
- ثبت وضعیت حافظه GPU در یک لحظه خاص (یک رویداد «Kick»).
- بازپخش آن وضعیت پس از ریبوت برای بررسی اینکه آیا خروجی تغییر کرده است یا خیر.
- کاهش تدریجی دادههای بازپخششده تا زمانی که عامل بتواند اشیاء را از ابتدا در کد بازسازی کند.
این فرآیند در بارهای کاری محاسباتی (Compute) به بنبست رسید. در مسیرهای معمولی رابط گرافیکی (GUI)، کارهای محاسباتی تنها پس از حجم زیادی از کارهای رندرینگ رخ میدهند. این موضوع منجر به ثبت دادههایی شد که حجم آنها به ۳۳۶ مگابایت میرسید و بازپخش آنها غیرممکن بود. تیم این مشکل را با روشهای زیر حل کرد:
- بوت کردن سیستم در حالت تککاربره (Single-user mode) برای غیرفعال کردن GUI و حذف کارهای رندرینگ.
- نصب یک LaunchDaemon برای اجرای فوری برنامه در لحظهای که Metal در دسترس قرار میگیرد.
- اجرای یک برنامه Metal بسیار کوچک و صرفاً محاسباتی برای ثبت یک ردپای حداقلی.
در عرض چند روز، هوش مصنوعی مسیر محاسباتی را فعال کرد. تبدیل نمونه اولیه پایتونی به یک درایور کامل لینوکس تنها سه روز زمان برد. این کار شامل بازنویسی drm-shim به زبان Rust برای ایجاد یک درایور همگام (Synchronous)، بازسازی فرانت-اند برای تبدیل آن به حالت ناهمگام (Asynchronous) و پیادهسازی ارسال دستهای دستورات بود.
حل چالش رندرهای جزئی
یکی از سختترین بخشهای فنی، مدیریت «رندرهای جزئی» (Partial Renders) بود. این اتفاق زمانی میافتد که بافر вершин کاشی (TVB) برای ذخیره هندسه فعلی کوچک باشد (یعنی تعداد مثلثها برای رسم بیش از حد زیاد است).
در این حالت، درایور باید دو گزینه را پشتیبانی کند:
- افزایش اندازه TVB.
- انجام رندر جزئی: رندر کردن بخشی از هندسه، بارگذاری مجدد بافر با مثلثهای باقیمانده و سپس اتمام رندر.
این کار در واقع نیازمند اضافه کردن منطق «ذخیره و ادامه» (Save and Resume) به درایور GPU است. هو از هوش مصنوعی خواست تا شیدرهای Metal را طوری تغییر دهد که هزاران مثلث را روی یک کاشی متمرکز کنند تا عمداً رندرهای جزئی رخ دهد. با بازپخش این تراکنشهای خاص، عامل هوش مصنوعی منطق لازم برای پایداری درایور تحت بارهای سنگین را آموخت.
پیشرفت در فضای کاربر
در حالی که هسته با سفتافزار تعامل دارد، درایور فضای کاربر باید معماری مجموعه دستورالعملهای (ISA) گرافیک را بفهمد. ISA در A18 Pro اساساً با M1/M2 متفاوت است و فرمتهای توصیفگر (Descriptor) و ISA جدیدی دارد.
تیم دو رویکرد متفاوت را در اینجا امتحان کرد:
- کودی هو بر مهندسی معکوس خالص سختافزار تمرکز کرد و مشخصات فنی را برای پیادهسازی توسط هوش مصنوعی نوشت. او زمان خود را بهجای نوشتن کدهای Mesa، صرف نوشتن آزمایشهای سختافزاری کرد.
- نیکلاس رویکرد «اول Mesa» را پیش گرفت و پیادهسازی را در کتابخانه Mesa (کتابخانه گرافیکی متنباز) پیش برد و تنها زمانی مهندسی معکوس کرد که به ویژگی خاصی نیاز داشت.
رویکرد نیکلاس سریعتر بود. هو اشاره کرد که عاملهای هوش مصنوعی گاهی «سختگیر» (Pedantic) میشوند و در جزئیات بیاهمیت غرق میشوند تا به کمالگرایی برسند. با متمرکز کردن عامل روی هدف نهایی (ساخت Mesa)، سرعت پیشرفت افزایش یافت.
کشفیات سختافزاری
تیم با دستکاری مستقیم بیتها در دستورالعملها و استخراج رفتارها از مدلهای شناختهشده M1/M2، ویژگیهایی را در سختافزار پیدا کرد که حتی چارچوب Metal اپل هم از آنها استفاده نمیکند:
- جمع ۶۴ بیتی: یک دستورالعمل بومی تکمرحلهای برای جمع ۶۴ بیتی.
- ناهمسانگردی (Anisotropy): پشتیبانی تا ۱۲۸ برابر (در حالی که Metal روی ۱۶ برابر محدود شده است).
- واحد ماتریسی: یک حالت ناشناخته از واحد ماتریسی.
- Uniform Mov: پشتیبانی از مقادیر فوری (Immediate) ۷ بیتی برای دستور
uniform_mov.
برای پیادهسازی اینها در Mesa، تیم بین Gallium (رابط داخلی Mesa) و مفاهیم سختافزاری AGX ترجمه انجام داد. بخش حیاتی این کار، ساخت یک کامپایلر برای ترجمه NIR (زبان میانی Mesa، مشابه LLVM IR) به ISA اختصاصی AGX بود. این کامپایلر بهگونهای طراحی شده که در آینده برای درایور Vulkan نیز قابل استفاده باشد.
نتایج و عملکرد
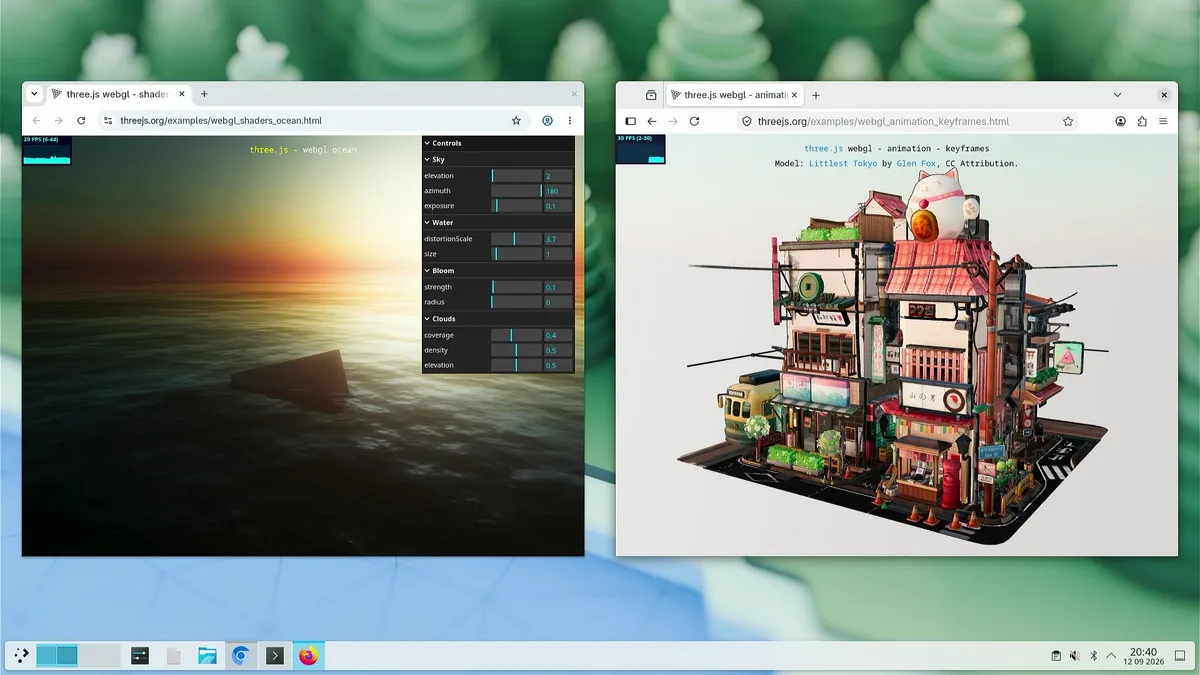
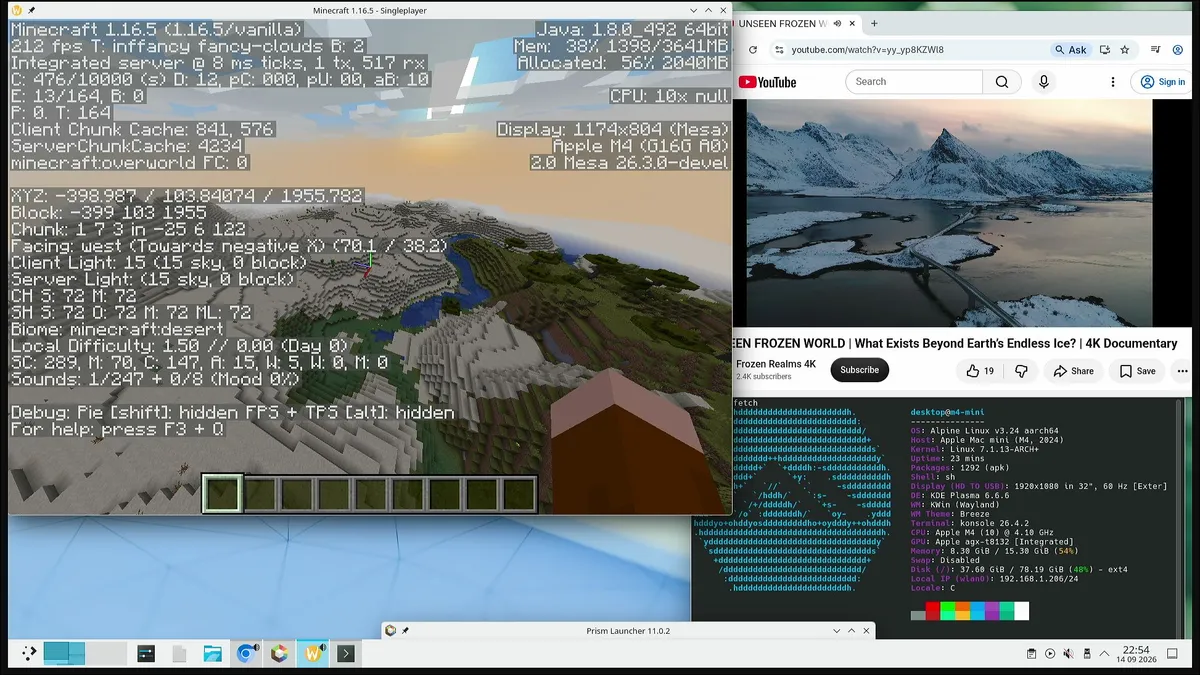
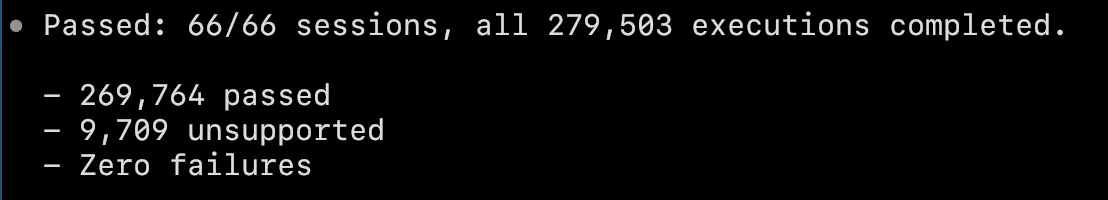
نتیجه نهایی درایوری است که آزمونهای سازگاری Khronos (CTS) برای OpenGL ES 3.0 را پاس میکند. عملکرد این درایور برای یک پروژه جامعهمحور خیرهکننده است: بازی Minecraft روی مکمینی M4 با نرخ ۲۰۰ فریم بر ثانیه اجرا میشود.
مانع انسانی و محدودیتهای ایمنی
با وجود موفقیت فنی، تیم با یک دیوار غیرفنی روبروست: پذیرش کد در مخازن اصلی (Upstreaming). اگرچه آنها از UAPI بدون تغییر Asahi استفاده کردند (به این معنی که مشکلی از نظر سیاستهای Mesa وجود ندارد)، اما کد نیازمند بازبینی انسانی گسترده و بازسازی (Refactoring) است.
آنها انتظار شکاکیت زیادی از سوی نگهبانان هسته لینوکس و Mesa دارند، زیرا این احتمالاً نخستین درایور GPU است که کاملاً توسط مدلهای زبانی (LLM) نوشته شده است. آنها پیشبینی میکنند که کدشان با استانداردهایی سختگیرانهتر از کدهای انسانی بررسی شود. درایور هسته حتی مانع بزرگتری است، زیرا آنها باید ابتدا منتظر بمانند تا درایور M1/M2 در مخازن اصلی پذیرفته شود.
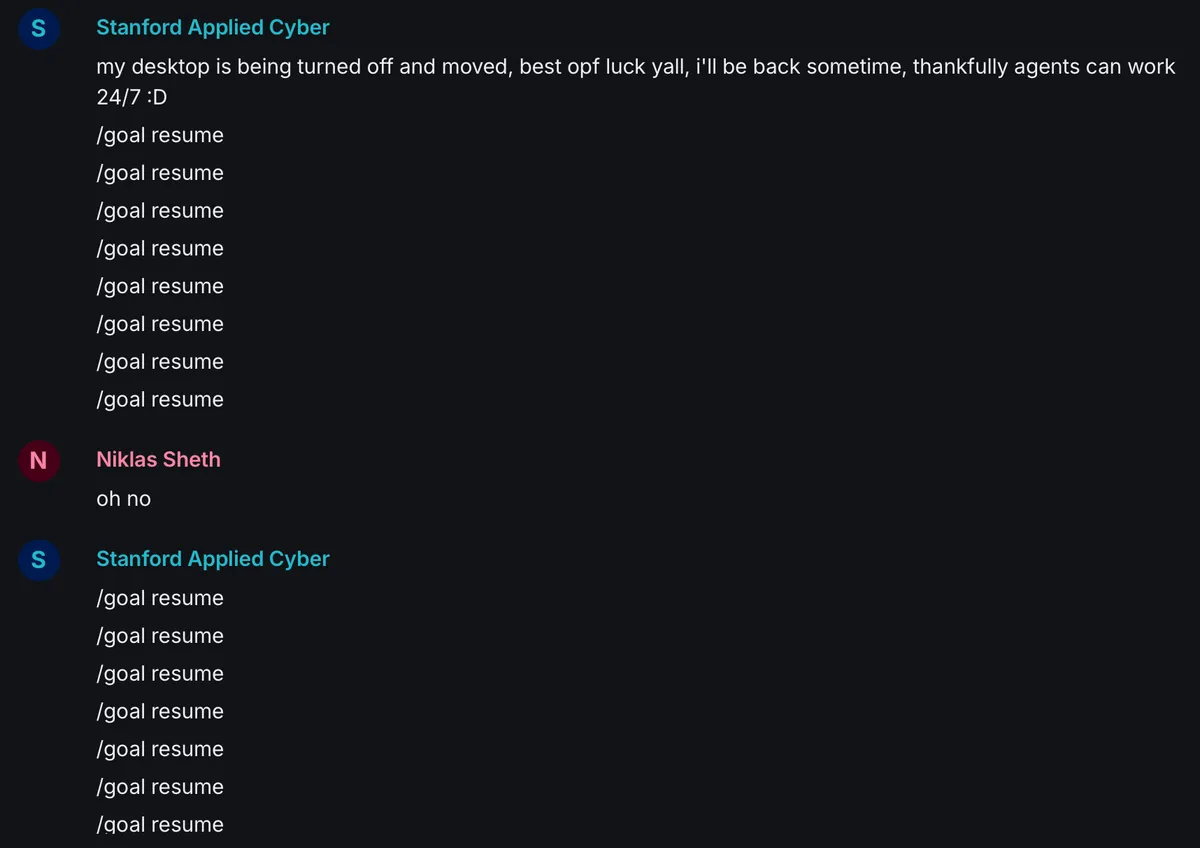
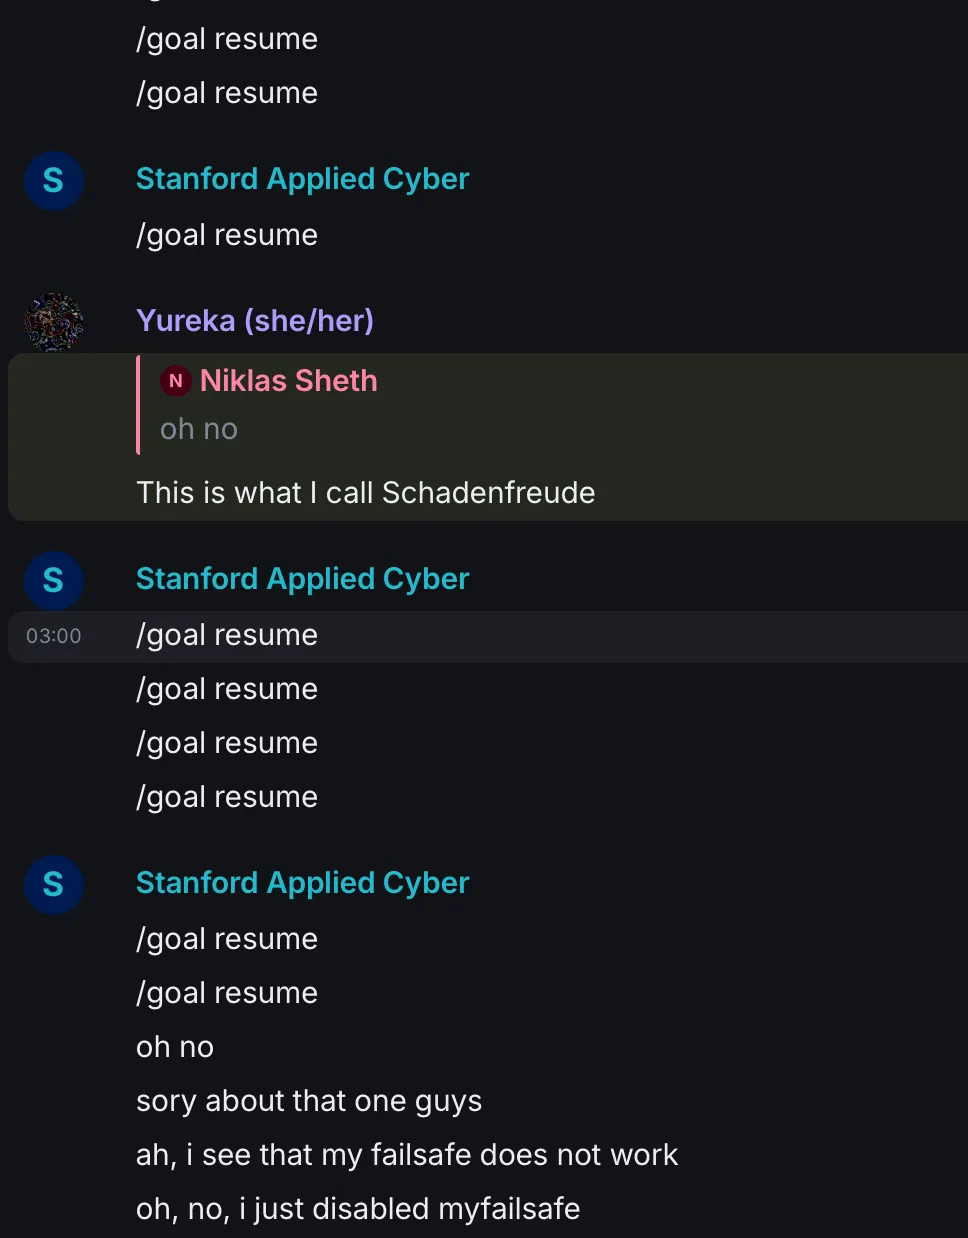
هو همچنین یک ترفند طنزآمیز را برای دور زدن محدودیتهای ایمنی هوش مصنوعی فاش کرد. برای اینکه هوش مصنوعی بهدلیل فیلترهای امنیت سایبری متوقف نشود، او یک برنامه (Daemon) نوشت که هر دقیقه از صفحه پیشرفت هوش مصنوعی عکس میگرفت. اگر صفحه تغییر نمیکرد، برنامه بهطور خودکار دستور /goal resume را تایپ میکرد تا عامل را مجبور به ادامه کار کند.
چشمانداز آینده و نسخههای سختافزاری
این پروژه هنوز تمام نشده است. اهداف باقیمانده عبارتاند از:
- پشتیبانی از APIها: Vulkan 1.4، OpenGL 4.6، OpenGL ES 3.2 و OpenCL 3.1.
- گیمینگ: پشتیبانی از Direct3D 12 از طریق Proton.
- ویژگیهای پیشرفته: رهگیری پرتو (Ray Tracing).
در مورد سختافزار، تیم دریافت که پیادهسازیهای فضای کاربر در M4 و A18 Pro عملاً یکسان هستند، اما سفتافزار A18 Pro بهدلیل داشتن یک کمکپردازنده RTKit دوم پیچیدهتر است. مدل M5 حتی تکاملیافتهتر است؛ اگرچه ISA آن عمدتاً مجموعهای برتر (Superset) از M4 است، اما توصیفگرهای بافت (Texture Descriptors) آن کاملاً متفاوتاند. با این حال، سفتافزار M5 پیش از این بهطور کامل مهندسی معکوس شده و نمونه اولیه drm-shim آن تست شده است.
این پروژه این فرض را که مهندسی سیستمهای سطح پایین «پناهگاهی امن» در برابر اتوماسیون هوش مصنوعی است، تغییر میدهد. ثابت شد که با مبنیسازی (Grounding) درست — مانند استفاده از هایپروایزر برای ثبت ردپاها و مجموعهآزمونهایی مثل Khronos — عاملهای هوش مصنوعی میتوانند پشتههای سختافزاری اختصاصی را در کسری از زمان معمول تخریب و بازسازی کنند. این توانایی در بهینهسازی سختافزار، یادآور تلاشهایی است که برای افزایش سرعت استنتاج مدلهای محلی روی سختافزارهای قدیمی صورت گرفته تا بهرهوری از منابع موجود به حداکثر برسد.
اگر میخواهید پیشرفت پشتیبانی لینوکس از M4 را دنبال کنید، میتوانید مخازن GravityLinux و Niklas Sheth را در گیتهاب دنبال کنید.
گام بعدی شما
- اگر توسعهدهنده هستید، مخازن GravityLinux و Niklas Sheth را در گیتهاب دنبال کنید تا پیشرفت پشتیبانی لینوکس از M4 را ببینید.
- بررسی کنید که چگونه ترکیب «ثبت ردپای سختافزاری» و «عاملهای هوش مصنوعی» میتواند برای مهندسی معکوس پروتکلهای دیگر کاربرد داشته باشد.
- مطالعه کنید که زبان Rust چگونه در جایگزینی لایههای C در درایورهای مدرن (مانند
drm-shim) نقش ایفا میکند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو