
اگر امروز برای اجرای مدلهای هوش مصنوعی روی مکبوک خود به GPU تکیه میکنید، احتمالاً بخش بزرگی از قدرت سختافزاریتان را نادیده گرفتهاید. دادههای جدید نشان میدهد واحد عصبی اپل (ANE) در سناریوهای خاص، میتواند ۸.۵۴ ترافلاپس (TFLOPS) خروجی دهد، در حالی که GPU در همان شرایط تنها به ۲.۳۴ ترافلاپس میرسد. این جهش عملکردی از طریق استفاده از ماتریسهای «Constant-B» حاصل میشود؛ حالتی که در آن وزنها به جای ارسال در زمان اجرا، مستقیماً در گراف محاسباتی کامپایل میشوند.
بسیاری از توسعهدهندگان با تراشه M2 مانند یک بلوک محاسباتی واحد برخورد میکنند، اما در واقعیت، این تراشه چهار موتور مجزا دارد: واحدهای برداری CPU، شتابدهنده ماتریسی AMX، واحد پردازش گرافیکی (GPU) و واحد پردازش عصبی (ANE). در حالی که GPU انتخاب اول اکثر کاربران است، ANE برای سالها مانند یک جعبه سیاه بسته باقی مانده بود که جزئیات عملکرد آن برای کاربران نهایی مخفی بود.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی سختافزارهای لبه اشاره کردیم، دسترسی به لایههای پایینتر سختافزار کلید دستیابی به حداکثر بازدهی است. اکنون پروژههای متنبازی مانند ANEForge این معادله را تغییر دادهاند و به برنامهنویسان اجازه میدهند برنامهها را مستقیماً برای ANE کامپایل و اجرا کنند. این تغییر، ANE را از یک سیستم بسته به ابزاری برنامهپذیر برای استنتاج (Inference) در مدلهای ResNet-18 و ResNet-50 تبدیل کرده است. طبق یک گزارش فنی، کاربرد واقعی این موتورها کاملاً به نحوه بستهبندی دادهها (Data Packing) و دقت محاسباتی مورد استفاده بستگی دارد.
خطوط پایه محاسباتی
برای درک این شکاف عملکردی، ابتدا باید مرزهای تئوریک و اندازهگیری شده برای هر موتور را مشخص کنیم. در این محاسبات، هر عملیات ضرب-جمع ادغامشده (FMA) به عنوان دو عملیات شمارش میشود:
- CPU (تک هسته P): مرجع تئوریک ۰.۱۱۲ ترا-عملیات در ثانیه. این عدد بر اساس فرکانس ۳.۵۰ گیگاهرتز × ۴ واحد FMA بر چرخه × ۴ مسیر FP32 × ۲ فلاپس به ازای هر FMA محاسبه شده است.
- AMX (دقت FP16 به FP16): ۳.۲۷ ترا-عملیات در ثانیه بر اساس بهترین نتیجه از بین سه اجرای دستور تکرشتهای محلی.
- AMX (دقت FP16 به FP32 یا FP32 به FP32): ۱.۶۳ ترا-عملیات در ثانیه بر اساس بهترین نتیجه از بین سه اجرای دستور تکرشتهای محلی.
- GPU (۱۰ هستهای): تخمین ۳.۵۷ ترا-عملیات در ثانیه (محاسبه شده از ۱۰ هسته × ۲۵۶ × ۱.۳۹۵ گیگاهرتز).
- ANE: نرخ اسمی ۱۵.۸۰ ترا-عملیات در ثانیه که توسط اپل منتشر شده است، هرچند دقت تجمیع (Accumulation Precision) در این عدد مشخص نشده است.
کالبدشکافی عملکرد
آزمایشهای انجام شده روی یک مکبوک ایر M2 با ۱۶ گیگابایت رم، تضاد شدیدی را میان مسیرهای محاسباتی مختلف نشان داد. برای یک ماتریس مربع با اندازه N=۲۰۴۸ (با اندازه دسته یا Batch=1)، نتایج به شرح زیر است:
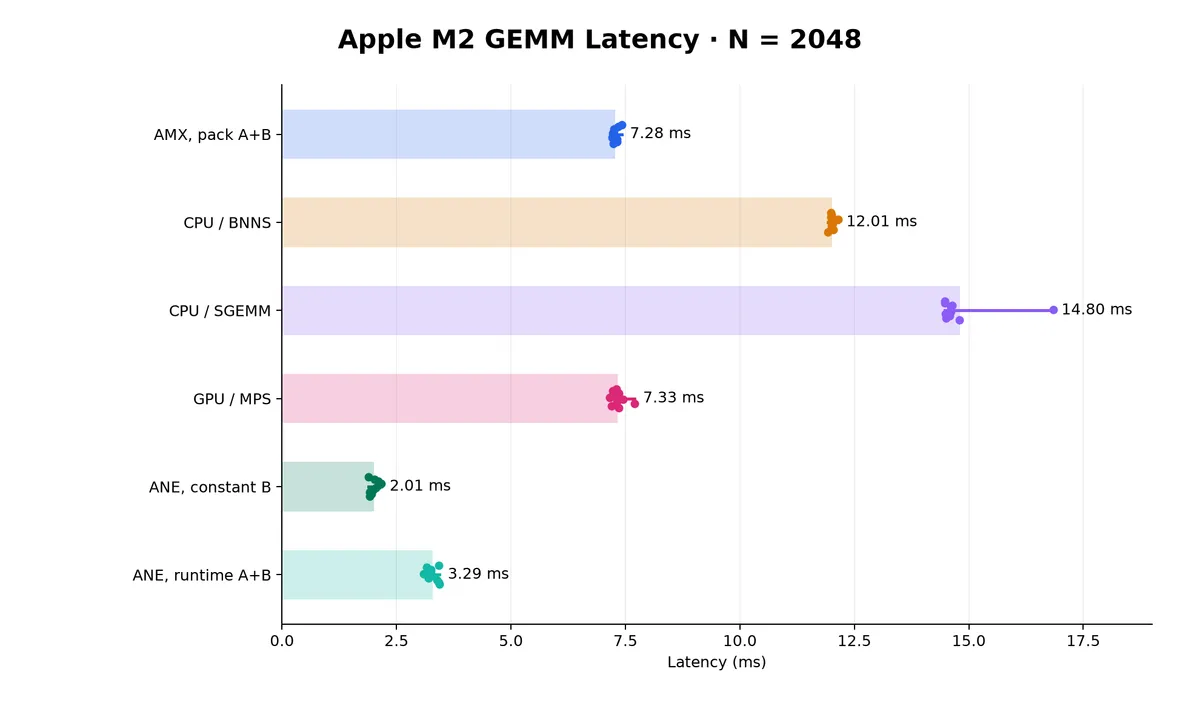
- ANE (وزنهای ثابت/Constant B): ۸.۵۴ ترافلاپس (۵۴.۱٪ از نرخ اسمی ۱۵.۸۰ ترافلاپس اپل) با میانگین زمان ۲.۰۱ میلیثانیه.
- ANE (ورودیهای پویا/Runtime A+B): ۵.۲۲ ترافلاپس (۳۳٪ از نرخ اسمی) با میانگین زمان ۳.۲۹ میلیثانیه.
- AMX (پیشبستهشده/Prepacked): ۲.۹۳ ترافلاپس (۸۹.۵٪ از مرجع) با میانگین زمان ۵.۸۷ میلیثانیه.
- AMX (بستهبندی A+B در هر فراخوانی): ۲.۳۶ ترافلاپس (۷۲.۱٪ از مرجع) با میانگین زمان ۷.۲۸ میلیثانیه.
- GPU (از طریق MPS): ۲.۳۴ ترافلاپس (۶۵.۷٪ از مرجع) با میانگین زمان ۷.۳۳ میلیثانیه.
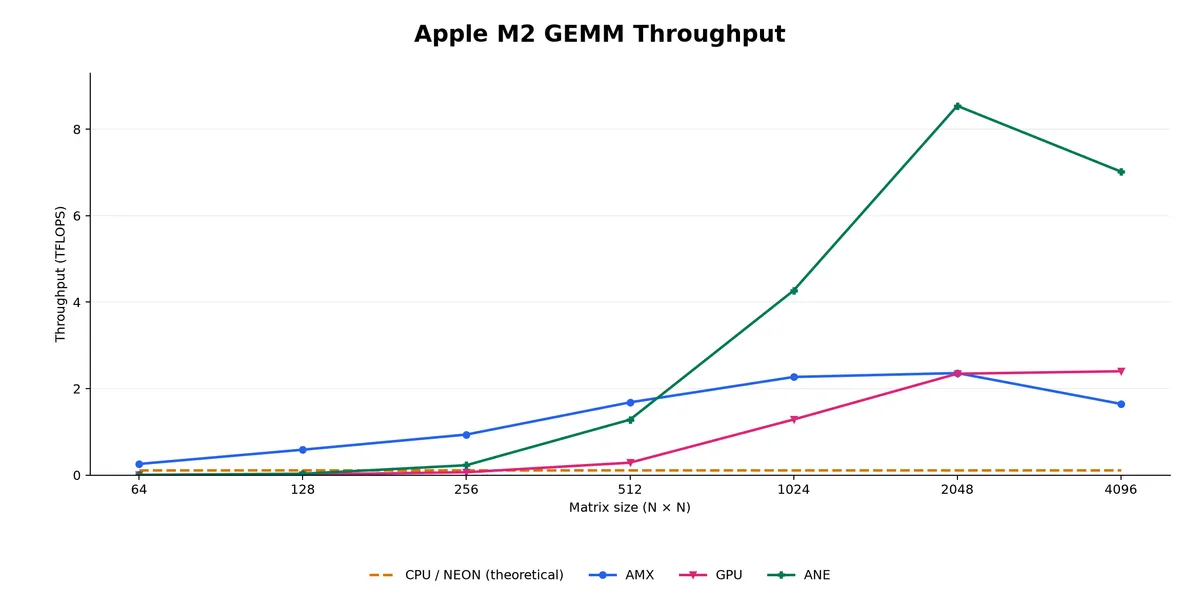
این دادهها ثابت میکنند ANE در ماتریسهای بزرگ برنده مطلق است. با این حال، انعطافپذیری هزینهبر است؛ یک «مالیات» عملکردی برای انعطافپذیری وجود دارد. وقتی ANE مجبور باشد هر دو ماتریس را در زمان اجرا مدیریت کند (به جای استفاده از یک مقدار ثابت)، عملکرد از ۸.۵۴ به ۵.۲۲ ترافلاپس سقوط میکند.
تلهی دقت در AMX
شتابدهنده AMX (Apple Matrix) چالش متفاوتی دارد: شکاف بین دقت ورودی و دقت تجمیع. یک کرنل سفارشی که از تجمیع FP16 استفاده میکرد، به ۲.۹۳ ترافلاپس رسید، اما در مقایسه با FP32 دچار خطای نسبی ۰.۶۵٪ در L2 شد.
در مقابل، پیادهسازی کتابخانه BNNS به ۱.۴۳ ترافلاپس رسید. اگرچه این عدد کمتر به نظر میرسد، اما بررسی کد (Disassembly) فایل libBNNS.dylib نشان داد که یک نقطه توقف (Breakpoint) در زمان اجرا در دستور 0x002012a8 با استفاده از AMX_MATFP(x8) وجود دارد. حالت MATFP mode 3 نشاندهنده ورودیهای FP16 با تجمیع FP32 است. وقتی این مسیر با مرجع صحیح FP32 (۱.۶۳ ترا-عملیات) مقایسه شود، بازدهی واقعی BNNS به ۸۸٪ میرسد.
تحلیل سختافزاری GPU و CPU
واحد گرافیکی ۱۰ هستهای با استفاده از Metal Performance Shaders (MPS) خروجی ۲.۳۴ ترافلاپس داشت. این عملکرد در حالی که پایدار و سازگار است، اما هرگز به اوج سرعت خام ANE نمیرسد. از سوی دیگر، واحدهای NEON در CPU برای این حجم از محاسبات عملاً بیاثر هستند و تنها مرجع تئوریک ۰.۱۱۲ ترافلاپس را برای یک تک هسته P فراهم میکنند.
محدودیتهای سختافزاری و متد تست
این بنچمارکها روی مکبوک ایر M2 با ۴ هسته قدرتمند (Performance) و ۴ هسته کممصرف (Efficiency) اجرا شدند. محیط تست از پروفایلهای توان خاصی استفاده کرد: پیمایشهای GEMM روی باتری اجرا شدند، در حالی که مراجع دستورات AMX روی برق شهری (AC) تست شدند.
- مدیریت داده: از ماتریسهای FP16 با بذر (Seed) یکسان استفاده شد که برای SGEMM به FP32 تبدیل شدند. بافرهای حافظه بدون تخلیه کش (Cache Flush) مجدداً استفاده شدند.
- رشتهها: بهترین میانگین برای هر اندازه از بین حالتهای ۱، ۴ و ۸ رشته برای BNNS و ۱ یا ۴ کارگر (Worker) برای AMX سفارشی انتخاب شد. برای SGEMM از تنظیم
VECLIB_MAXIMUM_THREADS=8استفاده شد. - حذف سربار: زمانهای مربوط به تخصیص حافظه، کامپایل و اعتبارسنجی از زمانسنجی نهایی حذف شدند. در مورد MPS، زمانهای انتظار برای ارسال (Commit) و تکمیل (Completion) لحاظ شدند.
پژوهشگران اشاره کردند که توان عملیاتی (Throughput) برای چندین مسیر در اندازه N=۴۰۹۶ شروع به کاهش میکند. این موضوع نشاندهنده یک گلوگاه در حافظه یا کش است که هنوز به طور کامل رمزگشایی نشده است. این محدودیتهای سختافزاری یادآور این نکته است که ظرفیت و مدیریت رم در مدلهای محلی نقش تعیینکنندهای در انتخاب مدل و نحوه اجرای آن ایفا میکند.
تحلیل: شکاف بهینهسازی
برای یک توسعهدهنده در عمل، این بدان معناست که «بهترین» موتور یک انتخاب ثابت نیست. اگر وزنهای مدل شما استاتیک (ثابت) هستند، ANE تقریباً ۴ برابر سریعتر از GPU است. اما اگر به دقت بسیار بالا و ورودیهای منعطف نیاز دارید، مسیر AMX از طریق BNNS قابلاعتمادترین گزینه است.
این نتایج یک شکاف بهینهسازی عظیم در نرمافزارهای فعلی هوش مصنوعی macOS را آشکار میکند. اکثر اپلیکیشنها به APIهای سطح بالا تکیه میکنند که از قابلیتهای Constant-B در ANE بهره نمیبرند. ما شاهد تغییری هستیم که در آن گلوگاه دیگر ترافلاپس تئوریک سختافزار نیست، بلکه توانایی توسعهدهنده در مدیریت بستهبندی دادهها و کامپایل گراف است.
گام بعدی شما
- توسعهدهندگان باید مخزن ANEForge را بررسی کنند تا ببینند آیا وزنهای مدلشان قابلیت تبدیل به گرافهای Constant-B برای دستیابی به افزایش سرعت خیرهکننده را دارند یا خیر.
- در صورت نیاز به دقت بسیار بالا و ورودیهای متغیر، مسیر AMX از طریق BNNS مطمئنترین گزینه است.
- بررسی کنید که آیا مدل شما در ابعاد ماتریسی بالای ۴۰۹۶ دچار افت سرعت میشود یا خیر؛ زیرا سوال حیاتی بعدی این است که چرا توان عملیاتی در N=۴۰۹۶ فرو میپاشد و چگونه میتوان این محدودیت را دور زد.
اما معماری حافظه در تراشههای جدیدتر اپل ممکن است این گلوگاه را حل کرده باشد — به تحلیل ما دربارهی مدیریت حافظه در M3 مراجعه کنید.



گفتگو