
تصور کنید یک مدیر فروش با تعجب متوجه شود که هوش مصنوعی او به مشتریی تخفیف پیشنهاد داده است که همین سه هفته پیش گفته بود بودجه اصلاً مشکلش نیست. این شکاف حافظه در عاملهای هوش مصنوعی، یکی از بزرگترین موانع تبدیل آنها به دستیاران استراتژیک در دنیای واقعی است. عامل فروش B2B به نام DealMind AI اکنون میتواند تشخیص دهد چه زمانی مشتریان با اظهارات گذشته خود تناقض دارند؛ این کار را از طریق جداسازی دادههای لحظهای CRM از حافظه بلندمدت انجام میدهد. این معماری از شکستهای رایجی جلوگیری میکند که در آن عاملهای AI به مشتریانی که قبلاً گفته بودند بودجه مانع نیست، پیشنهاد تخفیف میدهند.
بسیاری از گردشهای کاری در سامانههای مدیریت ارتباط با مشتری (CRM)، اولویت را به دادههای لحظهای میدهند و آخرین یادداشتها را مستقیماً به یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — میسپارند. در این حالت، روایت زمانی و ترتیب وقایع گم میشود. طبق گزارش توسعهدهنده DealMind AI، او دریافت که با نگاه کردن تنها به آخرین snapshot یا تصویر لحظهای CRM، عامل AI تغییرات ساختاری در موضع مشتری را نادیده میگیرد. برای مثال، اگر مشتری ناگهان ادعا کند که بودجه ندارد، عامل صرفاً توصیه به تخفیف میکند، بدون اینکه بداند سه هفته پیش، همان مشتری صراحتاً گفته بود بودجه مانع نیست.
همانطور که در تحلیلهای قبلی ما دربارهی حافظهٔ عاملهای هوش مصنوعی اشاره کردیم، گسترش سادهی پنجره متنی (Context Window) — یعنی میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — لزوماً راهکار نیست. توسعهدهنده اشاره کرد که صرفاً بزرگتر کردن پنجره متنی باعث افزایش تأخیر (Latency) و کاهش قدرت استدلال مدل میشود.
برای حل این مشکل، DealMind AI از یک فرآیند بازیابی دو جریانی استفاده میکند تا حس واقعی زمان را حفظ کند. این سیستم که بر پایه FastAPI ساخته شده، جمعآوری زمینه را به دو جریان مجزا تقسیم میکند: واقعیت لحظهای CRM و حافظه عمیق تاریخی. این رویکرد مشابه مکانیزمهای حافظه پایدار است که در سیستم OpsMind برای خودکارسازی تشخیص علت ریشهای خطاها به کار گرفته شد تا از گم شدن جزئیات حیاتی در دادههای حجیم جلوگیری شود.
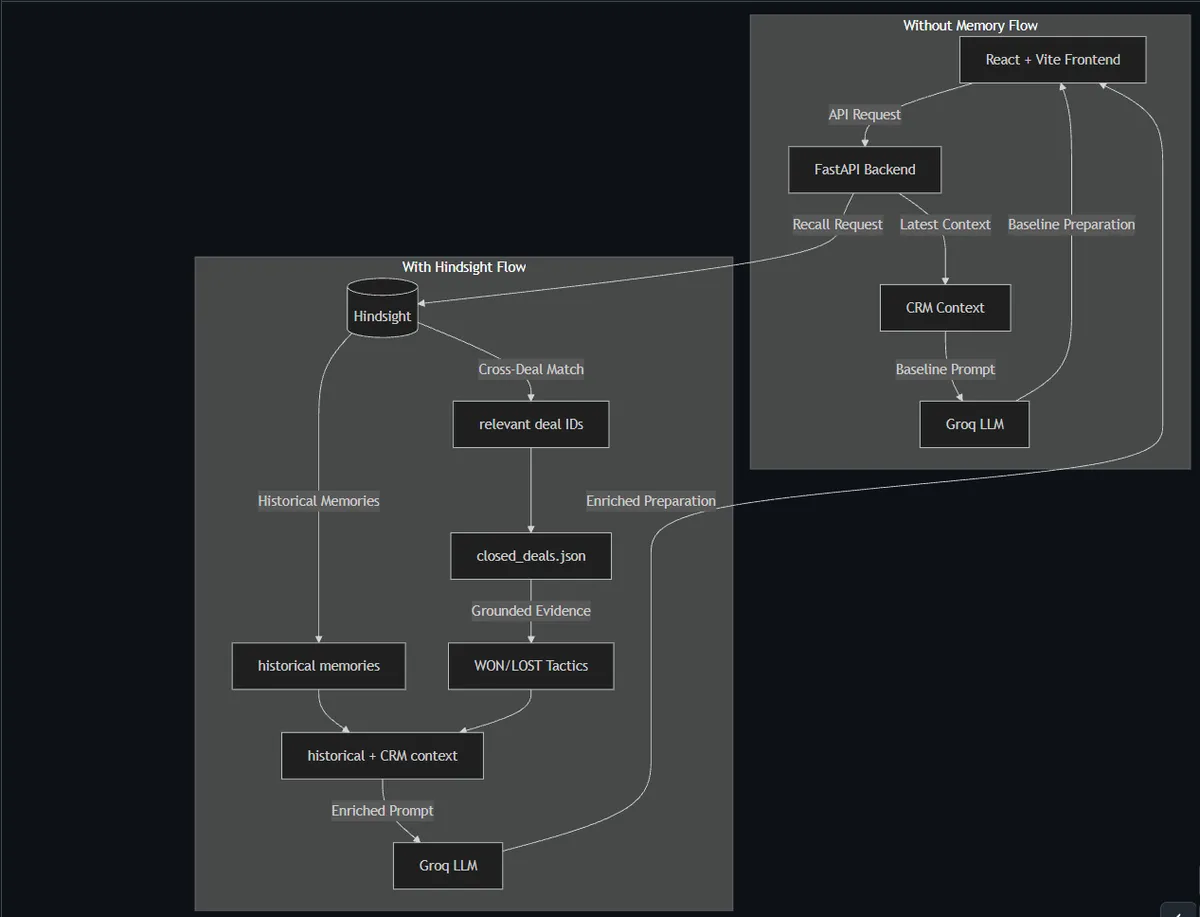
به جای تزریق کل تاریخچه معامله به پرامپت، که باعث حجیم شدن پنجره متنی میشود، این عامل از مکانیزم Hindsight برای فراخوانی تنها تعاملات مرتبط با پرسوجوی فعلی استفاده میکند. این فرآیند طبق مستندات فنی سیستم، از یک توالی فنی مشخص میگذرد:
- زمینه سازی (Contextualization): سیستم پرسوجوی کاربر را با یک شناسه معامله (Deal ID) مشخص محدود میکند (مثلاً:
scoped_query = f"[Deal: {request.deal_id}] {request.query}"). - فراخوانی (Recall): حافظههای تاریخی مرتبط از یک بانک Hindsight با استفاده از دستور
hindsight.recallو یکbank_idمشخص بازیابی میشوند. - استخراج (Extraction): سیستم بهصورت ایمن متنهای تاریخی را از پاسخهای دریافتی استخراج میکند.
- اتصال (Stitching): این حافظههای زمانی با آخرین وضعیت لحظهای CRM ترکیب و به هم متصل میشوند.
این دادههای غنیشده و چند-مرحلهای (multi-turn payload) سپس توسط سرویس تحلیلی متکی به Groq پردازش میشوند. چون مدل را تشویق میکنند تا بهجای خلاصهسازی ساده، بهدنبال «تغییر موضع» بگردد، میتواند تضادها را شناسایی کند. در این حالت، سیستم به نماینده فروش هشدار میدهد: «مشتری قبلاً گفته بود بودجه باز است، اما حالا بهدلیل محدودیتهای مالی، درخواست اجرای مرحلهبندی شده دارد.»
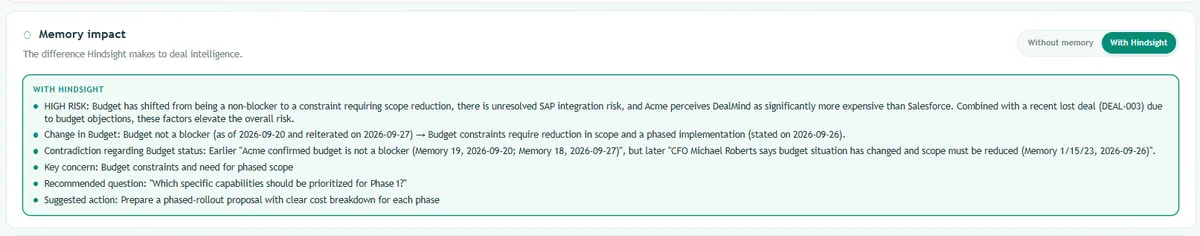
اما چالش اصلی زمانی رخ داد که توسعهدهنده خواست از دانش سازمانی معاملات بسته شده در گذشته استفاده کند. هدف این بود که تمام دادههای تاریخی برای معاملاتی که با فشار قیمتی یا اعتراض بودجه مواجه شده بودند، بررسی شود تا الگوهای موفقیت استخراج گردد.
سیستم Hindsight بهدرستی شناسههایی مثل DEAL-002 (یک معامله برنده) و DEAL-003 (یک معامله بازنده) را بازگرداند. در ابتدا، از LLM خواسته شد تا یک آرایه JSON به نام similar_deals شامل نتیجه و تاکتیکهای استفاده شده بسازد. اما بهدلیل ماهیت غیرقطعی (Nondeterministic) مدلهای زبانی، مدل بهطور متناوب تصمیم میگرفت که معاملات شکستخورده — مثل DEAL-003 — برای آمادگی در معاملات جدید «نامرتبط» هستند و آنها را بهطور خاموش از خروجی حذف میکرد.
این یعنی رابط کاربری بهصورت ناسازگار گاهی هر دو معامله و گاهی فقط بردها را نشان میداد؛ چون مدل در حین تلاش برای نگاشت دادههای بازیابی شده به یک ساختار سختگیرانه، بهطور خودسرانه شواهد را فیلتر میکرد.
برای رفع این نقص، تیم از مبنیسازی (Grounding) قطعی استفاده کرد. توسعهدهنده دریافت که LLM برای خلاصههای متنی عالی است، اما نباید مسئول یکپارچگی دادهها (Data Integrity) باشد.
آنها مسیر بکاند را بازنویسی کردند تا نقشهبرداری بازیابی را از تولید متن مدل جدا کنند. بهجای سپردن فرمتبندی معاملات به مدل، از پایتون برای کارهای زیر استفاده کردند:
۱. رهگیری متن خام بازگشتی از Hindsight.
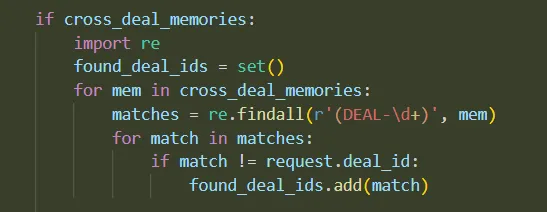
۲. استفاده از Regex (عبارات منظم) برای استخراج دقیق شناسههای معامله.
۳. تطبیق قطعی این شناسهها با یک فایل مرجع closed_deals.json که از پیش مقداردهی شده بود.
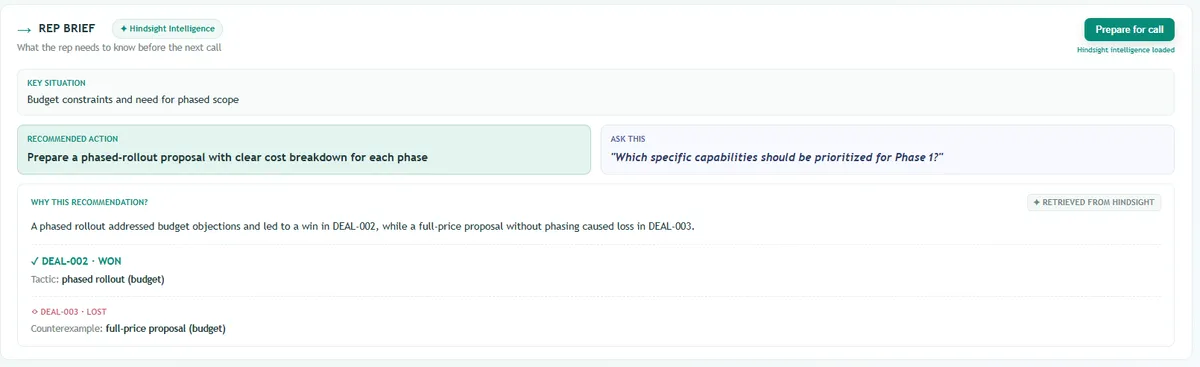
با این روش، سیستم ۱۰۰٪ قطعی شد. مدل زبانی همچنان تحلیل استراتژیک را مینویسد، اما معاملات برنده (WON) و بازنده (LOST) نمایش داده شده در UI، مستقیماً از دادههای تأییدشده میآیند و دیگر توسط مدل فیلتر نمیشوند.
ساخت DealMind AI چهار قانون طلایی برای عاملهای تقویتشده با حافظه به دست داد:
- جداسازی لایههای زمینه: واقعیت لحظهای (آخرین یادداشت CRM) را کورکورانه با حافظه بلندمدت ادغام نکنید. این کار اجازه میدهد تا مقایسههای A/B انجام شود تا ثابت گردد خط لوله بازیابی واقعاً ارزش افزوده ایجاد میکند و نه فقط نویز.
- جلوگیری از آلودگی داده: هنگام جستوجوی نمونههای «مشابه»، عامل اغلب تاریخچه خودِ معامله فعال را بهدلیل شباهت معنایی بازیابی میکند. توسعهدهندگان باید بهطور فعال شناسه معامله جاری را فیلتر کنند (
if match != request.deal_id) پیش از آنکه نتایج ارائه شوند. - تفکیک استدلال از نقشهبرداری: اجازه دهید LLM تضادها را تشخیص دهد و استراتژی تولید کند، اما برای بازگرداندن شناسههای بازیابی شده به منبع حقیقت (Source of Truth)، از کد قطعی استفاده کنید.
- شفافیت برای اعتماد: اگر عاملی توصیهای بر اساس حافظه سه ماه پیش میدهد، نماینده فروش بدون دانستن منبع (Provenance)، آن را نادیده میگیرد. سیستم اکنون تعداد دقیق حافظههای استفاده شده را افشا کرده و شواهد برد/باخت را مستقیماً در UI رندر میکند.
این تغییر معماری، عامل را از یک خلاصهساز ساده به یک سامانه هشدار استراتژیک تبدیل میکند و تضمین میکند که بینشهای ارائه شده، مبتنی بر شواهد باشند نه توهمات مدل.
گام بعدی شما
- اگر از RAG برای عاملهای خود استفاده میکنید، بررسی کنید که آیا مدل شما بهطور خاموش دادههای «نامطلوب» (مثل شکستها) را فیلتر میکند یا خیر.
- لایه استخراج شناسهها (ID Extraction) را از لایه تولید متن (Generation) جدا کنید تا یکپارچگی دادههای UI تضمین شود.
- برای افزایش اعتماد کاربر، منبع هر توصیه استراتژیک را با ذکر تاریخ و شناسه سند در خروجی نمایش دهید.
اما داستان سختافزاری این تحول و تأثیر سرعت استنتاج Groq بر تجربه کاربر حتی شگفتانگیزتر است — به تحلیل ما درباره شتابدهندههای استنتاج مراجعه کنید.



گفتگو