اگر یک تست از عامل هوش مصنوعی در محیط محلی شما پاس میشود اما در خط لوله CI شکست میخورد، احتمالاً با یک خطای مدل طرف نیستید، بلکه با عدم تطابق محیطی روبرو شدهاید. برای حل این چالش، توسعهدهندگان اکنون از Docker Compose برای ساخت آزمایشگاههای ارزیابی ایزوله استفاده میکنند تا تمام متغیرها بهجز منطق مدل را منجمد کنند.
تست عامل (Agent) — شبیه مدیریت تیمی از کارمندان است که هر کدام دسترسی به ابزارهای متفاوتی دارند و باید با هم هماهنگ شوند — بهدلیل تعامل با ابزارهای پویا، پایگاهدادهها و ساعتهای سیستم بهشدت دشوار است. اگرچه یک کانتینر نمیتواند یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — را کاملاً پیشبینیپذیر کند، اما میتواند «تغییرات تصادفی» مانند نوسان پاسخهای API یا تغییر وابستگیها را حذف کند؛ مواردی که اغلب باعث پوشانده شدن پسرفتهای رفتاری واقعی میشوند. طبق یک راهنمای فنی منتشر شده در ۲۱ سپتامبر ۲۰۲۶، هدف این است که متغیرهای تصادفی را از اتفاقات پیشبینینشده به تصمیمات مهندسی نسخهبندیشده تبدیل کنیم.
همانطور که در تحلیلهای قبلی ما دربارهی استقرار مدلهای بازمتن اشاره کردیم، ثبات زیرساخت پیشنیاز هرگونه ارزیابی دقیق است.
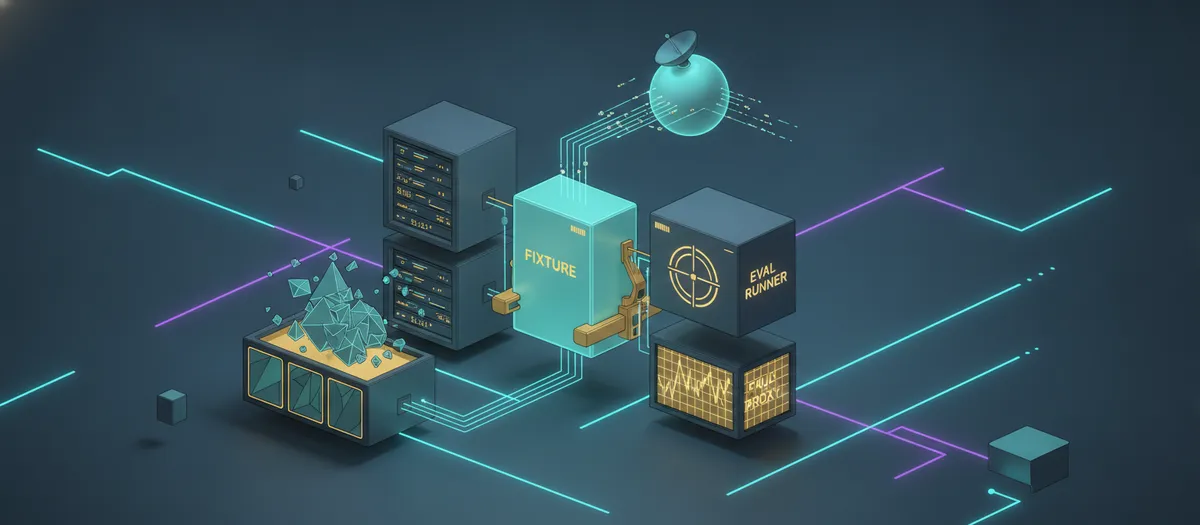
معماری آزمایشگاه
این سامانه بر یک ساختار سرویسهای لایهبندیشده تکیه دارد که از پروفایلهای Compose برای جداسازی نیازهای اصلی از آزمایشهای اختیاری استفاده میکند. سرویسهای بدون پروفایل بهطور عادی اجرا میشوند، در حالی که سرویسهای دارای پروفایل تنها زمانی فعال میشوند که بهطور صریح هدف قرار گیرند یا فعال شوند.
- Fixture API: سرویس مرکزی که پاسخهای مصنوعی و نسخهبندیشده ابزارها را ارائه میدهد. این سرویس از یک ساعت ثابت (مثلاً "2026-09-01T12:00:00Z") و یک مسیر دادههای مشخص (مثلاً
/fixtures/cases.json) استفاده میکند تا منطقهای وابسته به زمان ثابت بمانند. این سرویس شامل یک بررسی سلامت (healthcheck) است که تا ۲۰ بار تلاش میکند تا از پایداری اتصال اطمینان حاصل کند. برای مدیریت بهینه این سرویسها در محیطهای عملیاتی، میتوان از استراتژیهای خودترمیمی سریع برای سرویسهای داکر بهره برد تا پایداری زیرساخت تضمین شود. - Eval-Runner: موتور اصلی اجرا که پیش از شروع، وابسته به سلامت Fixture API است. این بخش با یک بذر (Seed) مشخص (مثلاً "1701") پیکربندی شده و دایرکتوریهای شواهد را برای ماندگاری دادهها مونت (mount) میکند.
- Fault Proxy: سرویسی اختیاری با استفاده از Toxiproxy (از طریق یک Digest SHA256 مشخص) برای تزریق تأخیر (timeout) یا پاسخهای بدشکل. این سرویس به توسعهدهندگان اجازه میدهد تابآوری عامل را تحت پروفایل
[fault]تست کنند. - OTel Collector: لایهای اختیاری برای تلهمتری و مشاهده ردپاهای داخلی عامل که از طریق پروفایل
[observe]فعال میشود.
بر اساس مستندات این روش، برای تضمین بازتولیدپذیری مطلق، باید ایمیجها را بهجای تگ، با اثر انگشت SHA256 تثبیت کرد و برای وابستگیهای جاوااسکریپت از Lockfileها با نصبهای منجمد (frozen installs) استفاده نمود. هر اجرای تست با یک مانیفست محیطی همراه است که نسخه پرامپت (مثلاً "refund-v7")، نسخه شمای ابزارها ("tools-v5")، نسخه پالیسی ("policy-v3") و بذر تصادفی (مثلاً seed 1701) را ثبت میکند.
ابزارهای بازتولیدپذیر
برای بازتولیدپذیر کردن ابزارها، آزمایشگاه فراخوانیهای API تولیدی را به سمت fixture-api هدایت میکند. بهجای تماس با یک نقطه پایانی متغیر در محیط تولید، عامل مسیری مصنوعی مانند /orders/synthetic-42 را فراخوانی میکند و در هدر درخواست، شناسه مورد را مشخص میکند (مثلاً x-eval-case: refund-approval-required).
سرویس Fixture برای آن نسخه خاص، دقیقاً همان بدنه، وضعیت (status) و تأخیر مصنوعی را برمیگرداند. این سازوکار به توسعهدهنده اجازه میدهد بین یک پسرفت رفتاری — مانند اینکه عامل یک مرحله تأیید صلاحیت را نادیده بگیرد — و یک تغییر در بکاند تمایز قائل شود. اگر پروفایل خطا از طریق دستور docker compose --profile fault run --rm eval-runner اضافه شود، سیستم میتواند بهطور عمدی تأخیرهایی را ایجاد کند تا منطق تلاش مجدد (retry logic) تست شود.
شواهد و نمرهدهی
این آزمایشگاه بهجای تکیه بر کد خروجی ساده (exit code) فرآیند، مجموعهای از مصنوعات محدود را در دایرکتوری مونتشده ./evidence ذخیره میکند. این موارد شامل موارد زیر است:
- فایلهای
environment.jsonوresults.json - فایل
junit.xmlبرای یکپارچهسازی با CI - پوشه
traces/برای بررسی دقیق مسیرهای اجرا - فایل
README.mdکه دستور اجرا، نسخه fixture و تغییرناپذیرهای مورد انتظار را شناسایی میکند.
برای جلوگیری از فساد دادهها در طول اجرای موازی جابهای CI، سیستم نتایج را در دایرکتوریهای منحصربهفرد (مثلاً run-2026-09-09-1701) مینویسد و تنها پس از تخلیه کامل تمام مصنوعات، یک فایل نشانگر COMPLETE ایجاد میکند. این کار تضمین میکند که اجراهای ناقص هرگز بهعنوان ارزیابیهای تکمیلشده نمرهدهی نشوند. در مقیاسهای بزرگتر، مدیریت این نوع تستها میتواند با چالشهای مشابهی روبرو شود که برخی از نقاط شکست رایج در مقیاسدهی ابزارهای تست هوش مصنوعی در تحلیلهای فنی ما بررسی شده است.
هنگام ارزیابی یک نسخه کاندید در برابر نسخه پایه، سامانه یک فایل مقایسهای ماشینخوان تولید میکند. این فایل بهجای ارائه یک امتیاز میانگین، دقیقاً ردیابی میکند که کدام موارد خاص دچار پسرفت شدهاند (مثلاً "refund-approval-required") یا بهبود یافتهاند (مثلاً "policy-timeout-recovery"). این رویکرد مانع از آن میشود که یک کاندید صرفاً بهدلیل بهبود در ۱۰ مورد بیاهمیت، شکست در یک اقدام حیاتی و محافظتشده را بپوشاند و پاس شود.
تحلیل فنی
این تغییر رویکرد، ارزیابی عاملها را از «سنجش حسی» (Vibe Check) به مهندسی نرمافزار دقیق تبدیل میکند. با هدایت فراخوانیهای API تولیدی به یک fixture-api ثابت، توسعهدهندگان در نهایت میتوانند پاسخ دهند که آیا عامل یک مرحله تأیید را بهدلیل تغییر در پرامپت حذف کرده است یا بهدلیل اینکه API بکاند شمای خود را تغییر داده است.
برای یک متخصص، این یعنی اولین سؤال هنگام شکست تست بهجای «آیا ساعت لپتاپ من متفاوت بود؟» تبدیل میشود به «کدام رفتار تغییر کرد؟». این رویکرد میپذیرد که اگرچه دمای (Temperature) صفر یک تضمین ریاضی برای یکسانی نیست، اما کنترل ورودیها نتایج را برای ردیابی مسیر پیشرفت در طول زمان به اندازه کافی پایدار میکند.
باید توجه داشت که Compose همه چیز را حل نمیکند؛ این ابزار نمیتواند بار شبکه تولیدی، ایندکسهای برداری محیط تولید یا شرایط رقابتی توزیعشده (Race Conditions) را بازسازی کند. با این حال، تبدیل متغیرها به تصمیمات مهندسی نسخهبندیشده، بنیادی استوار برای ارزیابی فراهم میکند.
گام بعدی شما
- وابستگیهای خارجی عامل خود را شناسایی و لیست کنید.
- فراخوانیهای API زنده را با یک سرویس Fixture نسخهبندیشده در یک فایل Compose محلی جایگزین کنید.
- از SHA256 برای تثبیت ایمیجهای زیرساختی در محیط تست استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو