
تصور کنید یک مدیر فروشگاه میخواهد بداند دقیقاً چند نفر وارد 매장 شدهاند، اما سیستم هوش مصنوعی او هر بار که یک مشتری کمی تکان میخورد، او را سه بار میشمارد. شکاف عمیقی میان کشیدن یک کادر دور شخص و ثبت یک «رویداد بازدید» واقعی وجود دارد. برای اینکه یک فروشگاه خردهفروشی بتواند بازدیدکنندگان را بهطور واقعی شمارش کند، یک سیستم هوش مصنوعی لبه (Edge AI) باید یک خط لوله پیچیده را مدیریت کند که پیکسلهای خام را به یک شمارش پایدار تبدیل میکند؛ فرآیندی که اغلب در دموهای ساده شکست میخورد.
بسیاری از نمایشهای تبلیغاتی هوش مصنوعی تنها به این اکتفا میکنند که مدل بتواند ۵ نفر را در یک فریم با نرخ فریم (FPS) بالا پیدا کند. اما طبق راهنمای فنی منتشر شده در dev.to در ۸ سپتامبر ۲۰۲۶، یک شمارندهٔ آماده برای تولید به پنج مرحله مجزا نیاز دارد: ثبت فریم، نرمالسازی، تشخیص شخص، ردیابی و تبدیل به رویداد.
خط لوله ثبت دادهها
مرحله ثبت، نادیده گرفتهشدهترین بخش است. اگر دوربینی ادعای ۳۰ فریم بر ثانیه را داشته باشد اما برنامه فریمها را بهصورت نامنظم و در دستههای نابرابر (Uneven Bursts) دریافت کند، مدل بهجای حرکت پیوسته، پرشهای ناگهانی میبیند. توسعهدهندگان اغلب از کلاس OpenCV's VideoCapture استفاده میکنند، اما رفتار این ابزار بسته به اینکه در پسزمینه از V4L2, GStreamer یا FFmpeg استفاده شود، بهشدت تغییر میکند.
برای تثبیت این وضعیت، توسعهدهندگان باید فریمها را بخوانند، برچسبهای زمانی یکنواخت (Monotonic Timestamps) بزنند و اندازهگیری کنند که حلقه ثبت هر چند وقت یکبار متوقف میشود. همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی استنتاج در لبه اشاره کردیم، مدیریت حافظه در این لایه حیاتی است. بررسی اینکه کدام بکاند فعال است، تنظیم آگاهانه بافر در صورت امکان و ثبت (Log) خطاها بهجای تلقی کردن یک فریم خالی به عنوان یک مورد گمشده معمولی، برای پایداری سیستم ضروری است.
نقاط آسیبپذیر زنجیره
هر مرحله از این خط لوله میتواند اطلاعات را از دست بدهد و شمارنده نهایی تمام این خطاها را به ارث میبرد:
- ثبت: احتمال ارسال فریمهای قدیمی از حافظه موقت (Buffer) که باعث تأخیر در تشخیص میشود.
- تغییر اندازه (Resizing): کوچک کردن تصویر میتواند باعث شود افراد دوردست برای مدل بیش از حد کوچک شوند و دیده نشوند.
- تشخیص: احتمال گم کردن شخصی که توسط شیء دیگری یا فردی دیگر پوشانده شده است (Occlusion).
- ردیابی: احتمال اختصاص یک شناسه (ID) جدید به شخصی که در میانه درگاه قرار دارد و برای لحظهای از دید خارج شده است.
شکاف حافظه: تشخیص در برابر ردیابی
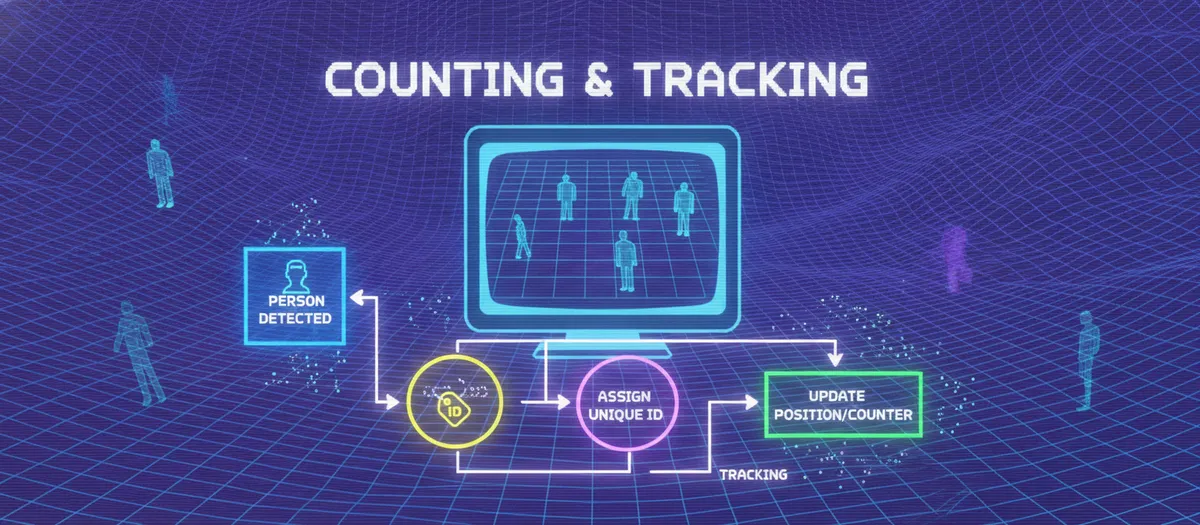
یک مدل تشخیص اشیا (Object Detection) — شبیه عکاسی سریع که فقط میگوید در این لحظه چه کسی در عکس است — مختصات، کلاس شیء و امتیاز اطمینان را برای یک فریم میدهد اما هیچ حافظهای ندارد. مدل نمیداند شخصی که اکنون کنار در است، همان کسی است که ۴۰ میلیثانیه پیش دیده شده بود. برای حل این مشکل، یک ردیاب (Tracker) یک شناسه موقت به هر شخص اختصاص میدهد.
در حالی که تطبیق ساده مرکز ثقل (Centroid Matching) برای نماهای عمودی، خلوت و از بالا به پایین جواب میدهد، ورودیهای شلوغتر به پیشبینی حرکت و تحلیل ظاهر یا نشانههای همپوشانی نیاز دارند تا تداخل مسیرها و پوشاندن موقت افراد توسط یکدیگر را مدیریت کنند.
عبور از خط در اینجا به یک مسئله مدیریت وضعیت (State Problem) تبدیل میشود. سیستم باید موقعیت قبلی و فعلی هر شناسه فعال را نسبت به یک خط مجازی ردیابی کند. رویداد تنها زمانی صادر میشود که تغییر جهت در منطقه مورد نظر رخ دهد. همچنین باید یک پرچم (Flag) تعبیه شود تا افرادی که روی خط میلرزند یا در لبه آن متوقف شدهاند، باعث تحریک چندین بازدید نشوند.
کدهای عملیاتی در دنیای واقعی به حفاظهای اضافهای برای جلوگیری از «لرزش» (Jittering) چند پیکسلی نیاز دارند تا این لرزشها به عنوان حرکت تکراری شمرده نشوند. این شامل پیادهسازی هیسترزیس (Hysteresis)، تعریف یک منطقه عبور معتبر و تعیین حداقل سن ردیابی (Minimum Track Age) است.
سختافزار و قابلیت اطمینان
انتخاب سختافزار مستقیماً بر کارایی اثر میگذارد. دستگاههایی در کلاس RK3588 ایدهآل هستند زیرا واحد پردازش عصبی (NPU) — مثل یک موتور تخصصی که فقط برای محاسبات ریاضی سنگین هوش مصنوعی ساخته شده — استنتاج را بر عهده میگیرد و CPU مدیریت ردیابی و شبکه را انجام میدهد. این تفکیک تنها زمانی جواب میدهد که مدل بهدرستی تبدیل شده باشد و خط لوله از کپیهای غیرضروری در حافظه پرهیز کند. با این حال، حتی با سختافزار قدرتمند، چالشهای مدیریت حرارتی میتواند باعث کاهش شدید کارایی و شکست عاملهای هوش مصنوعی در لبه شود.
انتخاب سنسور نیز تعیینکننده است. درگاههای باریک با ترافیک منظم را میتوان با سنسورهای پرتوئی ساده یا سنسورهای عمق مدیریت کرد، اما ورودیهای عریض با گروههای انسانی، چرخهای خرید و افرادی که جهت حرکت خود را تغییر میدهند، به بینایی غنیتر و ردیابی پیشرفتهتر نیاز دارند. اغلب، تغییر جایگاه دوربین بیش از تعویض مدل تشخیص، بر دقت اثر میگذارد.
تعداد افراد حاضر (Occupancy) با تعداد تردد (Footfall) متفاوت است. تردد یک رویداد است، اما حضور یک وضعیت است (حضور قبلی + ورودها - خروجها). اگر حتی یک رویداد گم شود، عدد حضور تا زمان اصلاح دستی غلط میماند. به همین دلیل، نظارت بر سلامت سیستم و تطبیق دادهها برای محاسبه حضور حیاتیتر از روندهای روزانه تردد است.
برای تضمین قابلیت اطمینان، سیستم باید دادههای سلامت را گزارش کند، نه فقط اعداد:
- برچسب زمانی آخرین فریم و نرخ فریم (FPS) واقعی ثبت شده
- زمان استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند — و تعداد ردیابیهای فعال
- عمق صف رویدادها و دمای دستگاه
- نسخه مدل مورد استفاده
اگر دوربین پوشانده شود، داشبورد باید وضعیت را «منقضی» (Stale) گزارش کند، نه اینکه تعداد بازدیدکنندگان را صفر نشان دهد. تستها باید شامل لبههای سخت مانند حرکت گروهی شانه به شانه، ایستادن کارکنان کنار خط، تغییرات نور خورشید و شکستهای موقت شبکه باشد.
حریم خصوصی با اطمینان از اینکه فریمهای خام هرگز دستگاه را ترک نمیکنند، تامین میشود. با این حال، پردازش محلی راهکار کامل نیست؛ ضبطهای عیبیابی، نقاط انتهایی پیشنمایش زنده و عکسهای ذخیره شده باید بهصورت پیشفرض غیرفعال باشند تا تصاویر افشا نشوند. این موضوع در حالی است که بسیاری از سازمانها در استقرار سریع هوش مصنوعی، زیرساختهای امنیتی خود را نادیده گرفتهاند و این شکاف امنیتی را به یک ریسک جدی تبدیل کردهاند. دسترسیها باید در زمان راهاندازی محدود شده و سیستم بهجای تاریخچه ردیابی، رویدادهای بینام منتشر کند.
در نهایت، یک شمارنده لبه قابلاتکا، تمرینی در مدیریت دقیق وضعیت است. شبکه عصبی افراد را پیدا میکند، اما منطق برنامه تصمیم میگیرد که آیا این حرکت یک بازدید واقعی است یا خیر.
گام بعدی شما
- بررسی کنید که آیا نرخ فریم دریافتی در برنامه شما با نرخ فریم ادعایی دوربین مطابقت دارد یا خیر.
- برای جلوگیری از شمارش تکراری، یک منطقه «حاشیه امن» (Buffer Zone) در اطراف خط مجازی تعریف کنید.
- سیستم گزارشدهی سلامت (Health Check) را به داشبورد خود اضافه کنید تا از صحت دادهها مطمئن شوید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای NPU در پردازندههای ARM مراجعه کنید.



گفتگو