۱۵۰ میلیثانیه؛ این دقیقاً همان مرزی است که تفاوت میان یک منوی تلفنی رباتیک و انسانی را که در حال جمعوجور کردن افکارش است، تعیین میکند. برای رسیدن به این بودجهٔ زمانی حیاتی در عاملهای صوتی بلادرنگ، ElevenLabs در ۲۸ سپتامبر ۲۰۲۶ مدل Eleven v4 Turbo را روانه بازار کرد.
تعاملات صوتی مدتهاست با مشکل «خط تولید خطی» دستوپنجه نرم میکنند: ابتدا گفتار باید بازشناسی شود، سپس توسط یک مدل زبانی بزرگ (LLM) پردازش شود و در نهایت متن بهطور کامل نوشته شود تا مدل تبدیل متن به گفتار (TTS) بتواند خواندن را آغاز کند. همانطور که در پوشش پیشین ما دربارهی ادغام ElevenLabs با پلتفرمهایی مثل وردپرس برای فعالسازی وبسایتهای صوتی دیدیم، این شرکت اکنون مستقیماً خط لوله پردازش را هدف قرار داده تا سکوتهای مرگباری که جریان مکالمه را میکُرند، حذف کند.
کالبدشکافی خط لوله تأخیر
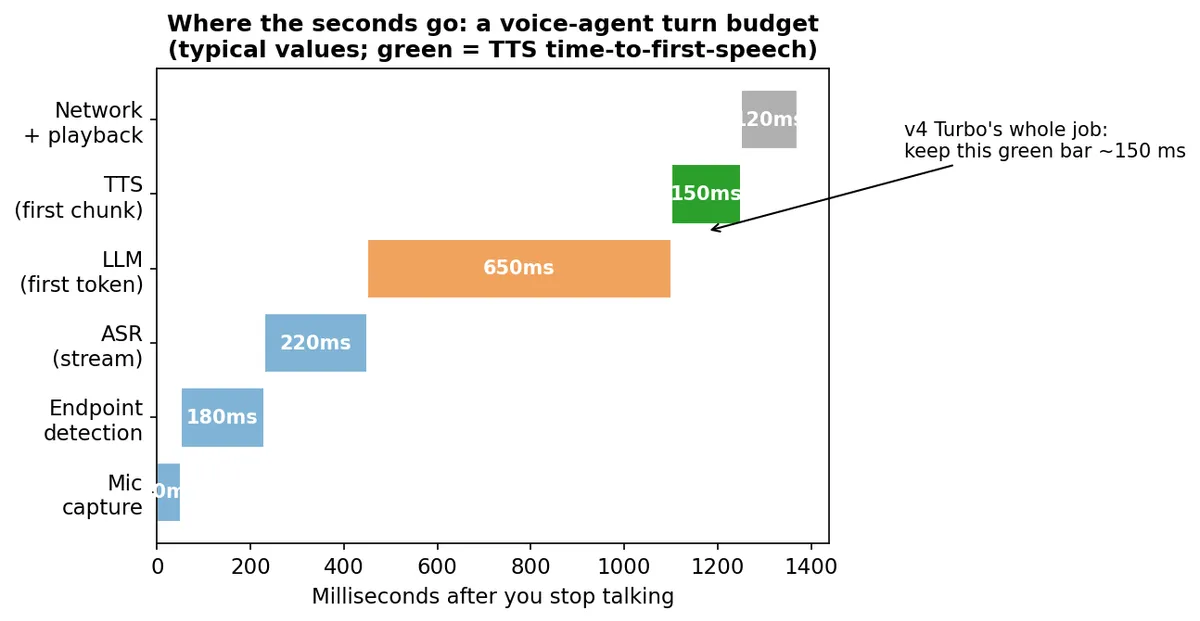
برای درک این راهکار، باید صف انتظار را بشناسیم. طبق تحلیلهای فنی منتشر شده در dev.to، بودجهٔ زمانی یک نوبت مکالمه شامل تشخیص پایان گفتار (حدود ۱۸۰ میلیثانیه)، بازشناسی گفتار (ASR) استریمشده (حدود ۲۲۰ میلیثانیه) و تولید نخستین توکن توسط LLM (حدود ۶۵۰ میلیثانیه) است. آخرین مانع، تولید اولین تکهٔ صوتی و انتقال شبکه است؛ هدف v4 Turbo کاهش این بخش نهایی از خط لوله به کمترین مقدار ممکن است.
بر اساس مستندات فنی، معماری جدید از پردازش دستهای (Batch) فاصله گرفته و به سمت سنتز همپوشان (Overlap Synthesis) حرکت کرده است. در حالی که مدلهای سنتی منتظر پایان یک جمله میمانند تا پردازش را آغاز کنند، v4 Turbo توکنها را دریافت و تکههای صوتی را بهطور همزمان ارسال میکند. این استریم دوطرفه به این معناست که تولید صدا در میانهٔ تفکر مدل آغاز میشود و شروع صدا از طول کل پاسخ مستقل میگردد.
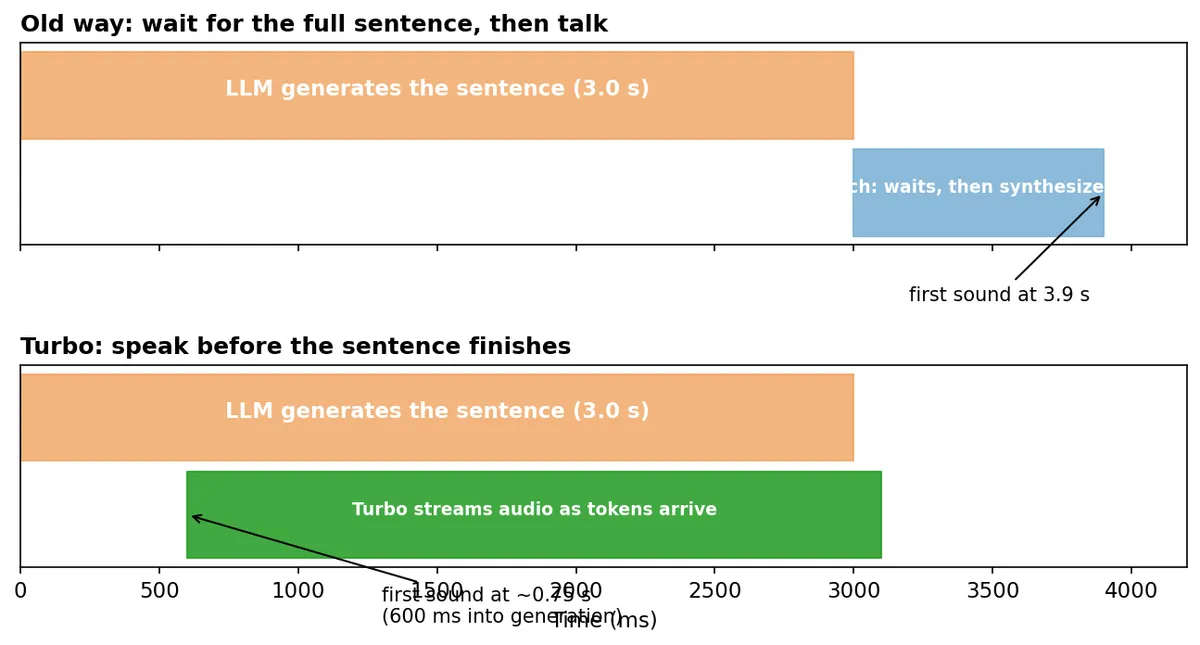
دادههای شبیهسازی نشان میدهند که این شکاف با افزایش طول پاسخها عمیقتر میشود. در مقایسه با مدلهای دستهای، نسخه Turbo در ۲۰ توکن حدود ۳.۵ برابر و در ۸۰ توکن تا ۱۴ برابر سریعتر است. با همپوشانی سنتز و تولید، اولین صدا تنها کسری از ثانیه پس از شروع تولید، فارغ از طول کل جمله، شنیده میشود.
مشخصات مدل و قابلیتها
شرکت ElevenLabs دو نسخه مجزا برای نیازهای مختلف تولیدی ارائه کرده است:
- Eleven v4 (کیفیتمحور): این مدل برای کتابهای صوتی، دوبله، اجرای شخصیتها و تبلیغات ساخته شده است. این مدل دارای میانگین استنتاج (Inference) ۱۰۰ میلیثانیهای است و از نقاط انتهایی REST و استریم استفاده میکند. این نسخه پشتیبانی از شبیهسازی صدای حرفهای (PVC) را که در نسخه v3 حذف شده بود، بازگردانده است و پشتیبانی زبانی آن از ۷۰ به بیش از ۹۰ زبان افزایش یافته است. در این راستا، مقایسهای جامع میان ElevenLabs و Speechify تفاوتهای کلیدی میان کیفیت خروجی و هزینههای عملیاتی این دو پلتفرم را بررسی کرده است.
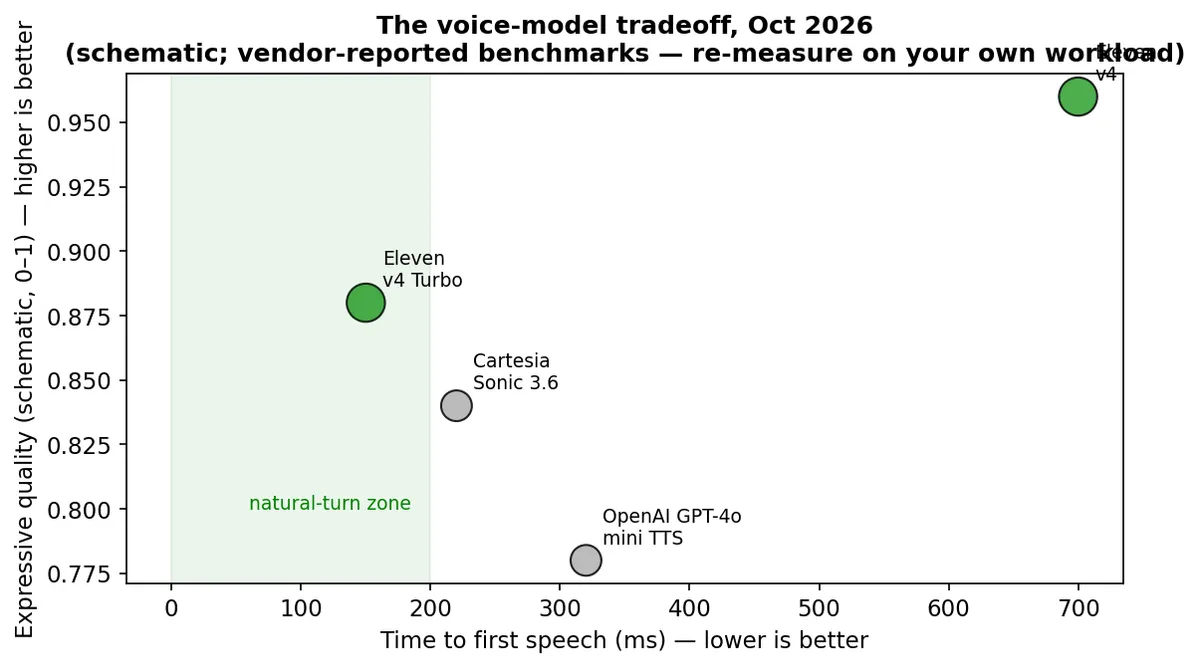
- Eleven v4 Turbo (سرعتمحور): مخصوص عاملهای صوتی، تماسهای زنده و دستیارهای بلادرنگ است. این مدل با استفاده از استریم دوطرفه، در بنچمارکهای WebSocket شرکت، به میانگین زمان ۱۵۰ میلیثانیهای برای «اولین گفتار» (Time-to-first-speech) دست یافته است.
به گزارش این شرکت، جهش کیفیت قابلتوجهی در زبانهای ماندارین، کانتونی، پرتغالی برزیلی و ژاپنی رخ داده است؛ حوزههایی که مدلهای قبلی در آنها با دشواری روبرو بودند. ElevenLabs مدعی است در زمان عرضه، رتبه نخست Speech Arena در Artificial Analysis را از نظر استواری تلفظ (Pronunciation-robustness) به دست آورده است.
از متنخوان تا بازیگر صدا
فراتر از سرعت، معماری v4 قابلیت «بازیگری» را از طریق تحویل متنِ آگاه به زمینه معرفی میکند. یک مدل صوتی مدرن باید سه وظیفه متمایز را انجام دهد: تلفظ (برنامهریز واجها)، عروض (کارگردانی لحن و سرعت) و هویت صوتی (بردار معنایی یا Embedding صدا).
مدلهای قدیمی شبیه بازیگران جایگزینی بودند که متن را برای اولین بار میخواندند (Cold Read) و لحنی یکنواخت داشتند که به مرور زمان دچار انحراف میشد. اما v4 کل متن را میخواند تا بفهمد چه کسی صحبت میکند و هر خط چگونه باید ادا شود. اکنون مدل میتواند دستورات صحنهای داخلی مانند [softly] (به آرامی) یا [laughter] (خنده) را در یک خط متن پردازش کند و این تگهای احساسی را روی هم قرار دهد. برای مثال، کاربر میتواند بنویسد: «[softly] من عصبانی نیستم، [laughter] فقط به نظرم خندهداره» و مدل دقیقاً همین توالی را اجرا میکند.
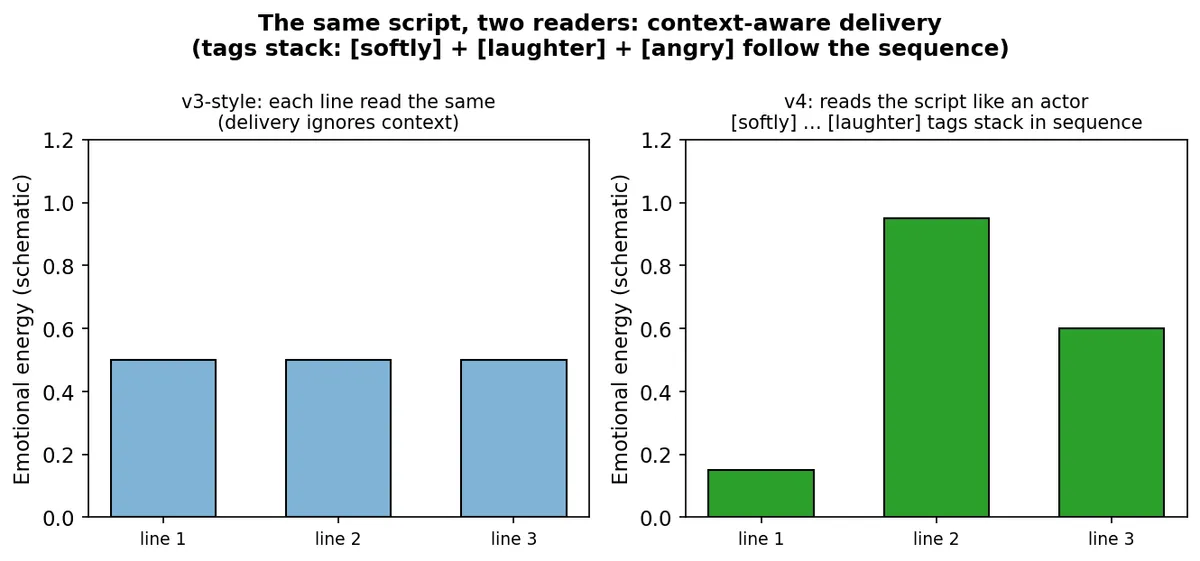
این قابلیت اجازه میدهد انرژی واکنشگرانه و قطع کردن صحبتها (Interruptions) جایگزین نوبتگیریهای خشک و مؤدبانه «الف سپس ب» شود. این ویژگی بهطور خاص بازار NPCهای هوش مصنوعی و دوبله را هدف قرار داده است، جایی که مدلسازی دینامیکهای نوبتگیری یک مسئله پیچیده در تولید است.
تولیدات بلندمدت و صوتی
برای محتواهای طولانی، مدل از «دوخت زمینه» (Context Stitching) استفاده میکند. این یعنی اگر کاربر یک جمله را در فصل ۱۲ یک کتاب صوتی ویرایش کند، خط بازتولیدشده دقیقاً همان هویت صوتی و لحن جملات اطراف را حفظ میکند. این قابلیت سردرد اصلی ویرایش کتابهای صوتی را که در آن هویت صدا اغلب در طول فصلها تغییر میکرد، از بین میبرد.
همچنین سد ورود برای شبیهسازی صدا پایین آمده است؛ اکنون یک شبیهسازی صدای فوری (Instant Voice Clone) تنها با ۱۰ ثانیه صوت ساخته میشود. این پیشرفت در کنار امکان شبیهسازی صدای انسان روی موبایل در کمتر از یک ثانیه، مرزهای دسترسی به فناوریهای کلونینگ صوتی را جابهجا کرده است. در حالی که این موضوع کاربرد بسیار زیادی دارد، اما باعث شده تا حفاظها (Guardrails) — مانند احراز هویت مورد نیاز برای شبیهسازی صدای حرفهای (PVC) — به یک الزام حیاتی برای هر استقرار تبدیل شود.
از منظر فنی، این تغییر معیار سنجش عاملهای صوتی را از «کیفیت صدا» به «بودجه تأخیر» تغییر میدهد. وقتی فاصله بین تولید و گفتار به حداقل میرسد، تأخیر نخستین توکن LLM به گلوگاه اصلی تبدیل میشود، نه سنتز TTS.
این وضعیت فشار شدیدی بر رقبایی چون Cartesia (Sonic 3.6)، OpenAI (GPT-4o mini TTS) و Google (Gemini Flash TTS) و همچنین استارتاپهایی مثل Deepgram, Fish Audio و Boson وارد میکند. ElevenLabs با ترکیب بیانگری بالا و تأخیر زیر ۲۰۰ میلیثانیه، خود را به عنوان زیرساخت «اقتصاد عاملهای صوتی» معرفی میکند؛ جایی که تماسهای سازمانی در حال حاضر بیش از ۵۵٪ کسبوکار این شرکت را تشکیل میدهند. مدل اکنون بهگونهای آموزش دیده است که بتواند رویاروییها، تشدید تنشها و حالتهای انتظار (Hold) را با ظرافت صوتی مناسب مدیریت کند.
توسعهدهندگان اکنون باید به تگهای کارگردانی به عنوان یک زبان برنامهنویسی جدید برای صوت نگاه کنند. توانایی پرامپتنویسی برای احساسات، سرعت خاص و کنترل IPA به این معنا است که مهندسی پرامپت (Prompt Engineering) رسماً وارد دنیای گفتار مصنوعی شده است.
برای مشاهده این دستاوردها در عمل، میتوانید نوتبوک همراه voice_streaming_latency.ipynb را بررسی کنید تا شکاف بین صوت دستهای و استریمشده را در طول جملات مختلف شبیهسازی کنید.
گام بعدی شما
- بررسی نوتبوک
voice_streaming_latency.ipynbبرای شبیهسازی تفاوت میان صوت دستهای و استریمشده. - جایگزینی مدلهای TTS سنتی با v4 Turbo در کاربردهایی که تعامل بلادرنگ (Real-time) اولویت دارد.
- آزمایش تگهای احساسی [softly] و [laughter] برای ارتقای طبیعی بودن NPCها در بازیها.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو