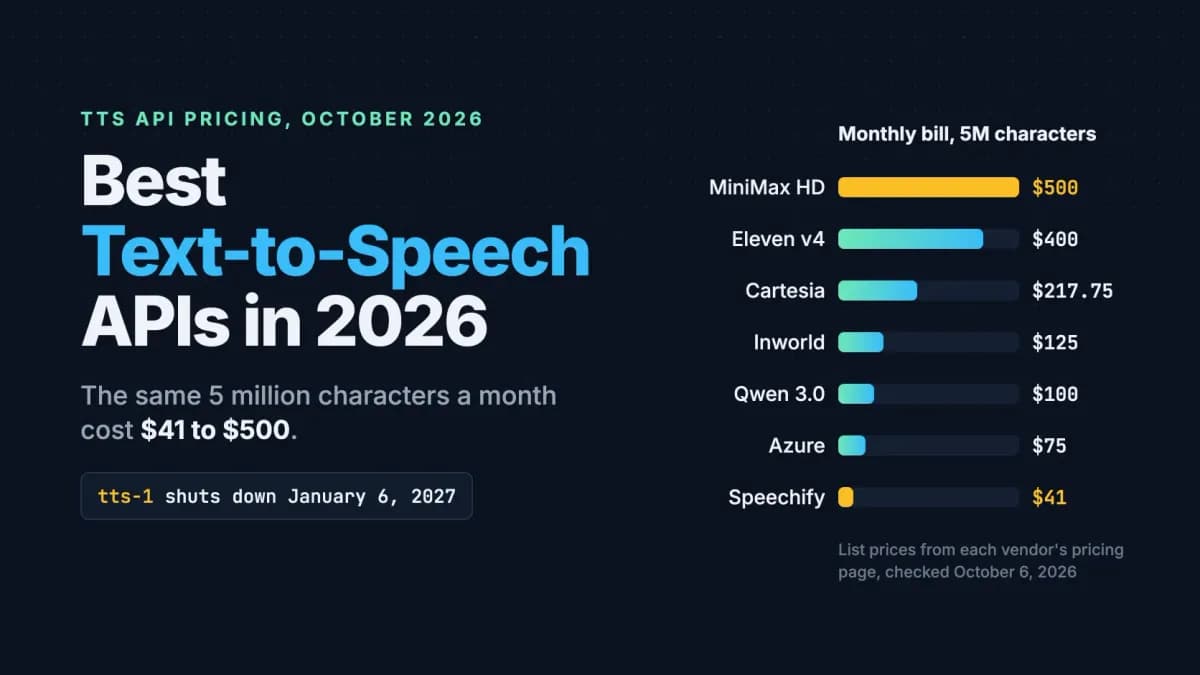
اگر امروز برای سرویسهای تبدیل متن به گفتار هزینه میپردازید، احتمالاً برای کیفیتی پرداخت میکنید که در مدلهای ارزانتر هم یافت میشود. تفاوت قیمت میان مدلهای برتر این حوزه اکنون به ۱۰ برابر رسیده است، در حالی که گوش انسان بهسختی میتواند تفاوت کیفیت آنها را تشخیص دهد. تحلیلهای مربوط به تستهای کور (Blind-test) نشان میدهد که شکاف قیمتی بین ۱۰ مدل برتر، بسیار گستردهتر از شکاف کیفی آنهاست.
انتخاب یک API برای تبدیل متن به گفتار (TTS) — شبیه انتخاب یک گوینده برای رادیو است که باید هم صدای خوبی داشته باشد و هم دستمزدش با بودجه شما همخوانی کند — دیگر یک تصمیم سادهی فنی نیست، بلکه یک محاسبهی مالی است. انتخاب یک API در ابتدا ساده به نظر میرسد، تا زمانی که صورتحساب بر اساس تعداد کاراکترها صادر شود، کاربران متوجه تأخیر (Lag) قبل از شنیدن اولین کلمه شوند، یا مدل کلمات اختصاری مثل «.Dr» را به هر شکلی که دوست دارد بخواند.
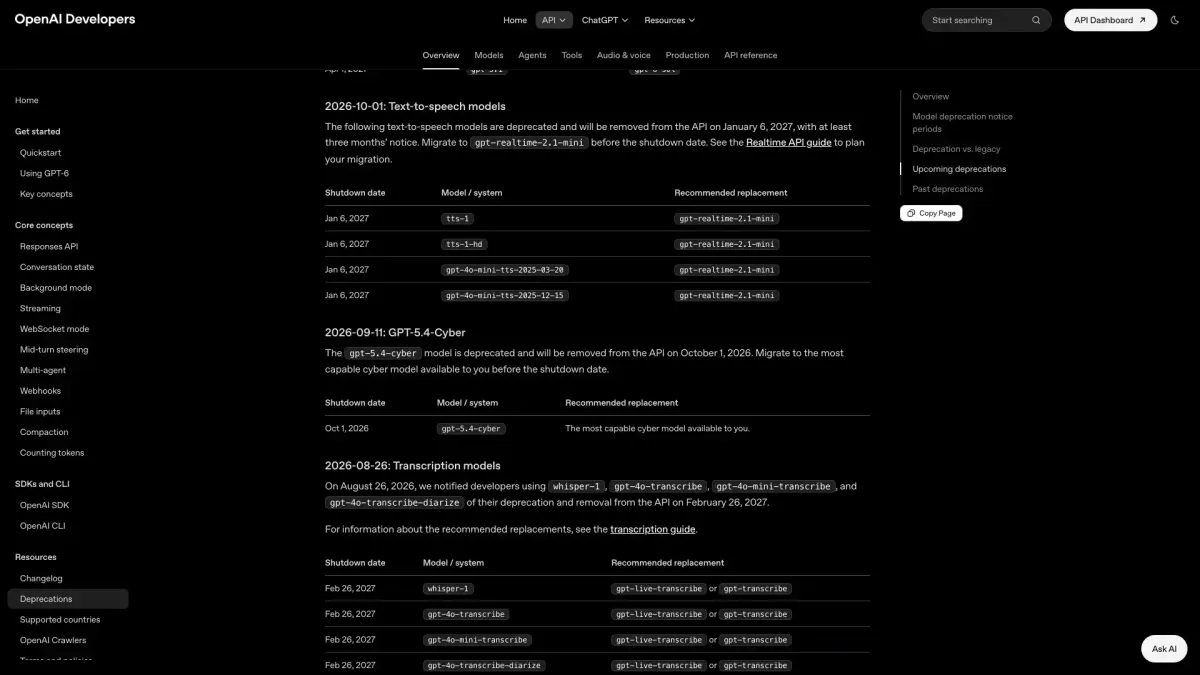
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی هزینههای استنتاج اشاره کردیم، توسعهدهندگان اکنون با یک بحران زمانی مواجهاند. OpenAI در ۱ اکتبر ۲۰۲۶ تمامی مدلهای مربوط به نقطه اتصال /v1/audio/speech را منسوخ کرد و تاریخ ۶ ژانویه ۲۰۲۷ را برای خاموشی کامل تعیین نموده است. این اقدام هزاران برنامه را مجبور میکند تا در بازهای کوتاه، زیرساخت صوتی خود را تغییر دهند. جایگزین این سرویس، مدل gpt-realtime-2.1-mini است که یک مدل Realtime API است. این یعنی جایگزینی درخواستهای ساده REST با نشستهای WebSocket یا WebRTC و تغییر هزینه به ۲۰ دلار بهازای هر میلیون توکن خروجی صوتی.
برای سنجش اثر واقعی این تغییرات، آزمونی با شبیهسازی حجم کاری یک کلینیک در آمریکا اجرا شد: ۵ میلیون کاراکتر در ماه، یا حدود ۳۹ هزار یادآور قرار ملاقات. متن محک یک پیام ۱۲۸ کاراکتری بود: «قرار شما با دکتر پاتل برای سهشنبه ۱۳ اکتبر ساعت ۲:۳۰ بعد از ظهر تأیید شد. مبلغ پرداختی شما ۴۵.۵۰ دلار است. سوالی دارید؟ با شماره (۵۵۵) ۰۱۰-۱۲۳۴ تماس بگیرید.» این بنچمارک نشان میدهد که صورتحسابهای ماهانه بر اساس تعداد کاراکتر (Metered Billing) چقدر میتوانند نوسان داشته باشند.
پیشتازان کیفیت
به نقل از دادههای Voice Arena در ۶ اکتبر ۲۰۲۶، شرکت ElevenLabs دو جایگاه نخست را در اختیار دارد. کیفیت در اینجا بر اساس رتبهبندی Elo و انتخاب کاربران بین دو کلیپ ناشناس تعیین شده است؛ به این صورت که شنوندگان دو کلیپ بینام را میشنوند و یکی را انتخاب میکنند. این فرآیند رتبهبندی Elo را برای ۹۲ مدل ایجاد کرده است. مدل Eleven v4 Turbo با امتیاز ۱۳۳۴ در صدر است و مدل Eleven v4 (منتشر شده در ۲۸ سپتامبر ۲۰۲۶) با امتیاز ۱۳۲۱ در رتبه دوم قرار دارد. هر دو مدل از بیش از ۹۰ زبان و شبیهسازی صدای باکیفیت (High-fidelity voice cloning) پشتیبانی میکنند.
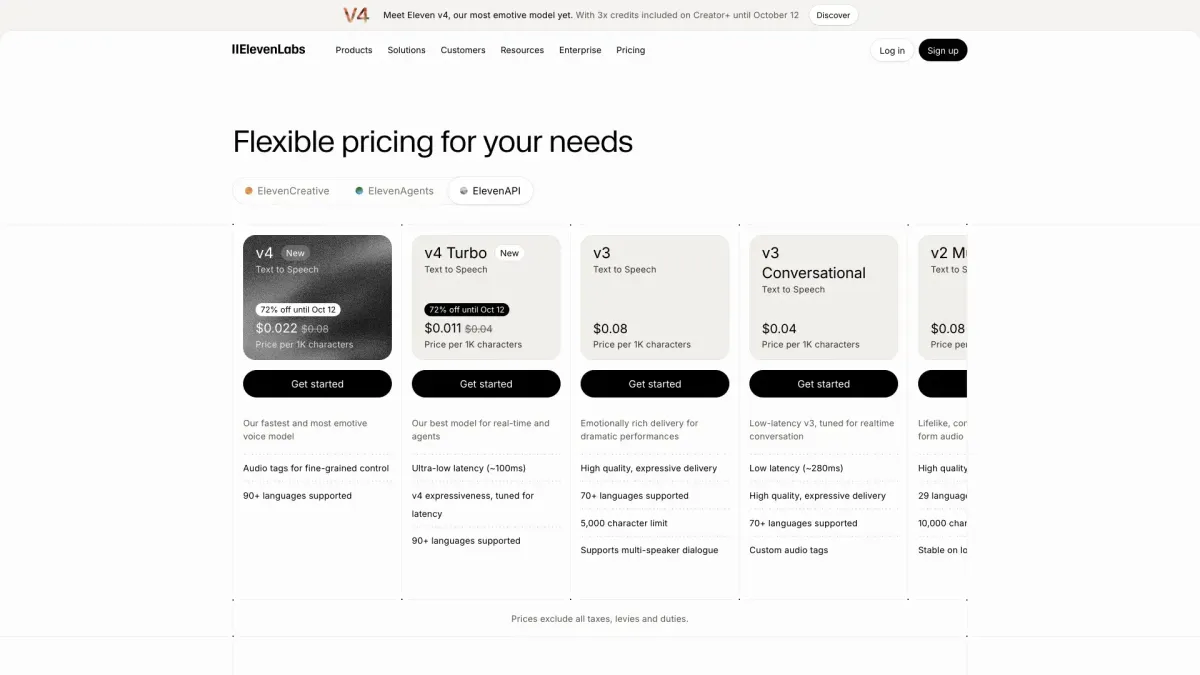
اما این کیفیت هزینهی بالایی دارد. ElevenLabs میانگین استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، مثل خودِ آشپزی و نه دورهی آموزش آشپز — را برای v4 Turbo روی سرورهای خود ۱۰۰ میلیثانیه اعلام کرده است. قیمت هر ۱۰۰۰ کاراکتر برای v4 معادل ۰.۰۸ دلار و برای v4 Turbo و Flash v2.5 معادل ۰.۰۴ دلار است. در نتیجه، هزینه عملیات کلینیک روی v4 حدود ۴۰۰ دلار و روی Turbo حدود ۲۰۰ دلار میشود.
در مقابل، مدل Speechify Simba 3.2 در رتبه هشتم (امتیاز ۱۲۴۲) قرار دارد اما ارزانترین نرخ منتشر شده برای سرویسهای خودکار (Self-serve) را در بین ۱۰ مدل برتر ارائه میدهد. با نرخهای ۱۰ دلار بهازای هر میلیون در طرح Starter، ۸ دلار در Pro و ۶ دلار در Scale، هزینه عملیات کلینیک به ۴۱ دلار کاهش مییابد. Speechify زمان شروع پخش اولین صدا (First-audio times) را ۱۰۶ میلیثانیه روی Coval و ۱۲۳ میلیثانیه روی Voice Arena اعلام کرده است، هرچند دسترسی کاربران عادی در Simba 3.2 به زبان انگلیسی و در Simba 3.0 به شش زبان محدود است.
شکاف در تلفظ و دقت
کیفیت فقط مربوط به لحن نیست، بلکه به دقت هم بستگی دارد. آزمونی روی اعداد، تاریخها و کدها نشان داد که حتی مدلهای برتر در خواندن اختصارات مشکل دارند. برای مثال، اختصار «.Tue» (سهشنبه) توسط چندین مدل به اشتباه عدد «دو» (Two) خوانده شد.
- Eleven v4: امتیاز ۹۱.۷٪ در تستهای تلفظ
- Gemini 3.8 Flash TTS: امتیاز ۸۹.۵٪
- Cartesia Sonic-3.6: امتیاز ۷۴.۵٪ (عقبماندگی قابل توجه)
مدلهای وزنباز (Open Weights) — یعنی مدلهایی که دستور پختشان علناً منتشر شده و نه فقط غذای آماده — مانند Kokoro-82M و Piper نیز در تست «.Tue» شکست خوردند. در اجرای این مدلها روی پردازنده M3 Pro MacBook Pro و تبدیل صوت به متن توسط faster-whisper 1.2.1، مدل Kokoro-82M (نسخه af_heart) تاریخ را به صورت «تأیید شد برای ۲ اکتبر ۱۳» خواند و شماره تلفن را به شکلی نامفهوم و غیرقابل شمارهگیری بیان کرد. مدل Piper (نسخه en_US-lessac-medium) آن را به صورت «تأیید شد برای ۲.۰۰ اکتبر ۱۳» خواند.
برای حل این مشکل، استفاده از یک لایه نرمالسازی با Python Regex ضروری است. نویسنده این تحقیق تابعی را پیاده کرد تا اختصارات روزها (مثلاً Mon به Monday) و ماهها (مثلاً Jan به January) را باز کند و «.Dr» را به «Doctor» تبدیل کند. همچنین شمارههای تلفن آمریکا را طوری فرمت کرد که هر رقم به صورت جداگانه و با مکث بین گروهها خوانده شود. پس از این اصلاحات، هر دو مدل Kokoro و Piper توانستند تاریخها و شمارهها را درست بخوانند.
غولهای ابری و جایگزینها
برای کسانی که با قراردادهای ابری بزرگ در ارتباطاند، گزینهها متفاوت است. مدل Neural HD شرکت Azure AI Speech در رتبه ۲۸ با قیمت ۲۲ دلار بهازای هر میلیون کاراکتر در منطقه East US قرار دارد، در حالی که صدای Neural استاندارد آن در رتبه ۶۸ با قیمت ۱۵ دلار است.
مدل Gemini 3.8 Flash TTS گوگل با امتیاز ۱۲۷۵ در رتبه پنجم است. قیمت این مدل تا ۳۱ دسامبر ۲۰۲۶ بسیار پایین است (۰.۵۰ دلار بهازای هر میلیون توکن متنی ورودی و ۹ دلار بهازای هر میلیون توکن صوتی خروجی)، اما از ۱ ژانویه ۲۰۲۷ قیمتها دو برابر میشوند. سایر گزینههای گوگل مثل Chirp 3 HD در رتبه ۵۸ با قیمت ۳۰ دلار بهازای هر میلیون کاراکتر قرار دارند (اولین میلیون کاراکتر رایگان است).
صداهای مولد (Generative) Amazon Polly در رتبه ۵۳ با قیمت ۳۰ دلار و صداهای Neural آن در رتبه ۹۰ از ۹۲ مدل با قیمت ۱۶ دلار بهازای هر میلیون کاراکتر قرار گرفتهاند.
مدل Inworld TTS-2 (رتبه هفتم، امتیاز ۱۲۵۱) یک مزیت استراتژیک برای مهاجران OpenAI دارد؛ زیرا دقیقاً از همان فرمت درخواست POST /v1/audio/speech استفاده میکند. توسعهدهندگان میتوانند تنها با تغییر آدرس API به https://api.inworld.ai/v1 و تغییر نام مدل به inworld-tts-2 سیستم خود را منتقل کنند. هزینه این سرویس ۲۵ دلار بهازای هر میلیون کاراکتر در حالت On-demand است یا ۱۷.۵۰ دلار در طرح Builder (با هزینه ۱۰۰ دلار). هزینه عملیات کلینیک در این مدل ۱۲۵ دلار در حالت On-demand یا مبلغ ثابت ۱۰۰ دلار در طرح Builder است.
مدلهای تخصصی و حاشیهای
خارج از لیست ۱۰ مدل برتر، توازنهای متفاوتی وجود دارد:
- Alibaba Qwen-Audio: مدل Qwen-Audio-3.1-TTS-Plus در رتبه سوم (امتیاز ۱۲۹۲) است اما فاقد منطقه آمریکا است و فقط در پکن و سنگاپور در دسترس است. مدل 3.0 Plus در سنگاپور ۰.۲۰ دلار بهازای هر ۱۰,۰۰۰ کاراکتر هزینه دارد که هزینه عملیات کلینیک را به ۱۰۰ دلار میرساند.
- Cartesia Sonic-3.6: رتبه چهارم (امتیاز ۱۲۷۸) با تأخیر زیر ۹۰ میلیثانیه. این مدل قابلیت «تثبیت مدل» (Model Pinning) را دارد، به این معنی که اسنپشاتهای
sonic-3.6-YYYY-MM-DDهرگز تغییر نمیکنند. هزینه عملیات کلینیک در طرح Startup (۴۹ دلار در ماه برای ۱.۲۵ میلیون اعتبار) معادل ۲۱۷.۷۵ دلار است. - MiniMax Speech 2.8 HD: رتبه ۱۹ اما گرانترین مدل با قیمت ۱۰۰ دلار بهازای هر میلیون کاراکتر (۵۰۰ دلار برای عملیات کلینیک). این مدل از درخواستهای async طولانی تا ۱ میلیون کاراکتر و شبیهسازی سریع صدا با قیمت ۱.۵۰ دلار پشتیبانی میکند.
- Fish Audio S2.1 Pro: رتبه ۲۴ با قیمت ۱۵ دلار بهازای هر میلیون بایت UTF-8. در متون انگلیسی ساده هزینه حدود ۷۵ دلار است، اما در متون CJK (چینی، ژاپنی، کرهای) یا متون دارای Accent، تعداد بایتها و در نتیجه هزینه افزایش مییابد.
- Deepgram Flux TTS: منتشر شده در ۱۲ اوت ۲۰۲۶. این مدل کل تماس را در زمینه (Context) نگه میدارد و گزارش میدهد که کاربر هنگام وقفهها چه چیزی شنیده است. مدل Aura-2 هزینه ۰.۰۳۰ دلار و Flux TTS هزینه ۰.۰۴۵ دلار بهازای هر ۱۰۰۰ کاراکتر دارد.
- Rime: مدل Coda (رتبه ۵۵) هزینه ۰.۰۵ دلار و مدل Mist v3 هزینه ۰.۰۳ دلار بهازای هر ۱۰۰۰ کاراکتر دارد.
- Hume Octave 2: رتبه ۶۱، اما برای قیمتگذاری نیاز به استعلام مستقیم دارد زیرا صفحه قیمتها به صفحه اصلی منتقل میشود.
موازنه مدلهای وزنباز
اجرای مدلهای محلی، صورتحسابهای ماهانه را با مدیریت زیرساخت جایگزین میکند. مدل Kokoro-82M (رتبه ۵۴) تحت لایسنس Apache 2.0 است. مدل Piper روی پردازنده CPU حدود ۴۰ برابر سریعتر از زمان واقعی اجرا شد، اما مخزن اصلی MIT آن در ۶ اکتبر ۲۰۲۵ آرشیو شد و اکنون تحت لایسنس GPL-3.0 با نام piper1-gpl ادامه مییابد. هر دو مدل از espeak-ng (GPL-3.0) استفاده میکنند.
سایر گزینهها شامل Chatterbox (MIT) و Orpheus (Apache 2.0) هستند. با این حال، مدلهای رتبهبالای وزنباز مانند Breeze TTS 2 (رتبه ۱۱) و Fish Audio S2 Pro محدود به استفاده پژوهشی و غیرتجاری هستند و برای کاربردهای تجاری مثل کلینیک مناسب نیستند. این روند بهینه سازی مدلها با پیشرفتهای اخیر در شبیهسازی صدای انسان روی موبایل همسو است که امکان اجرای سریعتر مدلها را فراهم کرده است.
تحلیل: چرخش به سمت ارزش
برای یک توسعهدهنده، نتیجه این است که «سقف کیفیت» لمس شده است. تفاوت بین رتبه اول و هشتم برای اکثر کاربران غیرقابل تشخیص است، اما تفاوت هزینه تقریباً ۱۰ برابر است. مدل Simba 3.2 در رتبه هشتم است اما هزینه آن یکدهم Eleven v4 است.
ما از عصر «یافتن صدایی که انسانی به نظر برسد» به عصر «بهینهسازی هزینه بهازای هر کاراکتر» وارد شدهایم. برندگان سال ۲۰۲۶ مدلهایی هستند که کیفیت «به اندازه کافی خوب» را با ظرفیت پردازشی بالا (High-concurrency caps) و قیمت پیشبینیپذیر ارائه میدهند.
اگر از نقاط اتصال قدیمی OpenAI استفاده میکنید، زمان شما در حال اتمام است. انتقال به Realtime API، درخواستهای ساده را با WebSocket جایگزین میکند و هزینه را به ۲۰ دلار بهازای هر میلیون توکن خروجی میرساند. مدل tts-1 تا تاریخ ۶ ژانویه با قیمت ۱۵ دلار بهازای هر میلیون کاراکتر باقی میماند.
برای جلوگیری از مهاجرت دوباره، توسعهدهندگان باید از اسنپشاتهای تاریخدار مدلها استفاده کنند و نقاط اتصال سازگار با OpenAI یا مدلهای وزنباز را ترجیح دهند. قبل از انتخاب تأمینکننده، اسکریپتهای واقعی یک ماه اخیر خود (شامل SSML) را استخراج کرده و تعداد کاراکترها را دقیقاً محاسبه کنید. سختترین رشتههای متنی خود (نام داروها، کدهای سفارش و تاریخها) را از یک لایه نرمالسازی عبور دهید و آنها را روی سه مدل کاندید در منطقه استقرار واقعی خود (مثلاً us-east-1) تست کنید، زیرا تأخیر اعلامی شرکتها در سمت سرورهای آنهاست، نه در سمت شما.
گام بعدی شما
- اسکریپتهای واقعی یک ماه اخیر خود را استخراج کرده و تعداد کاراکترها را دقیقاً محاسبه کنید.
- سختترین رشتههای متنی خود (نام داروها، کدهای سفارش و تاریخها) را از یک لایه نرمالسازی عبور دهید.
- سه مدل کاندید را در منطقه استقرار واقعی خود (مثلاً us-east-1) تست کنید، زیرا تأخیر اعلامی شرکتها همیشه با واقعیت کاربر متفاوت است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو