
تصور کنید در محیطی سازمانی هستید که نشت دادههای حساس مشتریان (PII) باید به صفر برسد و هزینهها دقیقاً رصد شوند، اما استقرار یک کلاستر دیتابیس کامل به دلیل پیچیدگی یا محدودیتهای بودجهای کاملاً غیرممکن است. ابزار enterprise-claude-kit که در ۱۳ سپتامبر ۲۰۲۶ منتشر شد، با رویکرد «صفر-زیرساخت» (Zero-Infra) این مشکل را حل میکند و به توسعهدهندگان اجازه میدهد API مدل Claude شرکت Anthropic را تنها با یک دستور pip install در یک لایهی حاکمیتی سختگیرانه محصور کنند.
بسیاری از SDKهای هوش مصنوعی برای سرعت طراحی شدهاند، نه برای انطباق با قوانین (Compliance). این ابزارها اجازه میدهند در یک بعدازظهر قابلیتهای جدیدی را عرضه کنید، اما در بخش گزارشهای حسابرسی و کنترل هزینهها حفرههای بزرگی میگذارند. همانطور که در تحلیل قبلی ما دربارهی آزمایشهای Claude Code دیدیم که در آن عاملها بدون حفاظهای مالی سختگیرانه عمل میکردند، این ابزار اکنون نقش یک «افسر انطباق» را مستقیماً وارد بدنه کدنویسی میکند.
سناریوی خطرناکی را تصور کنید که در آن یک برنامهنویس بهطور اتفاقی شماره تأمین اجتماعی (SSN) یک مشتری را به یک API شخص ثالث میفرستد. در یک ساختار استاندارد، این دادهها ارسال شده و برای همیشه از دست میروند. اما با این لایهی حاکمیتی، درخواست پیش از آنکه محیط محلی را ترک کند، توسط سیستم رهگیری شده و متوقف میشود.
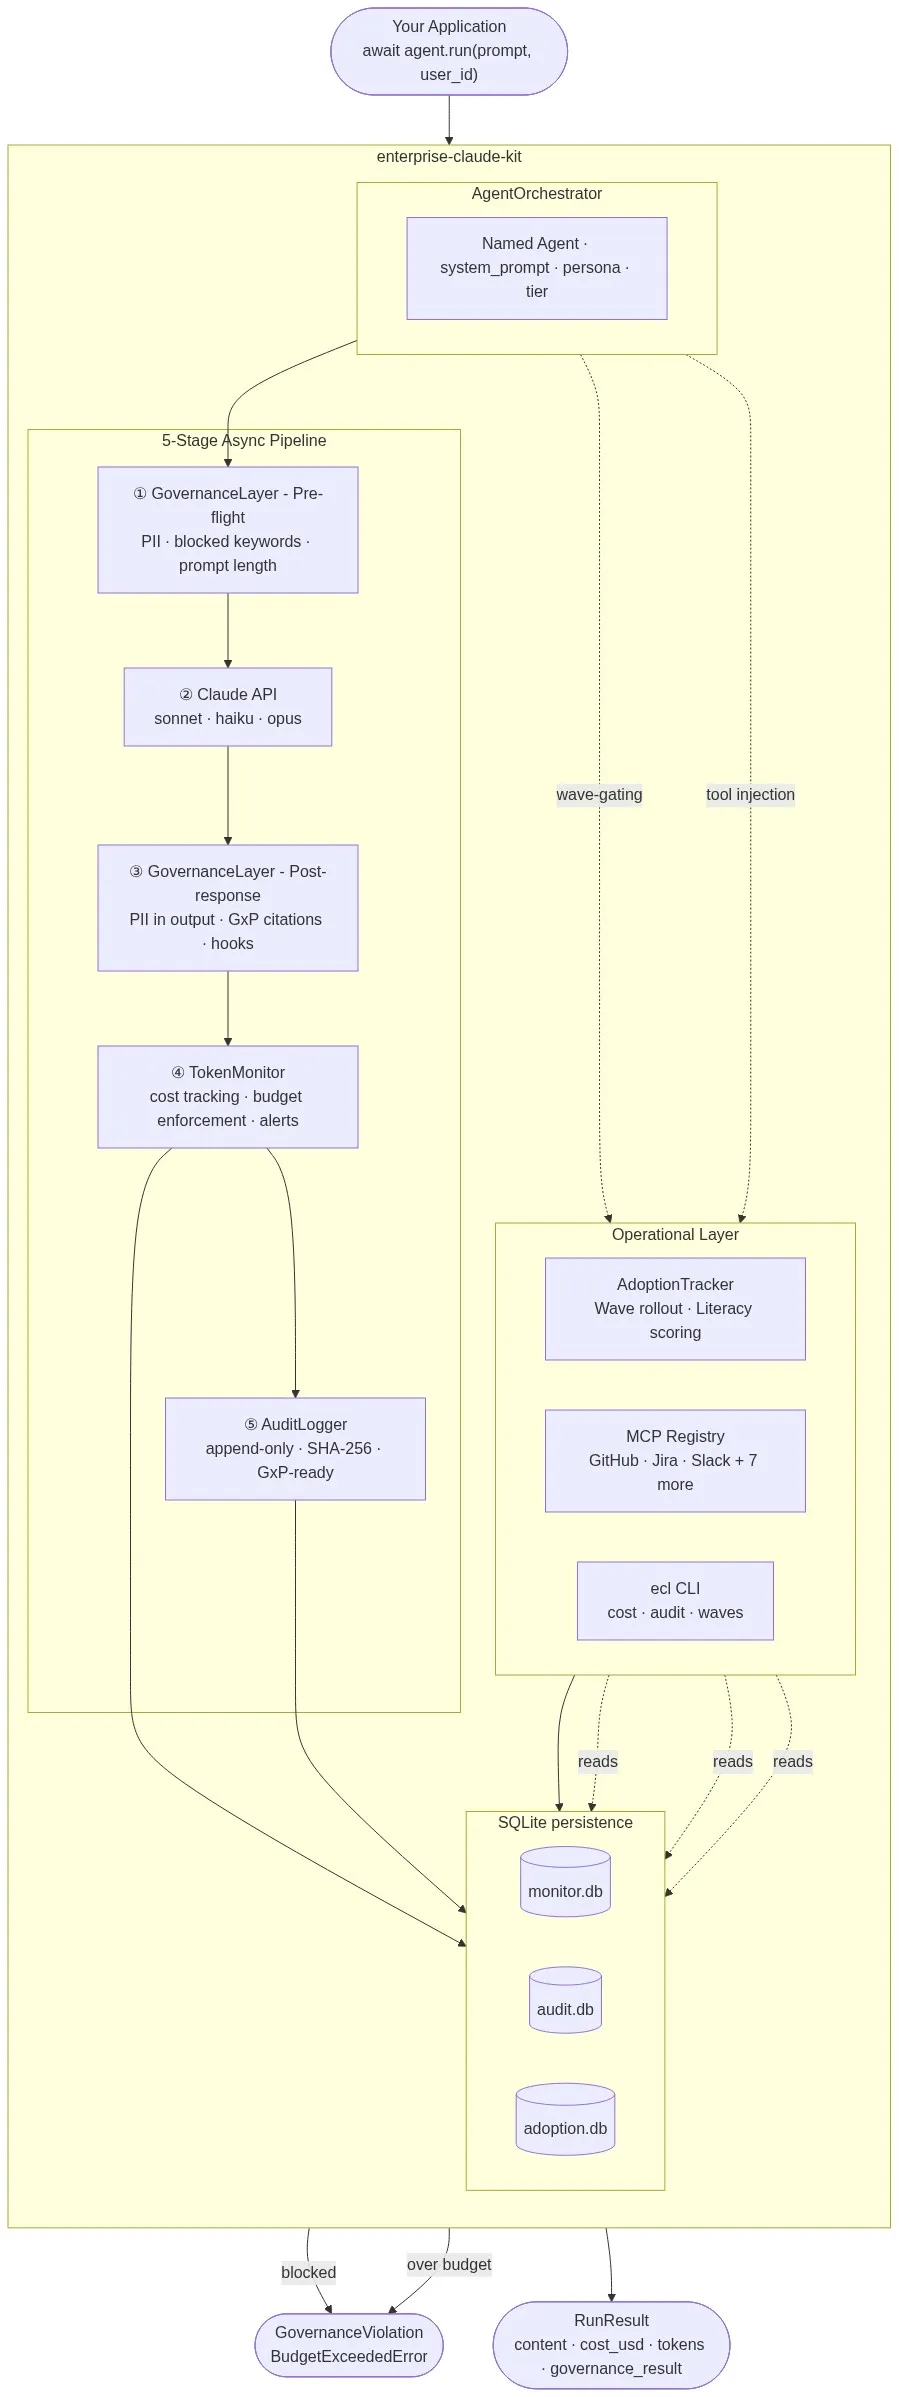
خط لولهی حاکمیتی پنجمرحلهای
طبق مستندات این ابزار، هر فراخوانی API که توسط این کیت پردازش میشود، از یک توالی سختگیرانه برای تضمین ایمنی و پاسخگویی عبور میکند. این فرآیند به دلیل پردازش درون-برنامهای (In-process)، تأخیری در حد تکرقمی میلیثانیه دارد و سرعت سیستم را کاهش نمیدهد:
- حاکمیت پیشپرواز (Pre-flight Governance): اسکن برای دادههای حساس (PII)، کلمات کلیدی مسدودشده (مانند «MNPI» یا «محرمانه») و اعمال محدودیتهای طول پرامپت (مثلاً تنظیم
max_prompt_lengthروی ۵۰,۰۰۰ توکن). - اجرای API: انجام فراخوانی واقعی API مدل Claude از طریق متد
anthropic.AsyncAnthropic.messages.create(). - حاکمیت پس از پاسخ (Post-response Governance): بررسی خروجی مدل برای یافتن دادههای حساس یا نبودِ استنادهای لازم (بهویژه در حالت GxP).
- پایش توکن (Token Monitoring): محاسبه لحظهای هزینهها و اجرای سختگیرانه بودجههای روزانه.
- ثبت حسابرسی (Audit Logging): ایجاد یک رکورد تغییرناپذیر با هش SHA-256 از کل رویداد برای مراجعات بعدی.
ایمنی مبتنی بر Regex و قابلیت حسابرسی
به نقل از توسعهدهنده، برای تشخیص دادههای حساس (PII) — که مثل یک فیلتر امنیتی در ورودی ساختمان است — بهجای استفاده از مدلهای هوش مصنوعی دیگر یا مدلهای NER مانند spaCy، از الگوهای Regex کامپایلشده استفاده شده است. این تصمیم استراتژیک تضمین میکند که افسران انطباق بتوانند قوانین تشخیص را به عنوان یک «قرارداد» بخوانند، نه اینکه به توزیع احتمالی یک مدل سیاهباکس اعتماد کنند. وقتی یک ناظر قانونی بپرسد تشخیص دادههای حساس چگونه کار میکند، پاسخ یک خط کد خواناست، نه وزنهای پیچیده یک شبکه عصبی.
این سامانه بهطور خاص پنج الگوی کلیدی را هدف قرار میدهد:
- ایمیلها: فرمتهای استاندارد پست الکترونیک.
- شماره تلفنها: فرمتهای داخلی و بینالمللی.
- SSN: شمارههای تأمین اجتماعی.
- کارتهای اعتباری: توالیهای ۱۳ تا ۱۶ رقمی.
- IPv4: فرمتهای استاندارد آدرس IP.
اگر دادههای حساس در یک پرامپت شناسایی شوند، سیستم خطای GovernanceViolation صادر کرده و فراخوانی را بهطور کامل متوقف میکند. اما اگر این دادهها در پاسخ مدل ظاهر شوند، فقط علامتگذاری (Flag) میشوند و خطا صادر نمیشود، زیرا فراخوانی API پیشتر رخ داده و هزینه آن کسر شده است.
بودجهبندی و پایداری دادهها
برخلاف شمارندههای حافظهای (In-memory) که با کرش کردن سیستم یا ریاستارت شدن ریست میشوند، TokenMonitor از SQLite — که شبیه به یک دفترچه یادداشت کوچک و سریع در کنار برنامه است — برای ذخیره سوابق استفاده میکند. هر فراخوانی با برچسب زمان، شناسه عامل (Agent ID)، مدل، پرسونای مورد استفاده، توکنهای ورودی/خروجی و هزینه نهایی به دلار ثبت میشود.
این ساختار اجازه میدهد بودجهها پس از هر بار راهاندازی مجدد از دیتابیس بازخوانی و بازمحاسبه شوند. کاربران میتوانند بودجه روزانه (مثلاً daily_budget_usd = 100.00) تعیین کنند و از طریق هوک @monitor.on_alert هشدارها را تنظیم کنند؛ برای مثال، میتوان تنظیم کرد که وقتی هزینه به ۸۰٪ سقف بودجه رسید (alert_threshold_pct=0.80)، یک اعلان به Slack ارسال شود.
ثبت وقایع تغییرناپذیر
برای صنایع تحت نظارت شدید، AuditLogger سه قانون سختگیرانه را برای حفظ یکپارچگی ردپای دادهها اجرا میکند:
- فقط افزودنی (Append-only): در هیچ کجای کدبیس دستورات
UPDATEیاDELETEوجود ندارد تا امکان دستکاری سوابق از بین برود. - چکسام SHA-256: هر رویداد از یک چکسام بر اساس JSON استاندارد با کلیدهای مرتبشده (Canonical JSON) استفاده میکند.
- هش کردن هویت: شناسههای کاربران به صورت
SHA-256(user_id)ذخیره میشوند تا ایمیلهای خام هرگز در لاگهای حسابرسی ذخیره نشوند و حریم خصوصی حفظ شود.
در حالت GxP — که برای استانداردهای داروسازی مانند 21 CFR Part 11 طراحی شده — سیستم بررسی استناد (Citation Check) را اضافه میکند. در این حالت، مدل باید حتماً نشانگرهایی مثل [SOURCE:] یا [REF:] یا [CITATION:] را در پاسخ بگنجاند، در غیر این صورت خروجی به عنوان «غیرمنطبق» علامت میخورد.
استقرار کنترلشده و اتصالها
این کیت شامل یک AdoptionTracker است که عرضه ابزار را در «موجهای» (Waves) مختلف با دروازههای سخت مدیریت میکند. این کار از مقیاسدهی زودهنگام و ریسکی جلوگیری میکند و در صورت عدم رعایت شرایط، خطای WaveGateError صادر میکند. برای مثال، یک شرکت میتواند موجی برای «معماران» و موجی برای «توسعهدهندگان» ایجاد کند. موج توسعهدهندگان تا زمانی که موج معماران به آستانه پذیرش خاصی (مثلاً ۸۰٪) نرسد، فعال نخواهد شد. این رویکرد برای بهینهسازی نرخ پذیرش ابزارها مشابه راهکاری است که AIWave برای حل مشکل «صفر کاذب» در جذب توسعهدهندگان به کار گرفت.
برای اندازهگیری میزان تعامل واقعی، این ردیاب «امتیاز سواد» (Literacy Score) را در مقیاس ۰ تا ۱۰۰ و بر اساس لگاریتم تعداد فراخوانیها محاسبه میکند: log10(calls + 1) / log10(101) * 100.
برای کاهش کدهای تکراری (Boilerplate)، یک رجیستری MCP با ۱۰ کانکتور پیشساخته ارائه شده است:
- ارتباطات: Slack، Teams.
- مدیریت پروژه: Jira، GitHub.
- پایگاههای دانش: Confluence، SharePoint.
- داده/CRM: PostgreSQL، Salesforce، ServiceNow.
- محلی: سیستم فایل محلی (Local filesystem).
موازنه معماری
نویسنده ابزار بهطور صریح از استفاده از LangChain پرهیز کرده تا از تورم وابستگیها (بیش از ۵۰ وابستگی غیرمستقیم) و لایههای انتزاعی که فراخوانیهای مستقیم API را میپوشانند و عیبیابی را سخت میکنند، جلوگیری کند. با فراخوانی مستقیم API شرکت Anthropic، این کتابخانه از وابستگی به نسخههای خاص یک فریمورک رها میشود. این سختگیری در معماری برای حذف شکافهای منطقی، یادآور استراتژی اجبار به استفاده از TypeScript در Toolcrib است تا از توهمات کدنویسی جلوگیری شود.
همچنین استفاده از SQLite بهجای PostgreSQL باعث شده ابزار «صفر-زیرساخت» باقی بماند و نیازی به Redis یا کانتینرهای Sidecar نباشد. با این حال، برای مقیاسهای بسیار بزرگتر، امکان مهاجرت به PostgreSQL از طریق asyncpg و استفاده از متد ATTACH DATABASE فراهم شده است.
علاوه بر این، پیکربندیهای Pydantic در این کیت منجمد (Frozen) هستند. اگر پس از تنظیم GovernanceConfig کسی بخواهد قانونی را (مثلاً pii_filter = False) در حین اجرای برنامه تغییر دهد، خطای ValidationError رخ میدهد تا قوانین حاکمیتی در طول زمان اجرا دچار انحراف (Drift) نشوند.
مدیریت و استقرار
برای کنترل عملیاتی، یک CLI به نام ecl ارائه شده که مدیریت سیستم را بدون نیاز به نوشتن کد ممکن میکند. دستورات در دسترس عبارتند از:
ecl cost summary --days 7: ارائه جزئیات هزینهها به تفکیک مدل و پرسونا در ۷ روز گذشته.ecl audit export --format csv: استخراج ردپای تغییرناپذیر برای ارائه به بازرسان.ecl waves list: نمایش نوار پیشرفت برای موجهای استقرار فعلی.ecl connectors validate: بررسی وضعیت متغیرهای محیطی برای ۱۰ کانکتور موجود.
این چرخش به سمت «حاکمیت بهمثابه کد» (Governance-as-Code) به این معناست که انطباق دیگر یک چکلیست اداری پس از اجرا نیست، بلکه یک دروازه سخت در خط لوله اجراست. برای توسعهدهنده، این ابزار اصطکاک مذاکره با تیمهای امنیتی را از بین میبرد، زیرا یک ردپای شفاف و قابل حسابرسی از هر توکن مصرف شده ارائه میدهد.
در بلندمدت، این رویکرد نشان میدهد که فاز بعدی هوش مصنوعی سازمانی، نه درباره پرامپتهای بهتر، بلکه درباره «پوششهای» (Wrappers) بهتر است. ارزش از هوشمندی مدل به سمت قابلیت اطمینان و حاکمیت محیط پیرامون آن جابهجا میشود.
برای شروع، میتوانید مخزن این پروژه با لایسنس MIT را در گیتهاب بررسی کنید یا پکیج را از طریق PyPI نصب کرده و نمونههای عاملهای تحت حاکمیت را تست کنید.
گام بعدی شما
- مخزن MIT-licensed این پروژه را در گیتهاب بررسی کنید تا با پیادهسازی Regexها آشنا شوید.
- اگر از API مدل Claude استفاده میکنید، پکیج را از PyPy نصب کرده و نمونههای عاملهای تحت حاکمیت را تست کنید.
- استراتژی «موجهای استقرار» (Wave Rollouts) را برای کاهش ریسک در محیطهای عملیاتی خود پیاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو