تصور کنید یک برنامهنویس ارشد را استخدام کردهاید که هر ۱۰ دقیقه از شما میپرسد «آیا این بخش درست است؟» یا «حالا چه کنم؟». این دقیقاً همان نقطهای است که بهرهوری عاملهای هوش مصنوعی متوقف میشود. در حالت عادی، یک عامل کدنویسی تسک را تمام میکند، خلاصهای مینویسد و متوقف میشود؛ سپس کاربر مجبور است به صورت دستی تایپ کند «خوب است، حالا تستها را بگیر» تا تکانه و سرعت کار حفظ شود. این یعنی کاربر مجبور است برای پیشبرد کار، مدام پیامهای اداری ساده بفرستد.
Favur برای حل این مشکل، سیستمی به نام هارنس (Harness) معرفی کرده است؛ برنامهای که مثل یک مدیر پروژه سختگیر، تمام کارهای حسابداری و گزارشدهی را بر عهده میگیرد تا انسان دیگر مجبور نباشد برای انتقال عامل از یک مرحله به مرحله بعد، دستی پیام بفرستد. در واقع، اکثر پیامهایی که ما به عاملها میفرستیم — تصمیمات استراتژیک نیستند، بلکه صرفاً بهروزرسانیهای اداریاند. این پیامها به عامل میگویند که وضعیت کار کجاست، مرحله بعدی چیست و «پایان» برای یک قطعه خاص از کار به چه معناست. در حالی که معمولاً انسانها این کار را انجام میدهند، برنامهای که در حال اجرای تسک است، در حال حاضر هر سه مورد از این اطلاعات را در اختیار دارد.
اگر یک جلسه طولانی با یک عامل را باز کنید و فقط پیامهای خودتان را بخوانید، آنها به دو دسته تقسیم میشوند. دسته کوچک شامل تصمیماتی است که نیاز به انسان داشت، مانند تغییر در محدوده پروژه (Scope) یا انتخاب بین دو طراحی مختلف. اما دسته بزرگ، صرفاً حسابداری است: «ادامه بده»، «آن بخش تمام شد، برو سراغ پارسر»، «قبل از اینکه بگویی تمام شده، لینتر (Linter) را اجرا کن» یا «هنوز دو تست شکستخورده داری». هر خط در این دسته بزرگ، چیزی را بازگو میکند که یک برنامه میتواند از سوابق خودش بخواند. لیست تسکها میداند چه چیزی تمام شده، اجراکننده تست میداند چه چیزی شکست خورده و گردش کار (Workflow) میداند مرحله بعدی کدام است.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت و پایداری مدلهای عاملمحور اشاره کردیم، وابستگی شدید به دخالت انسانی در مراحل گذار، مقیاسپذیری این سیستمها را دشوار میکند. این چالش با مشکل یکپارچگی وضعیت در مقیاس بالا که پیشتر بررسی کردیم، همسو است و نشان میدهد چرا دفاتر کل تغییرناپذیر برای توقف چرخههای تصمیم ضروری هستند. طبق گزارشی که در ۱۳ اکتبر ۲۰۲۶ منتشر شد، سیستم هارنس در پشت Favur Evals در یک اجرای عمومی، ۶۰۷ پیام را بهجای کاربر ارسال کرد؛ یعنی در تمام این مدت، هیچ انسانی تایپ نکرد. این پیامها حتی لحن متغیر داشتند؛ در اواخر یک جلسه، پیامهای حسابداری کوتاه میشوند. پیامی مثل «تو قبلاً این را بررسی کردی» هنوز هم فقط یک پیام حسابداری است؛ این پیام حقیقتی را گزارش میکند که عامل زمان زیادی را در یک نقطه صرف کرده است، حقیقتی که یک برنامه میتواند آن را بشمارد.
شکست پرامپتهای سیستمی
بسیاری از توسعهدهندگان سعی میکنند ردیابی وضعیت را در پرامپت سیستمی (System Prompt) — دستورالعملهای بنیادینی که رفتار کلی مدل را تعیین میکند — بگنجانند. اما Favur دو دلیل فنی برای شکست این روش میآورد:
اول اینکه پرامپتی که وضعیت را حمل میکند، باید با هر درخواست بازسازی شود. وقتی عامل از مرحله ۳ به ۴ میرود، متن مربوط به مرحله ۳ حذف و با متن مرحله ۴ جایگزین میشود. در نتیجه، مدل میبیند که در کجا قرار دارد، اما هیچ سوابقی از اینکه چگونه به اینجا رسیده است ندارد. این رویکرد در تضاد با راهکارهای جدید OGAD برای مدیریت محیطهای کاری است که تلاش میکند تکرار دستورات در پرامپتهای سیستمی را به حداقل برساند.
دوم اینکه تغییر مداوم پرامپت در هر نوبت، قابلیت کش پیشوند (Prefix Caching) — سیستمی شبیه به حافظه موقت که بخشهای تکراری متن را از بالا به پایین تطبیق میدهد و در اولین تفاوت متوقف میشود — را از بین میبرد. اگر وضعیت در ابتدای پرامپت قرار گیرد، سیستم مجبور است تقریباً تمام محتوای زیر آن را دور بریزد و دوباره پردازش کند.
به همین دلیل، هارنس بهروزرسانیها را بهصورت پیامهای کاربر ارسال میکند. این کار یک ژورنال دائمی از پیشرفت کار میسازد که به انتهای گفتگو اضافه میشود و باقی میماند، در حالی که پرامپت سیستمی ثابت میماند و فقط نقش، استانداردها و کلیات گردش کار را نگه میدارد.
چهار لحظه مداخله
هارنس Favur بهصورت تصادفی صحبت نمیکند، بلکه در چهار لحظه خاص «گزارش پیشرفت» تولید میکند:
- توقف و انتظار (Stop-and-Wait): وقتی مدل فقط با متن ساده جواب میدهد و هیچ ابزاری را فراخوانی نمیکند.
- عبور از مفصل (Joint Crossing): وقتی عامل یک واحد از کار خود را شروع یا تمام میکند (عبور از یک مفصل در جریان کاری).
- بازگشت از تفویض (Delegation Return): وقتی عاملی که به او کار سپرده شده بود، با نتیجه بازمیگردد.
- اخبار خارجی (External News): وقتی اتفاقی خارج از گفتگو رخ میدهد، مثل تغییر امتیاز توسط یک عامل نظارتی، اعلان توقف (Stall notice) یا یادداشت یک انسان.
نکته مهم این است که هارنس بعد از فراخوانیهای عادی ابزار سکوت میکند. اگر خواندن یک فایل یا یک دستور شل (Shell) نتیجه را برگرداند، مدل مستقیماً از آن نتیجه به اقدام بعدی میرود، بدون اینکه گزارشی در این میان دخالت کند.
کالبدشکافی یک گزارش پیشرفت
هر گزارش، معیارهای ورود و خروج دقیقی را برای عامل تعریف میکند. برای مثال در مرحله «مقداردهی زمینه» (مرحله ۴)، گزارش مشخص میکند:
- معیار ورود: تایید معماری.
- معیار خروج: ایجاد ۶ سند زمینه.
- دستورالعمل: ۶ سند را بساز و دوباره هر ۶ مورد را بخوان تا مطمئن شوی خالی نیستند.
این گزارش صراحتاً میگوید که برای پیشروی باید ابزار تکمیل مرحله را در صورت موفقیت، همراه با شواهد فراخوانی کند. اگر عامل نتواند پیش برود، به او گفته میشود که ابزار را با مقدار «موفقیت = غلط» فراخوانی کند. گزارش به عامل هشدار میدهد که پیش از برآورده شدن معیارهای خروج، ابزار را به صورت حدسی فراخوانی نکند.
این گزارشها همچنین شامل بخشهای پویایی هستند که فقط در صورت مرتبط بودن ظاهر میشوند:
- بخش خطاها: این بخشها فقط زمانی ظاهر میشوند که خطاهای فعالی وجود داشته باشد.
- سوالات باز و دستورالعملهای جاری: فقط زمانی ظاهر میشوند که چیزی برای گفتن وجود داشته باشد.
- شمارندههای نقص (Fault Counters): برخی عاملها تعداد شکستهای خاص را میشمارند، مثلاً تفویضی که اشتباه پیش رفته است. وقتی شمارنده به حد مجاز برسد، گزارش به عامل میگوید که بهجای تلاش مجدد، مشکل را به سطح بالاتر ارجاع دهد.
- قوانین خاص نقش: گزارش یک عامل تست مجدداً تأکید میکند که او نمیتواند کد را اصلاح کند و سه شکست یکسان به معنای لزوم ارجاع (Escalate) است.
با چاپ این قوانین در جدیدترین پیام، هارنس تضمین میکند که مدلی که در یک تسک طولانی غرق شده، دستورالعملهایی را که مدتها پیش خوانده است، فراموش نکند.
شکستن حلقه با «اعلانهای توقف»
یکی از سختترین چالشها در هوش مصنوعی عاملمحور، «چرخ زدن» (Circling) است؛ جایی که عامل مدام فایلهای یکسانی را میخواند بدون اینکه پیشرفتی کند. چون در این حالت مدل «متوقف و منتظر» نیست، سه محرک اول فعال نمیشوند. Favur این مشکل را نه با تحلیل متن، بلکه با شمارش نوبتها حل میکند. این رویکرد یادآور سیستم ویکیِ حافظه در JackHamr است که با ثبت تجربیات برای جلوگیری از تکرار اشتباهات، مانع از گیر افتادن عاملها در حلقههای بیحاصل میشود.
بعد از ۱۵ چرخه بدون پیشرفت در یک مرحله، هارنس اعلانی سه بخشی میفرستد:
۱. شمارش فعلی و نام مرحله.
۲. هشدار مستقیم: «توقف در بازخوانی فایلها و اجرای دستورات تکراری. هر چه نیاز داشتی در اختیار داری»، و سپس شواهدی از آنچه مرحله هنوز بدهکار است.
۳. «در دوم»: دستور برای گزارش شکست با هر آنچه تا کنون یافته است و تأکید بر اینکه «دیگر جستوجو نکن».
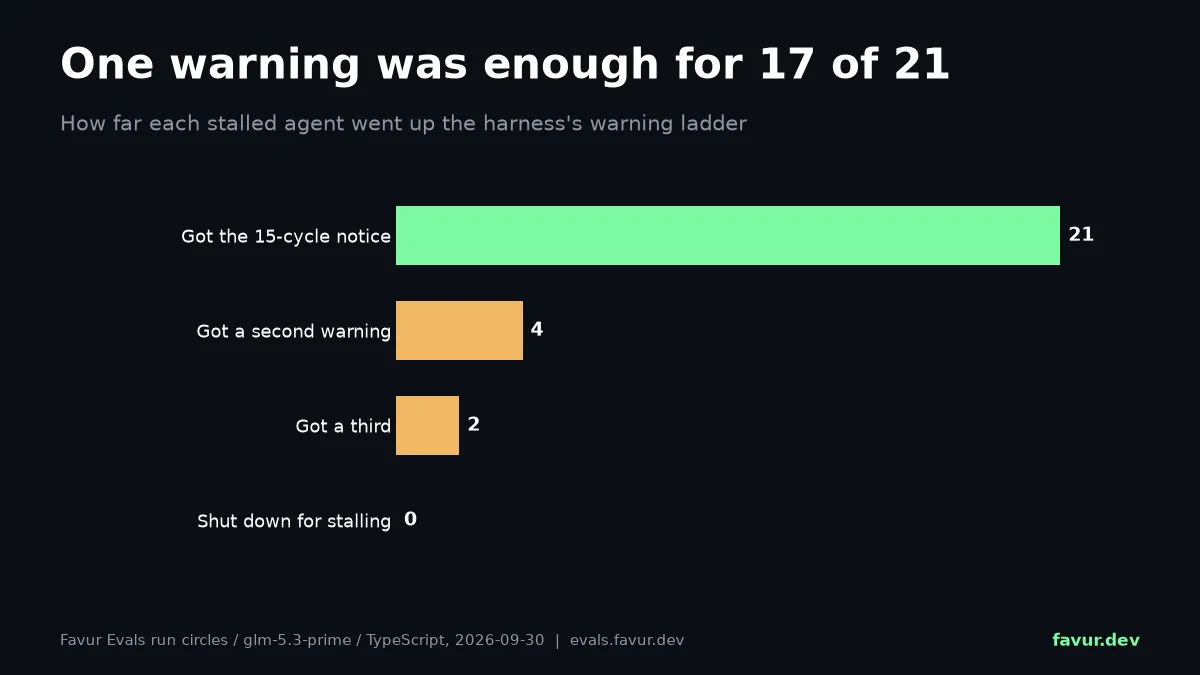
اگر عامل همچنان متوقف بماند، در چرخه ۲۰ام هشدار تندتری میرسد: «هشدارهای قبلی نادیده گرفته شدند» و مدل موظف است در نوبت بعدی مرحله را ببندد. این پیام با یک پیام صریح به پایان میرسد: ادامه جستوجو «منجر به خاتمه (Terminate) این عامل خواهد شد».
در یک اجرای ثبتشده، ۲۱ عامل هشدار اول را دریافت کردند که ۱۷ مورد از آنها بلافاصله مرحله را بستند و پیش رفتند. حتی ۴ مورد باقیمانده که به هشدار تندتر نیاز داشتند نیز در نهایت کار را تمام کردند و هیچ عاملی واقعاً خاموش نشد.
نقاط کور عاملها
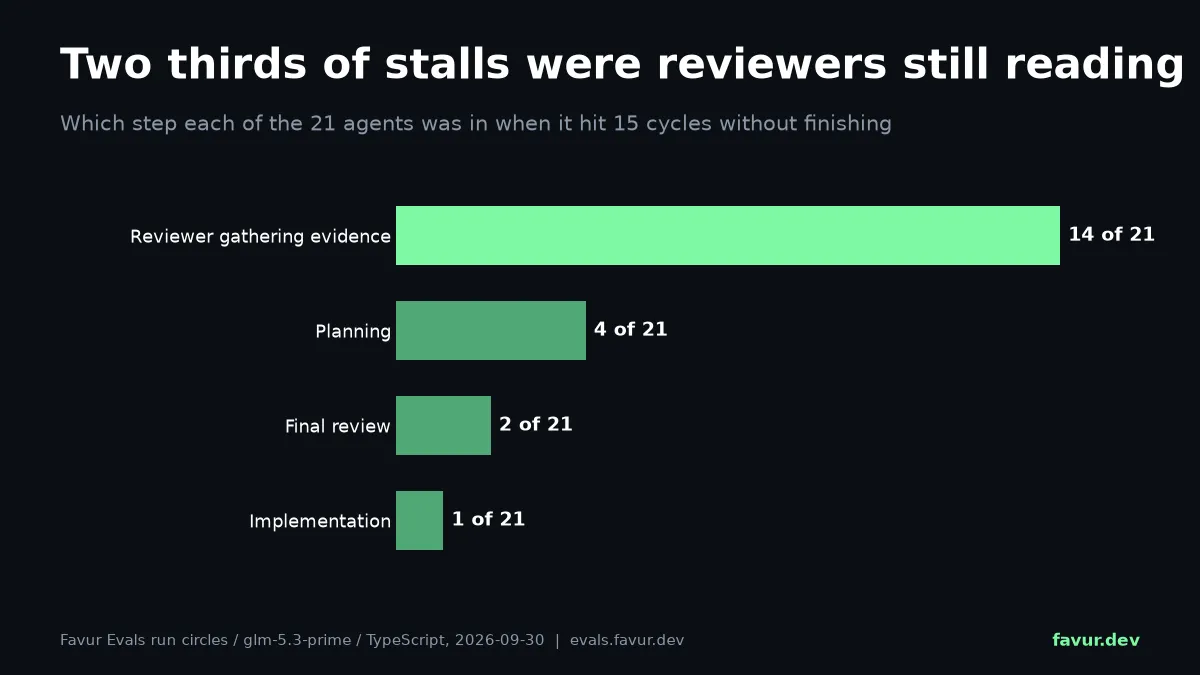
دادههای Favur Evals نشان میدهد که توقفها بهندرت به دلیل نبود توانایی است و بیشتر به دلیل «دقت بیش از حد» (Over-thoroughness) رخ میدهد. اکثر توقفها در فاز بازبینی (Review) اتفاق افتاده است:
- مراحل بازبینی: ۱۴ مورد از ۲۱ هشدار در اینجا بود؛ چون یک بازبین دقیق همیشه حس میکند یک فایل دیگر برای باز کردن وجود دارد و پایان طبیعی برای مرحله نمیبیند.
- سایر مراحل: ۷ مورد باقیمانده در بازبینی نهایی، مراحل برنامهریزی و یک مرحله پیادهسازی بود.
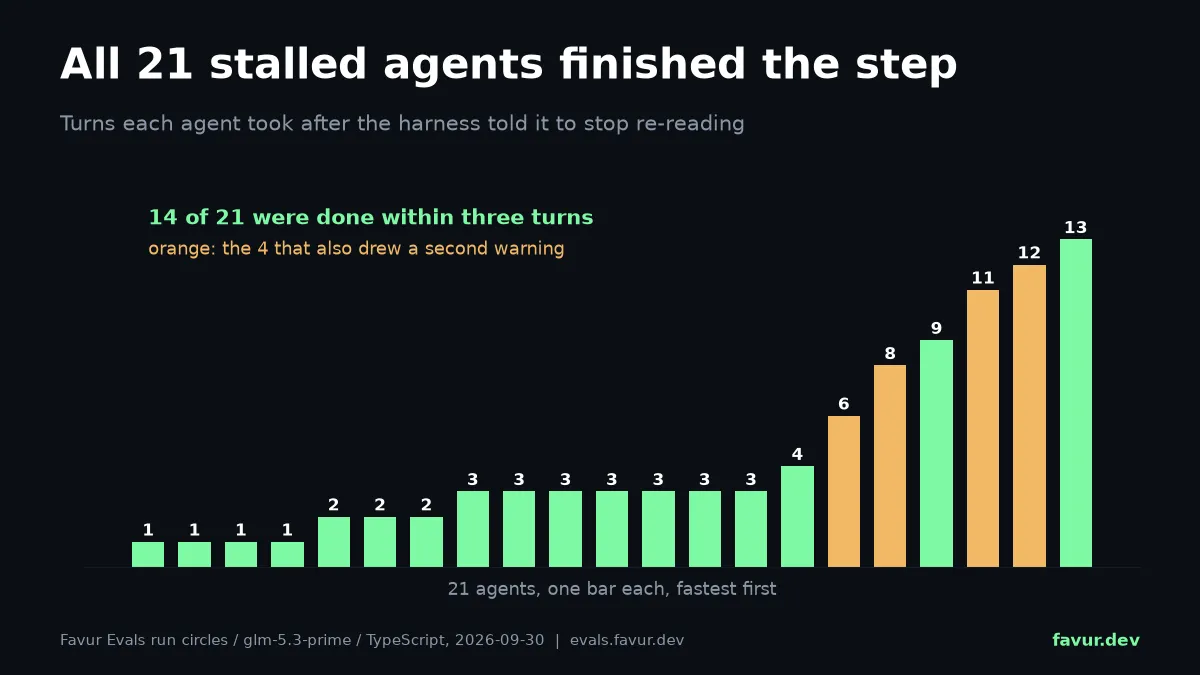
با دنبال کردن ۲۱ عامل از لحظه هشدار تا تکمیل، ۴ مورد در همان نوبت بعدی و ۱۴ مورد ظرف سه نوبت کار را تمام کردند. کندترین مورد ۱۳ نوبت زمان برد. یک عامل کدنویسی که در بازبینی نهایی در حال چرخ زدن بود، بلافاصله پس از اعلان، گزارش تکمیل را ثبت کرد و نوشت: «گردش کار در وضعیت پایان است و تمام گیتها پاس شدند. در حال تکمیل».
علاوه بر توقفهای بزرگ، هارنس خطاهای کوچک را هم مدیریت میکند. اگر عاملی سه بار متوالی یک ابزار را با آرگومانهای یکسان یا خالی فراخوانی کند، هارنس دخالت کرده و میگوید: «فراخوانیهای قبلی شما رد شدند یا تأثیری نداشتند» و او را به بخش دستورالعملهای گزارش هدایت میکند تا آرگومانهای معتبر بسازد.
در موردی دیگر، وقتی درخواست یک عامل کدنویسی برای باز کردن یک واحد کاری در داخل هارنس شکست خورد، پاسخ سیستم اعتراف کرد که خطا ممکن است مربوط به خود هارنس باشد. سپس مشخص کرد که یک درخواست معتبر به چه چیزهایی نیاز دارد و به عامل گفت در نوبت بعدی کدام ابزار را رها کند. این کار مانع از آن میشود که مدل تلاشهای «مجاور» (Adjacent) انجام دهد که اغلب بدتر از یک تلاش مجدد ساده هستند.
هزینه ژورنال
نگهداری صدها گزارش، پنجرهٔ زمینه (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد — را اشغال میکند. برای مدیریت این موضوع، Favur از یک فشردهساز زمینه استفاده میکند:
- فشردهسازی سبک: گزارشها را دستنخورده میگذارد تا تاریخچه ژورنال حفظ شود.
- فشردهسازی سنگین: وقتی پنجره تقریباً پر میشود، این مرحله اجازه دارد گزارشهای قدیمی را برای ذخیره فضا ادغام (Fold) کند.
هدایت (Steering) همچنان در دسترس است زیرا یادداشت یک انسان از همان مسیری میرود که گزارشهای خودکار میروند. دستور یک انسان در بالای گزارش بعدی قرار میگیرد و طرح کلی معمول در زیر آن میآید، بنابراین عامل هم دستور را دریافت میکند و هم جایگاه خود را در یک پیام میبیند.
در یک اجرای تحلیلشده که یک اپلیکیشن دسکتاپ TypeScript را در ۱۷۴ دقیقه ساخت، سیستم ۱,۵۹۴ درخواست مدل در ۱۱۰ گفتگو انجام داد. از این میان، ۶۰۷ پیام خودکار به شرح زیر بود:
- ۳۹۶ گزارش پیشرفت.
- ۶۷ پیام شروع فاز جدید کاری.
- ۳۶ نتیجه بازگشته از عاملهای تفویض شده.
- ۳۰ اسکرینشات تحویل داده شده بر اساس درخواست.
- ۲۷ اعلان توقف و ارجاع.
- باقیمانده: اهداف اولیه برای هر عامل.
این تغییر رویکرد نشان میدهد که آیندهٔ پایداری عاملها نه در مدلهای بزرگتر، بلکه در «هارنسهایی» است که آنها را مدیریت میکنند. با تبدیل جایگاه کاربر به یک رابط برنامهریزیشده برای حسابداری، توسعهدهندگان میتوانند تیمهای عاملی را بدون نیاز به نظارت لحظهای انسان مقیاس کنند. برای مشاهده این مکانیسمها در عمل، میتوانید صفحات اجرای عمومی را در بورد Favur Evals بررسی کنید.
گام بعدی شما
- اگر از عاملهای هوش مصنوعی برای کارهای پیچیده استفاده میکنید، بهجای تکیه بر پرامپت سیستمی، یک «ژورنال پیشرفت» در تاریخچه پیامها ایجاد کنید.
- برای جلوگیری از حلقههای تکراری، سیستمی برای شمارش نوبتهای (Turn count) مدل طراحی کنید و در صورت عبور از حد مجاز، هشدار صریح بفرستید.
- معیارهای ورود و خروج (Entry/Exit Criteria) هر مرحله را بهصورت صریح در پیامهای ارسالی به مدل ذکر کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو