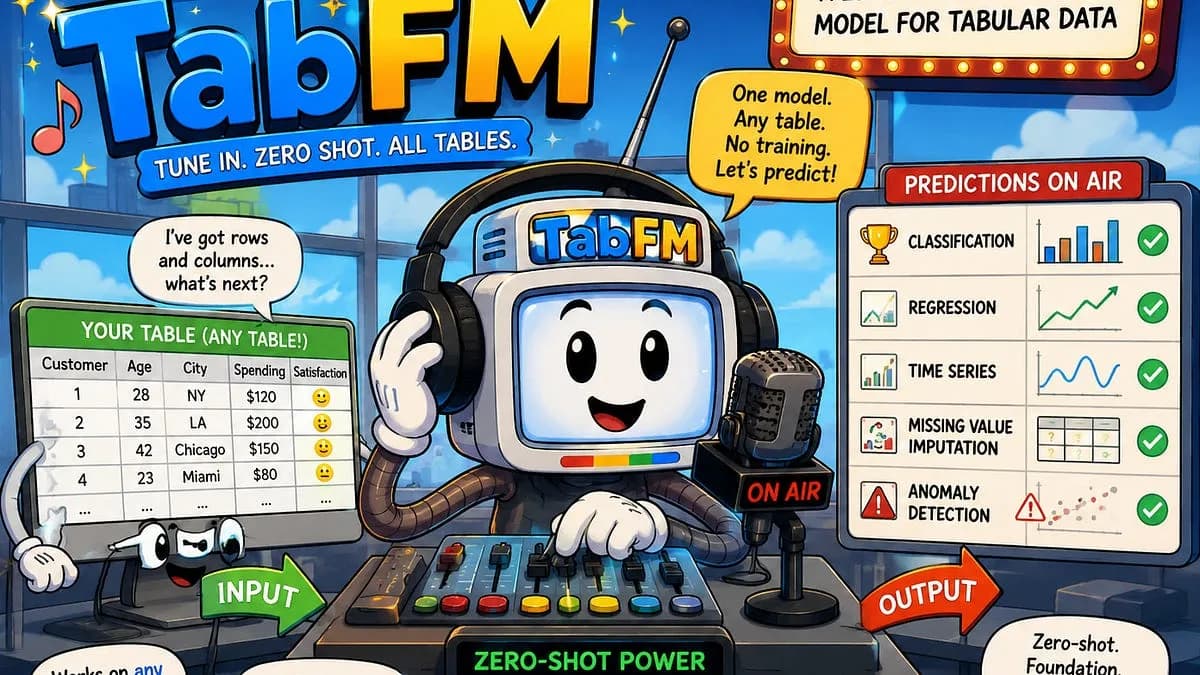
تصور کنید به جای هفتهها کلنجار رفتن با فایلهای CSV و کدنویسی پیچیده، کافی بود جدول دادههایتان را به یک مدل بدهید و بلافاصله پاسخ بگیرید. گوگل با معرفی TabFM، دقیقاً همین رویای سادهسازی دادههای ساختاریافته را هدف گرفته است.
در دنیای یادگیری ماشین سازمانی، پیشبینی مواردی مثل ریزش مشتری یا تقلب مالی همواره با چرخههای خستهکنندهی مهندسی ویژگی (Feature Engineering) و اعتبارسنجی متقابل همراه بوده است. همانطور که در تحلیلهای پیشین ما دربارهی تداخل مدلهای زبانی با موتورهای جستوجو دیدیم، گوگل اکنون قصد دارد لولهکشی اصلی علم داده در شرکتها را بازطراحی کند. TabFM بازی را از آموزش خطلولههای سفارشی به سمت یادگیری در بستر متن (In-context Learning) برای صفحات گسترده تغییر میدهد.
به نقل از گزارش thesequence.substack.com، این مدل بنیادی (Foundation Model) در ۸ جولای ۲۰۲۶ منتشر شده و با دریافت کل مسئله — شامل ردیفهای آموزشی و آزمایشی — به عنوان یک پرامپت غولپیکر عمل میکند. طبق مستندات، TabFM نتایج را در یک گذر مستقیم (Forward Pass) تولید میکند و نیازی به هیچگونه تنظیم یا آموزش مجدد ندارد. معماری این مدل بر اساس همان استراتژی TimesFM، مدل بنیادی گوگل برای سریهای زمانی، بنا شده است.

این چرخش، هوش مصنوعی جدولی را از یک وظیفهی مهندسی تخصصی به یک تمرین پرامپتنویسی تبدیل میکند. گوگل با حذف rituals یا آداب تکراریِ هر مجموعه داده، این پیشفرض قدیمی صنعت را به چالش کشیده که خطلولههای XGBoost تنها اسبهای بارکش قابل اعتماد برای دادههای ساختاریافته هستند. این تلاش گوگل برای تسلط بر ابزارهای تحلیل داده، در حالی رخ میدهد که رقابت برای جذب استعدادهای برتر در این حوزه شدت یافته است؛ چنانکه اخیراً استراتژی جسورانهی ایلان ماسک برای جذب متخصصان هوش مصنوعی توجهات زیادی را به خود جلب کرد.
برای متخصصان فنی، این تغییر به معنای جابجایی گلوگاه است؛ حالا تمرکز از بهینهسازی ابرپارامترها (Hyperparameters) به ساختار پرامپت و انتخاب دادهها منتقل شده است. TabFM در واقع یک صفحه گسترده را به عنوان یک توالی میبیند و اجازه میدهد مدل، الگوها را از بستر ردیفهای ارائه شده استنباط کند.
در حال حاضر باید بررسی کرد که آیا TabFM در دادههای با تعداد دستهها یا مقادیر زیاد (High-cardinality) که درختهای تصمیم سنتی در آنها برنده هستند، دقت خود را حفظ میکند یا خیر. معیار حیاتی بعدی، مقایسهی هزینه استنتاج (Inference) برای ارسال هزاران ردیف در یک پرامپت در برابر هزینه آموزش یک مدل سبک XGBoost خواهد بود. این چالش هزینه و استقرار، دقیقاً همان نقطهای است که غولهای فناوری برای تسلط بر لایهی استقرار مدلهای هوش مصنوعی میلیاردها دلار سرمایهگذاری کردهاند.
گام بعدی شما
- اگر با دادههای جدولی زیاد سروکار دارید، ساختار دادههای خود را برای تبدیل به توالیهای متنی بهینه کنید.
- هزینهی توکنهای مصرفی در پرامپتهای طولانی را با هزینه پردازش مدلهای کلاسیک مقایسه کنید.
- دقت مدل را در دستههای دادهای با توزیع نامتوازن بسنجید.
اما اثر این رویکرد بر بازدهی سختافزاری TPUها حتی پیچیدهتر است — به تحلیل ما دربارهی تراشههای نسل جدید گوگل مراجعه کنید.



گفتگو