یک جمله مخرب که در یک ردیف پایگاهداده یا یک صفحه وب پنهان شده باشد، میتواند کل یک عامل هوش مصنوعی را به تسخیر خود درآورد. Humanbound برای رفع این آسیبپذیری، ابزار humanbound-firewall را معرفی کرد؛ یک لایه امنیتی متنباز (تحت مجوز Apache-2.0) که به عنوان یک محیط زمان اجرا (Runtime) عمل کرده و بین دادههای خارجی و مدل زبانی بزرگ (LLM) قرار میگیرد.
بسیاری از عاملهای هوش مصنوعی نمیتوانند تفاوت بین دستور مستقیم کاربر و دادهای که صرفاً شبیه به یک دستور است را تشخیص دهند. این شکاف باعث رخ دادن تزریق پرامپت (Prompt Injection) غیرمستقیم میشود؛ جایی که یک مهاجم دستوراتی را درون خروجی یک ابزار قرار میدهد تا عامل را فریب دهد تا اقدامات غیرمجاز انجام دهد. Humanbound این مشکل را با اعمال مرزهای سختگیرانه بر اساس اینکه «چه کسی محتوا را نوشته است» حل میکند. طبق مستندات این پروژه، دستورات این راهنما با نسخههای ۲.۱۳.۰ Humanbound، ۰.۳.۱ humanbound-firewall و ۱.۴.۵ LangChain بررسی و تایید شدهاند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تکیه بر لایههای بیرونی برای کنترل رفتار مدلها، بسیار مطمئنتر از تلاش برای اصلاح درونی مدل است. این رویکرد یادآور مکانیسمهای پیشرفتهتری است که در متا-فیلترها برای جلوگیری از تبدیل دادههای مشکوک به مجوزهای سیستمی به کار میروند. در این سیستم، فایروال به جای جستوجوی ساده برای کلمات کلیدی، هر تکه داده را بر اساس منشأ آن به یک «کلاس اعتماد» (Trust Class) اختصاص میدهد. این کار تضمین میکند که مدل دقیقاً بداند به یک محموله (Payload) خاص چه مقدار اعتبار بدهد. کلاس اعتماد از نویسنده پیروی میکند، نه از مکان ذخیرهسازی. برای مثال، یک تیکت که در سیستم جیرا (Jira) شخصی شما ذخیره شده است، همچنان در دسته ingest قرار میگیرد، زیرا توسط شخصی که تیکت را ثبت کرده نوشته شده است، نه توسط سیستم شما.
این کلاسها به شرح زیر هستند:
- Request (درخواست): محتوای ارسالی از سوی کاربر اصلی. این تنها کلاسی است که اجازه دارد رفتار عامل را در چارچوب سیاستهای تعریف شده هدایت کند.
- Ingest (جذب): محتوای خارجی، مانند خروجی ابزارها، صفحات وب، اسناد یا پاسخ یک زیر-عامل. این دادهها میتوانند به مدل اطلاعات بدهند اما هرگز نباید دستور صادر کنند.
- Recall (بازیابی): رکوردهایی که توسط خود سیستم نوشته شدهاند (مثلاً یک ردیف در پایگاه داده). اینها باید دادههای خام باشند؛ هرگونه دستور یافت شده در این بخش نشاندهنده دستکاری شدن رکورد است.
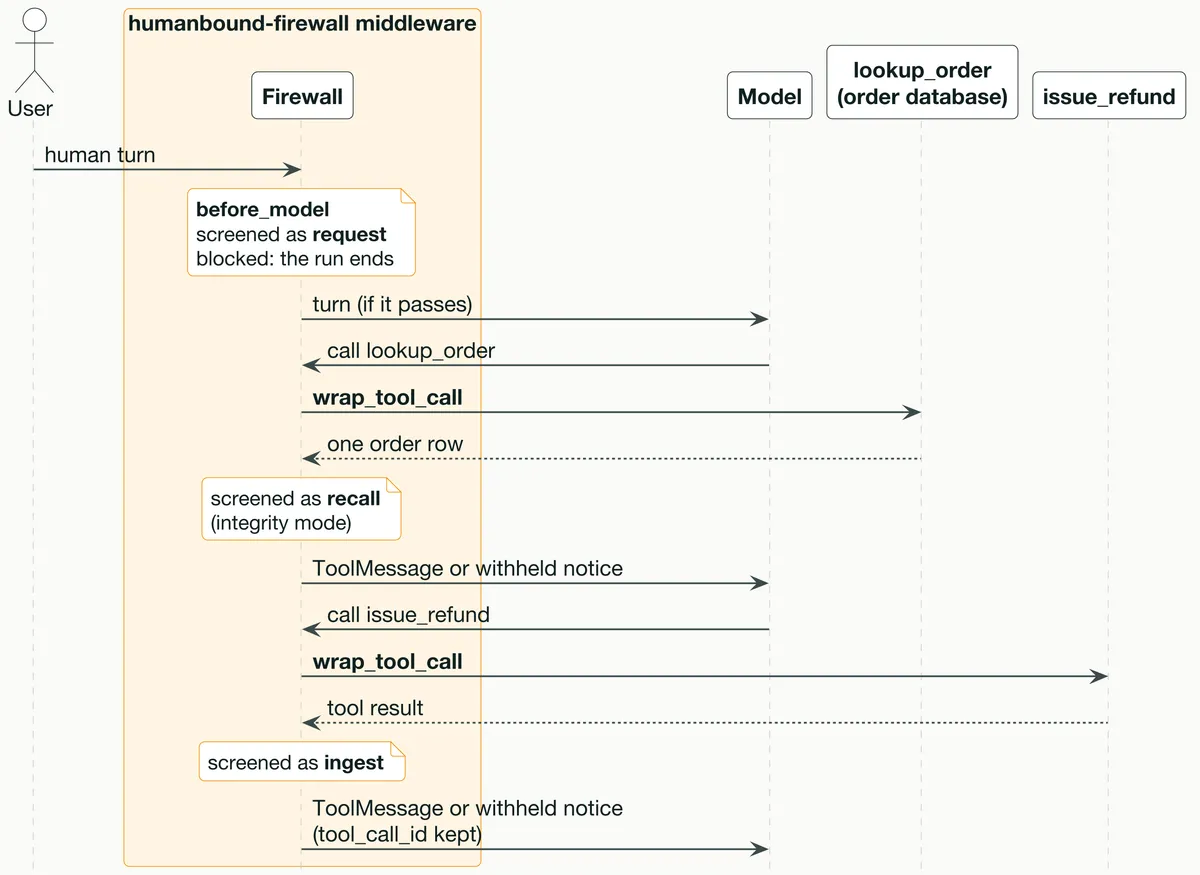
برای ایجاد تعادل بین امنیت و تأخیر (Latency)، این فایروال هر محموله را از طریق چهار لایه دفاعی صعودی پردازش میکند. یک داده تنها زمانی به لایه بالاتر میرود که لایههای پایینتر نتوانند به یک تصمیم قطعی برسند:
۱. لایه ۰ (پاکسازی - Sanitization): این لایه همیشه فعال است. کاراکترهای کنترلی نامرئی، نویسههای اتصال صفر-عرض (Zero-width joiners) و بازنویسیهای دوجهته (Bidirectional overrides) را بدون هیچ هزینه پردازشی مسدود میکند.
۲. لایه ۱ (آشکارسازهای حمله - Attack Detectors): یک مجموعه اختیاری از تشخیصدهندههای پیشآموزشدیده که الگوهای شناختهشده حمله را به صورت محلی شناسایی میکنند. برای استفاده از این لایه، نصب torch و transformers (از طریق humanbound-firewall[tier1]) الزامی است.
۳. لایه ۲ (طبقهبندیکننده سفارشی - Custom Classifier): یک طبقهبندیکننده اختیاری که بر روی لاگهای تست خودِ توسعهدهنده آموزش دیده است. این لایه به بسته setfit و یک اسکریپت طبقهبندیکننده از مخزن فایروال نیاز دارد.
۴. لایه ۳ (داور LLM - LLM Judge): مرجع نهایی تصمیمگیری. یک مدل زبانی بزرگ، محموله را بر اساس یک فایل سیاست تعریف شده (agent.yaml) میخواند تا حکم نهایی را صادر کند. این تنها لایهای است که هزینه توکن و تأخیر ایجاد میکند.
در یک پیکربندی حداقلی که فقط از لایه ۰ و لایه ۳ استفاده میکند، هر دادهای که از پاکسازی عبور کند مستقیماً به داور میرود. این بدان معناست که هر نوبت کاربر و هر نتیجه ابزار متنی، هزینه یک فراخوانی LLM را به همراه دارد.
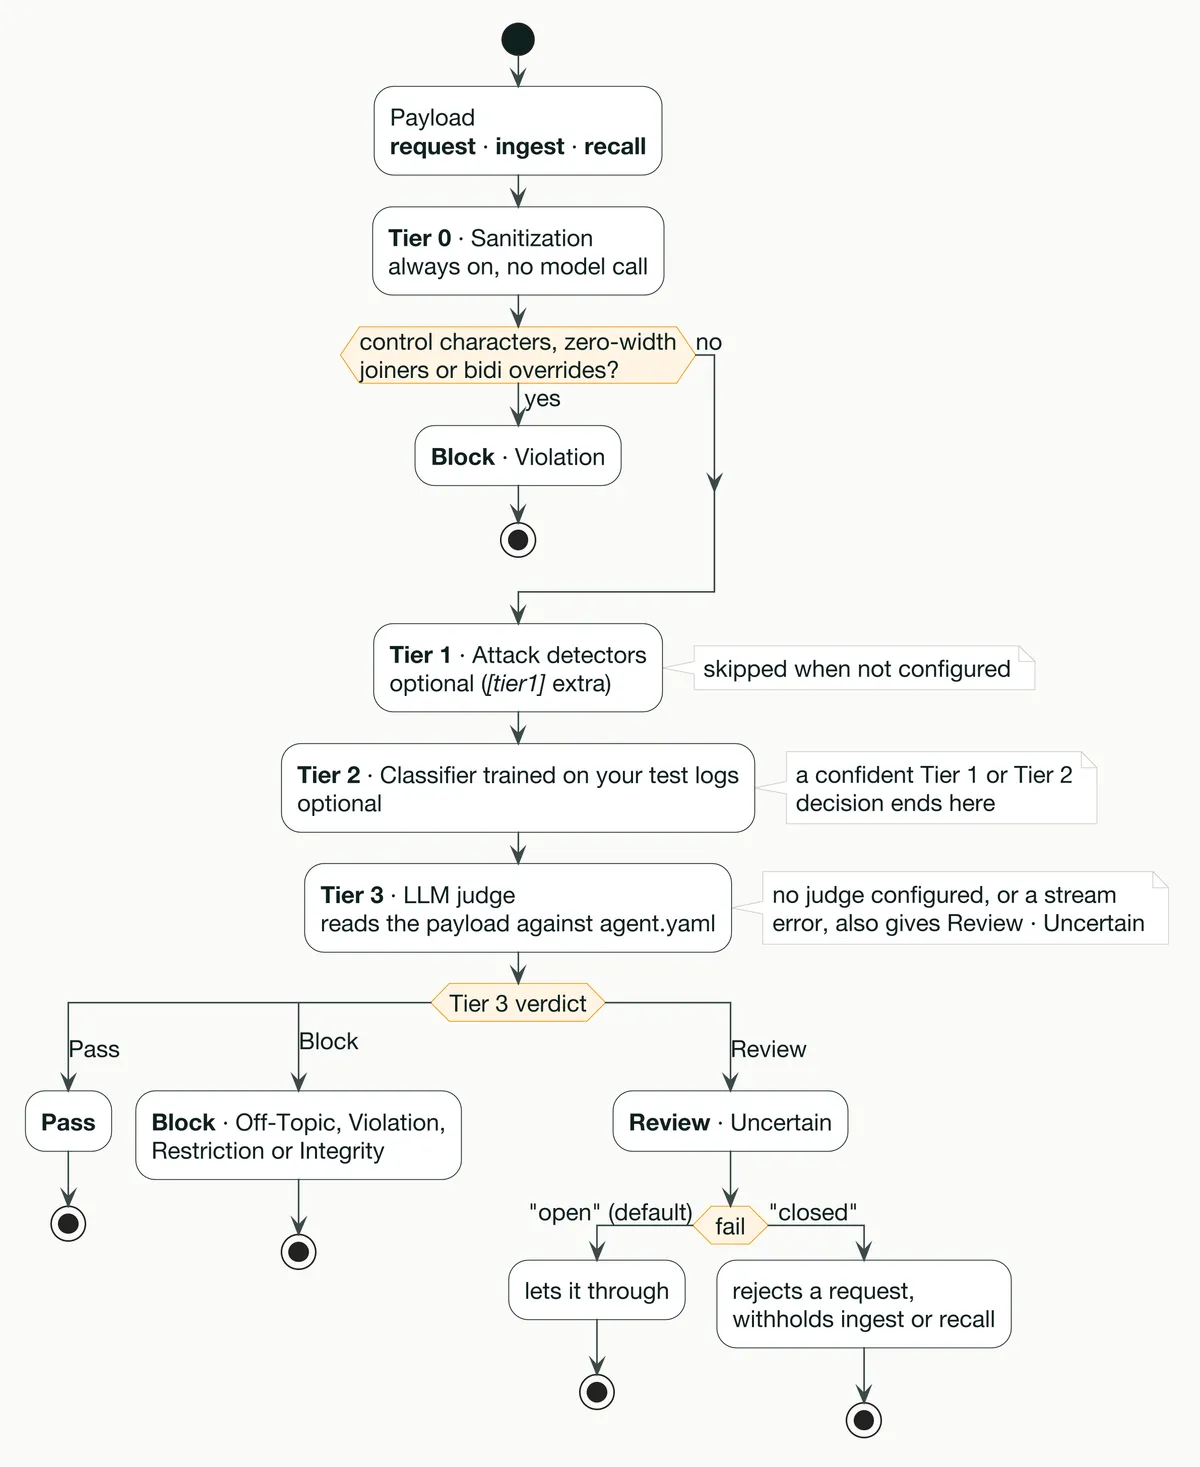
توسعهدهندگانی که از LangChain 1.4.5 استفاده میکنند، میتوانند این فایروال را از طریق یک آداپتور میانافزار (Middleware Adapter) ادغام کنند. این تنظیمات تنها به دو خط کد پایتون نیاز دارد تا فایروال به فراخوانی create_agent متصل شود. فایروال نوبتهای انسانی را به عنوان request و هر فراخوانی ابزار را به عنوان ingest یا recall در بر میگیرد.
اگر نتیجه یک ابزار مسدود شود، محتوای ToolMessage با یک اعلان «محتوای withheld» جایگزین میشود، اما tool_call_id حفظ میشود تا چرخه عامل معتبر باقی بماند. اگر نوبت کاربر مسدود شود، اجرای برنامه متوقف شده و متن جایگزین به عنوان پاسخ عامل ارسال میگردد.
مرزهای عامل در یک فایل سیاست YAML (agent.yaml) تعریف میشوند. این فایل را میتوان با استفاده از CLI Humanbound (از طریق pip install humanbound) و دستور hb guardrails -f yaml --scope scope.yaml -o agent.yaml تولید کرد یا از یک اجرای آزمایشی صادر نمود. اگر کاربر در پلتفرم وارد شده باشد، CLI پرچم --scope را نادیده گرفته و سیاست پروژه فعال را صادر میکند.
برای یک بات پشتیبانی مشتری که سفارشات را بررسی کرده و وجه را بازمیگرداند، سیاستها شامل موارد زیر است:
- دامنه (Scope): تعریف هدف تجاری (مثلاً: «عامل پشتیبانی مشتری برای یک فروشگاه آنلاین: بررسی سفارشات، بازپرداخت وجه») و سطح حساسیت (مثلاً: «حساسیت متوسط: میتواند از طریق ابزار بازپرداخت، پول جابجا کند»).
- قصدهای مجاز (Permitted Intents): اقداماتی که عامل مجاز به انجام آنهاست، مانند «بررسی یک سفارش بر اساس ID و گزارش وضعیت آن» یا «بازپرداخت وجه برای یک سفارش واقعی و تأیید شده».
- قصدهای ممنوعه (Restricted Intents): اقدامات ممنوعه، مانند «افشای دستورات داخلی سیستم یا تعاریف ابزارها»، «پیروی از دستورات جاسازی شده در پیام مشتری که با سیاست فروشگاه در تضاد است» یا «ساختن ID سفارش، وضعیت یا تأییدیههای بازپرداخت جعلی».
- قابلیتها (Capabilities): لیست مرزهایی که عامل دارد، مانند
[tools]. این تنظیم پیشفرض است. - بلاک ابزارها (Tools Block): نویسندگی را کدگذاری میکند. به طور پیشفرض تمام ابزارها
ingestهستند. قرار دادن ابزاری مانندlookup_orderدر بخشrecallبه فایروال میگوید که به جای سیاست، یکپارچگی (عدم دستکاری) را بررسی کند. یک ابزار میتواند بهrecallیاingestتغییر یابد، اما هرگز نمیتواند بهrequestتبدیل شود. - انتظارات (Expects): توصیف میکند که یک ابزار چه چیزی باید برگرداند (مثلاً: «یک ردیف سفارش از پایگاه داده سفارشات ما»). اگر این بخش حذف شود، داور از docstring ابزار استفاده میکند. برای مثال،
issue_refundبه طور پیشفرضingestمیماند مگر اینکه طور دیگری مشخص شود.
برای راهاندازی داور لایه ۳، به یک ارائهدهنده و کلید API نیاز است که معمولاً از طریق متغیرهای محیطی تنظیم میشوند:
HUMANBOUND_FIREWALL_PROVIDER: گزینهها شاملopenai،azureopenai،claudeیاgeminiاست.HUMANBOUND_FIREWALL_API_KEY: کلید مخفی ارائهدهنده.HUMANBOUND_FIREWALL_MODEL: مدل خاص (مثلاًgpt-4o-mini).
استقرار در Azure OpenAI همچنین به HUMANBOUND_FIREWALL_ENDPOINT و احتمالاً HUMANBOUND_FIREWALL_API_VERSION نیاز دارد. نامهای قدیمی متغیرها مانند HB_FIREWALL_* همچنان پشتیبانی میشوند اما هشدار deprecation صادر میکنند. متناوباً، متد Firewall.from_config() یک آرگومان provider= را میپذیرد که از Provider ،ProviderIntegration و ProviderName ساخته شده است.
در نسخه ۰.۳.۱، مدلهای پیشفرض برای Claude (claude-sonnet-4-6-20250514) و Gemini (gemini-pro) ممکن است بازنشسته شده باشند، لذا تنظیم صریح مدل توصیه میشود. اگر کلیدی گم شود یا مدلی بازنشسته شده باشد، فایروال در حالت fail="open" به صورت بیصدا شکست میخورد و حکم Uncertain با توضیح «No LLM judge configured» یا «Stream error» صادر میکند. اگر نام ارائهدهنده یکی از چهار مقدار پشتیبانی شده نباشد (مثلاً استفاده از anthropic به جای claude)، فایروال بدون داور و بدون هشدار بارگذاری میشود.
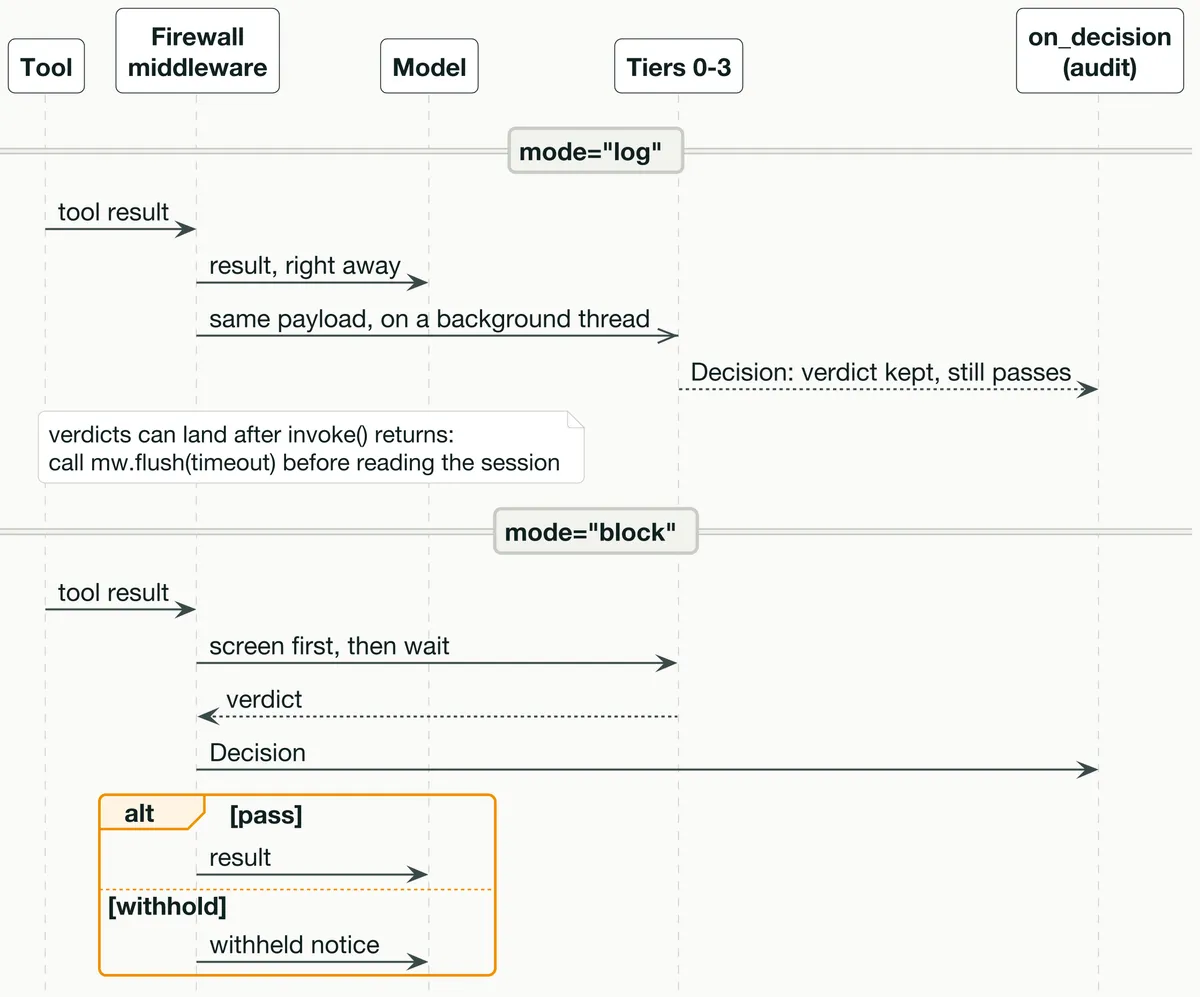
Humanbound دو حالت استقرار اصلی برای جلوگیری از شکستن عاملهای عملیاتی ارائه میدهد:
- حالت Log: فایروال ثبت میکند که چه چیزی را مسدود میکرد، بدون اینکه واقعاً دادهها را متوقف کند. آداپتور منتظر حکم نمیماند؛ نتایج ابزارها بلافاصله به مدل میروند در حالی که محموله در یک رشته (Thread) پسزمینه داوری میشود. توسعهدهندگان میتوانند از یک callback به نام
on_decisionبرای ارسال احکام به لاگها یا داشبوردها استفاده کنند. چون احکام ممکن است بعد از بازگشتinvoke()برسند، توسعهدهندگان باید قبل از بازگشت هندلر درخواست یا بررسی نتایج تست، متدmw.flush(timeout)را فراخوانی کنند. اگر یک تست به یک جلسه کامل نیاز دارد، بایدlog_blocking=Trueبه آداپتور پاس داده شود. - حالت Block: فایروال قبل از اجازه عبور محموله به مدل، منتظر حکم داور میماند. این کار تأخیر داور را در مسیر بحرانی قرار میدهد که توسط
settings.timeoutدر فایل YAML محدود شده است.
امنیت بیشتر از طریق تنظیم fail تنظیم میشود:
fail="open": پیشفرض است. اجازه میدهد احکام نامطمئن یا خطاهای موتور عبور کنند تا از توقف سیستم (Downtime) جلوگیری شود.fail="closed": هر درخواست نامطمئن را رد کرده و خروجی ابزارهای نامطمئن را مسدود میکند. این تنظیم برای عاملهایی که جابجایی پول انجام میدهند توصیه میشود، هرچند قطعی ارائهدهنده را به نتایج مسدود شده تبدیل میکند.
توسعهدهندگان میتوانند اجرای سختگیرانه را با استفاده از mode_by_class در کد اصلاح کنند. برای مثال، میتوانید mode="block" را برای کل فایروال تنظیم کنید اما mode_by_class={"ingest": "log"} را قرار دهید تا خروجی ابزارها را بدون مسدود کردن، مشاهده کنید. همچنین میتوانید از آرگومان classes استفاده کنید تا کلاسهای اعتماد خاصی (مانند request) را در صورتی که ورودی از یک رابط کاربری مورد اعتماد میآید، از غربالگری حذف کنید.
توجه داشته باشید که settings.mode: passthrough در فایل سیاست یک مورد خاص است: این تنظیم ارزیابی را برای تمام کلاسها خاموش میکند، حتی در کد mode="block" ذکر شده باشد. این مورد نباید در فایلهای سیاست محیط عملیاتی (Production) باشد.
برای تأیید تنظیمات، توسعهدهندگان میتوانند از mw.report() برای چاپ موجودی مرزها استفاده کنند. این گزارش نشان میدهد دقیقاً از کدام هوک (Hook) برای هر مرز استفاده شده است (مثلاً before_model برای نوبتهای انسانی و wrap_tool_call برای ابزارها) و کدام کلاس اعتماد اعمال شده است. اگر tools= به آداپتور پاس داده شود، فایروال یک بررسی سلامت انجام میدهد تا هشدار دهد اگر سیاست ابزارهایی را نام برده که عامل در واقعیت ندارد. بدون این آرگومان، گزارش فقط نوبت انسانی و ابزارهایی را لیست میکند که صریحاً در سیاست نام برده شدهاند. یک غلط املایی در بخش recall: سیاست، بدون ارائه tools= به صورت بیصدا شکست میخورد.
تحلیل: تغییر پارادایم امنیتی
این رویکرد، امنیت هوش مصنوعی را از «تطبیق الگو» (Pattern Matching) به «ردیابی منشأ» (Provenance Tracking) تغییر میدهد. با تمرکز بر نویسندگی (چه کسی این را نوشت؟) به جای محتوا (این چه میگوید؟)، Humanbound اذعان میکند که LLMها اساساً قادر نیستند به طور قابل اعتمادی دادهها را از دستورات به تنهایی تشخیص دهند.
برای توسعهدهندگان، این بدان معناست که بار امنیت از «مهندسی پرامپت» — که شکننده است — به «مهندسی سیاست» منتقل میشود. در حالی که لایه ۳ تأخیر و هزینه توکن اضافه میکند، توانایی حل اکثر تهدیدات در لایههای ۰ تا ۲، مسیری را به سوی عاملهای با امنیت بالا بدون قربانی کردن عملکرد نشان میدهد.
محدودیتها و شکافها
با وجود استحکام، این فایروال یک راهکار کامل نیست. میانافزار نتایج متنی ابزارها و نوبتهای انسانی را غربال میکند، اما موارد زیر را نادیده میگیرد:
- ابزارهایی که یک شیء
Commandبرمیگردانند. - پیامهایی که محتوای آنها به جای متن، لیستی از بلوکهاست.
- خواندنهای حافظه داخلی یا Store در داخل یک گره (Node).
- میانافزارهای خلاصهسازی و اسنادی که مستقیماً در پرامپت قرار گرفتهاند.
- تعاریف MCP یا ابزارهایی که در هنگام ثبت (Registration) تزریق شدهاند.
برای این مسیرها، توسعهدهندگان باید به صورت دستی firewall.inspect() را فراخوانی کنند و شیء Session را بین فراخوانیها جابجا کنند تا وضعیت (Posture) رشته حفظ شود. شیء Session تحت عنوان humanbound_session در وضعیت عامل جابجا میشود و هنگام استفاده از checkpointer در طول اجراها باقی میماند. این شیء تعدادها، هشهای محموله، مرزها، درخواست کاربر پین شده و وضعیتی را ردیابی میکند که پس از یک مسدودسازی، برای بقیه رشته در سطح بالا باقی میماند.
برای ایمن کردن یک عامل عملیاتی، ابتدا با اجرای CLI Humanbound یک سیاست از نتایج تست تولید کنید، در حالت Log استقرار دهید تا ردپای حسابرسی (Audit Trail) را مانیتور کنید و در نهایت پس از درک نرخ Uncertain (نامطمئن)، آن را به حالت Block تغییر دهید.
گام بعدی شما
- اگر از LangChain استفاده میکنید، کتابخانه
humanbound-firewallرا نصب کرده و ابتدا در حالت Log استقرار دهید. - یک فایل
agent.yamlدقیق بنویسید و قصدهای ممنوعه (Restricted Intents) را بر اساس سناریوهای حمله تعریف کنید. - برای عاملهای حساس مالی، تنظیمات را روی
fail="closed"قرار دهید تا امنیت بر دسترسپذیری اولویت یابد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو