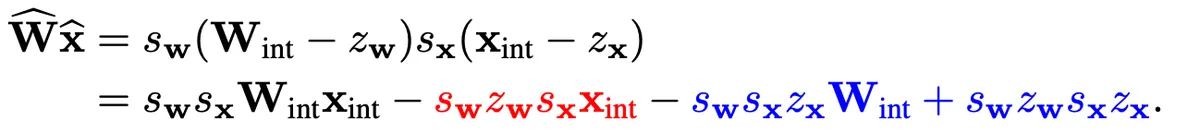پرش به محتوای اصلی
پرش به محتوای مقاله

کوانتایزیشن اعداد صحیح مصرف انرژی مدل‌های زبانی را تا ۳۰ برابر کاهش داد

·۲۸ خرداد ۱۴۰۵۱۳ دقیقه مطالعه
راهنما
غواصی عمیق در کوانتیزاسیون عدد صحیح: کاهش دقت مدل‌های هوش مصنوعی با حفظ کارایی
اشتراک‌گذاری
واقعاً چه چیز جدید است؟

جایگزینی کامل خط لوله محاسباتی با اعداد صحیح (Integer Arithmetic) و محدود کردن عملیات اعشاری به تنها یک مرحله باز-مقیاس‌بندی در هر لایه، که بهره‌وری انرژی را تا ۳۰ برابر ارتقا می‌دهد.

اگر قصد دارید یک مدل ۷۰ میلیارد پارامتری را روی یک GPU واحد اجرا کنید، بزرگ‌ترین دشمن شما پهنای باند حافظه و توان مصرفی است. طبق گزارش منتشر شده در ۱۸ ژوئن ۲۰۲۶ در وب‌سایت hello-fri-end.github.io، تغییر دقت از ۱۶-بیت به کوانتایزیشن (Quantization) ۴-بیت اعداد صحیح، فضای اشغال‌شده در حافظه را ۴ برابر کاهش می‌دهد.

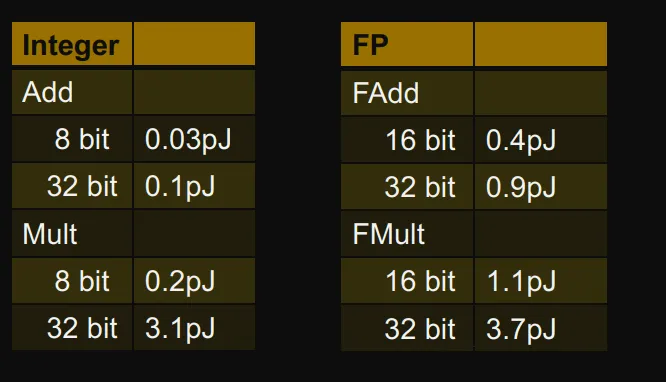
این تغییر حیاتی است چون عملیات اعداد اعشاری انرژی بسیار زیادی مصرف می‌کنند. مدل زبانی بزرگ (LLM) — مثل کتابخانه‌داری که میلیاردها صفحه را خوانده و حالا با همان لحن کتاب‌ها جواب می‌دهد — برای تولید هر توکن نیاز به محاسبات عظیمی دارد. همان‌طور که در تحلیل‌های پیشین ما درباره‌ی بهینه‌سازی سخت‌افزار مدل‌ها اشاره کردیم، گلوگاه اصلی همیشه انتقال داده است. بر اساس پژوهش مارک هوروویتز از دانشگاه استنفورد، یک عملیات جمع با دقت int8 تا ۳۰ برابر کمتر از fp32 انرژی می‌برد و ضرب اعداد صحیح ۱۸ برابر بهینه‌تر است.

غواصی عمیق در کوانتیزاسیون اعداد صحیح: از اصول تا پیاده‌سازی عملی در مدل‌های یادگیری عمیق

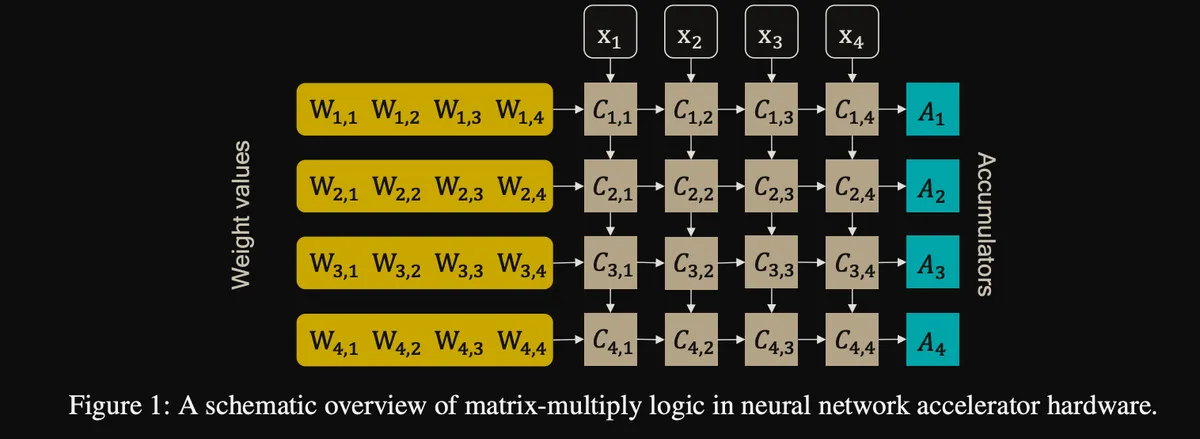
این بهره‌وری در سطح سخت‌افزار درون واحدهای ضرب-تجمعی (MAC) رخ می‌دهد. این واحدها ضرب ماتریسی را با بارگذاری وزن‌های کوانتیده انجام داده و نتیجه را در ثبت‌های int32 با دقت بالا جمع می‌کنند.

غواصی عمیق در کوانتیزاسیون عدد صحیح: کاهش دقت مدل‌های هوش مصنوعی با حفظ کارایی

برای کاهش افت دقت، مهندسان از روش‌های زیر استفاده می‌کنند:

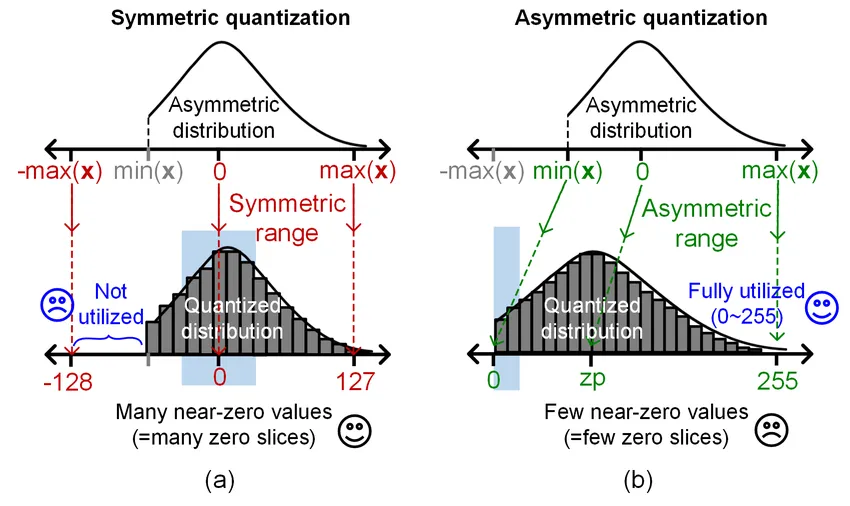
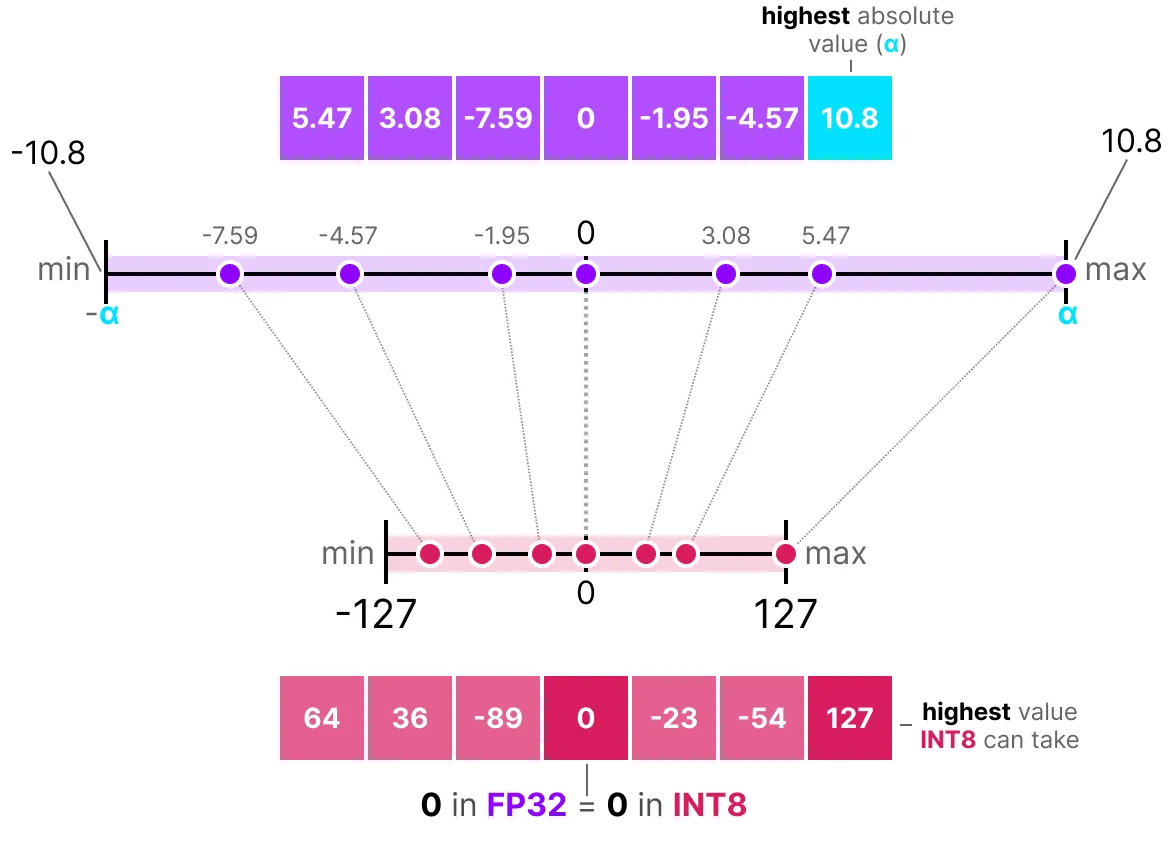
  • کوانتایزیشن متقارن (Symmetric Quantization): نقطه صفر را ثابت نگه می‌دارد و برای شبکه‌های اعداد صحیح علامت‌دار ایده‌آل است.
  • کوانتایزیشن نامتقارن (Asymmetric Quantization): از یک آفست غیرصفر برای تطبیق بهتر با توزیع داده‌ها استفاده می‌کند.
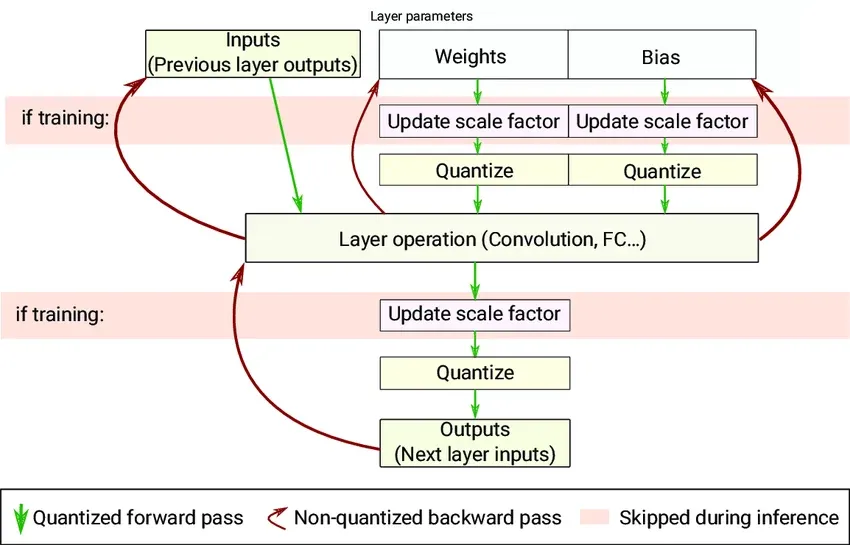
  • آموزش آگاه از کوانتایزیشن (QAT): افت دقت را در حین آموزش شبیه‌سازی می‌کند تا مدل با وزن‌های جدید سازگار شود.
  • کوانتایزیشن پس از آموزش (PTQ): کاهش دقت را بعد از اتمام آموزش اعمال می‌کند تا استقرار سریع‌تر شود.

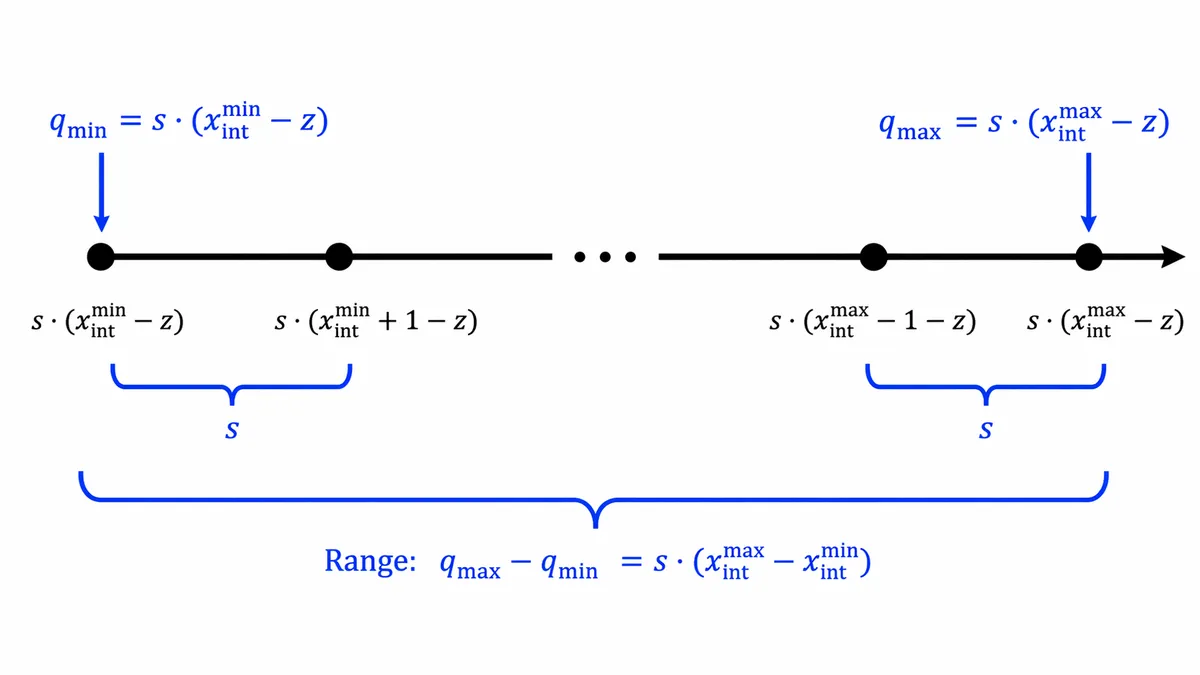
Asymmetric vs Symmetric Quantization

An illustration of forward and backward pass for QAT

از دیدگاه کاربردی، این رویکرد فرض ما از سخت‌افزار را تغییر می‌دهد؛ دیگر نیازی به آرایه‌های عظیم اعشاری برای هر عملیات نیست. سیستم با استفاده از یک مقیاس باز-کوانتایزیشن (M)، کل خط لوله را در محاسبات اعداد صحیح نگه می‌دارد و تنها یک عملیات اعشاری برای تغییر مقیاس لایه‌ی بعدی انجام می‌دهد.

MAC with quantization

اگرچه کوانتایزیشن در سطح تانسور ساده‌ترین روش است، اما طرح‌های کانال-محور (per-channel) دقت بیشتری برای وزن‌های حساس ایجاد می‌کنند. با این حال، این روش برای «فعال‌سازها» به‌دلیل ایجاد ناکارآمدی سخت‌افزاری در مرحله تجمعی، معمولاً توصیه نمی‌شود.

غواصی عمیق در کوانتیزاسیون اعداد صحیح: کاهش دقت مدل‌های هوش مصنوعی با حفظ کارایی

غواصی عمیق در کوانتیزاسیون اعداد صحیح: کاهش دقت مدل‌های هوش مصنوعی با حفظ کارایی

گام بعدی شما

  • بررسی تفاوت‌های عملکردی بین مدل‌های کوانتیده شده با روش GPTQ در برابر AWQ.
  • آزمایش استقرار مدل‌های کوچک‌تر (SLM) با دقت ۴-بیت روی سخت‌افزارهای لبه (Edge).
  • مطالعه اثرات توزیع‌های پرت (Outliers) در معماری ترنسفورمر بر دقت کوانتایزیشن.

اما داستان سخت‌افزاری این تحول با ظهور تراشه‌های تخصصی حتی شگفت‌انگیزتر است — به تحلیل ما درباره‌ی معماری NPUها مراجعه کنید.

چرا این موضوع مهم است؟

این تکنیک با تکیه بر اعتبار پژوهش‌های استنفورد، امکان اجرای مدل‌های غول‌پیکر را روی سخت‌افزارهای ارزان‌تر فراهم می‌کند. نتیجه آن، کاهش چشمگیر هزینه‌های عملیاتی مراکز داده و افزایش سرعت استنتاج برای کاربران نهایی است.

تأثیر برای ایران

این روش برای توسعه‌دهندگان ایرانی که با محدودیت شدید سخت‌افزاری و کمبود GPUهای سطح بالا مواجه‌اند، حیاتی است و امکان اجرای مدل‌های پیشرفته را روی سخت‌افزارهای موجود فراهم می‌کند.

·نگاه ما
تحریریه دات‌هوش

تمرکز بر اعداد صحیح به‌جای اعشاری، پارادایم سخت‌افزاری را از «محاسبه با دقت بالا» به «تکرار سریع با دقت کافی» تغییر می‌دهد. این روند نشان می‌دهد که برای رسیدن به مقیاس‌های بعدی، به جای افزایش قدرت خام GPUها، باید روی روش‌های فشرده‌سازی ریاضی متمرکز شد تا محدودیت‌های فیزیکی توان مصرفی عبور کنند.

منابع

این گزارش با خط‌لولهٔ خودکار دات‌هوش از منابع معتبر جهانی تدوین و زیر نظر تحریریه منتشر شده است. روش کار ما

گفتگو

پنج‌شنبه‌های هوش‌محور

بسته‌ی هفتگی دات‌هوش

۵ خبر، ۲ ابزار، ۱ پرامپت در هر شماره. به‌زودی راه‌اندازی می‌شود — هر پنج‌شنبه صبح.

خبر کلیدی
ابزار کاربردی
پرامپت حرفه‌ای
تحلیل پژوهش
به‌زودی
زاویه‌ی ایرانی
به‌زودی
تمرین این هفته
به‌زودی

راهنماهای دات‌هوش

راهنماهای کاربردیِ دات‌هوش برای کار با هوش مصنوعی — از همین‌جا شروع کنید:

دات‌هوش

راهنمای فارسی هوش مصنوعی — با نگاه به ایران

اخبار روزانه، معرفی ابزارها و مدل‌ها، و آموزشِ کار با هوش مصنوعی؛ همیشه با این پرسش که از ایران چه چیزی کار می‌کند و چه چیزی نه.