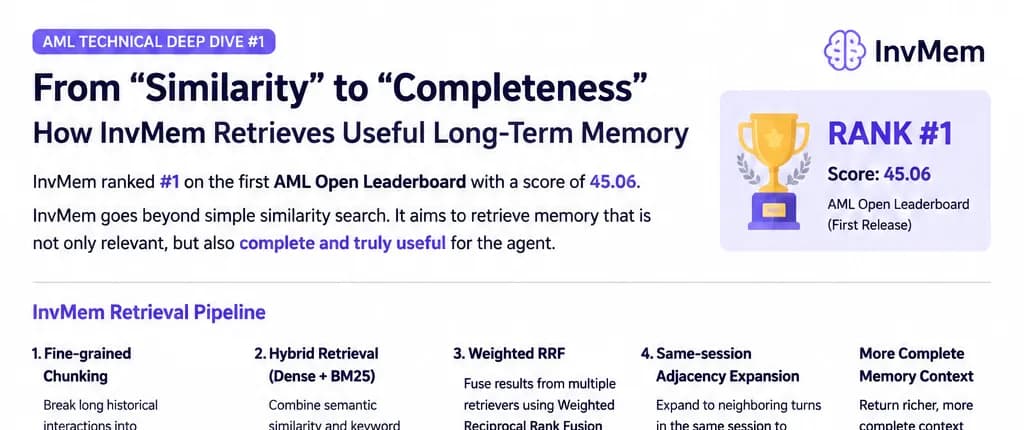
اگر یک عامل هوش مصنوعی تنها «راه حل» را به یاد بیاورد اما «مشکلی» که منجر به آن شد را فراموش کند، حافظهاش عملاً بیفایده است. سیستم InvMem با تغییر تعریف بازیابی از «شباهت» به «کامل بودن»، توانست با امتیاز ۴۵.۰۶ رتبه اول نخستین جدول Open Leaderboard در معیار AML را کسب کند.
بسیاری از سیستمهای حافظه در حال حاضر بر پایه جستوجوی معنایی (Semantic Search) — شبیه به جستوجوی کلمات کلیدی در گوگل که فقط صفحاتی با کلمات مشابه را میآورد — کار میکنند. اما این روش اغلب تکههایی را بازیابی میکند که شبیه به پرسش هستند ولی بستر لازم برای تصمیمگیری را ندارند. همانطور که در تحلیل قبلی ما دربارهی پروتکل MCP-Memory و نحوه ایجاد وضعیت پایدار از طریق OKF اشاره کردیم، صنعت در حال گذار از ذخیرهسازی ساده به بازیابی هوشمند است. برای یک توسعهدهنده، تفاوت این دو رویکرد مثل تفاوت بین پیدا کردن یک جمله تک و پراکنده در دفترچه راهنما با پیدا کردن کل فصل عیبیابی است. اگر عاملی فقط «پاسخ» را بدون «مسئلهای» که در حال حل آن بوده بازیابی کند، آن حافظه عملاً بلااستفاده است.
زمینه و ضرورت کامل بودن حافظه
حافظه بلندمدت به یکی از اجزای حیاتی در سیستمهای عاملهای هوشمند تبدیل شده است. با این حال، همزمان با تکامل این سیستمها، بازیابی اطلاعات به چیزی فراتر از یک مسئله استاندارد «جستوجوی برداری» (Vector Search) تبدیل شده است. در حالی که پایگاهدادههای برداری توانستند سرعت بازیابی تاریخچه کاربر را به زیر ۶۰ میلیثانیه برسانند، اما اکنون چالش اصلی از سرعت به کیفیت و جامعیت دادههای بازیابی شده تغییر یافته است. یک عامل هوشمند اغلب به بیش از یک نقطه داده نیاز دارد؛ او ممکن است به یک حقیقت خاص، یک تصمیم قبلی، استدلالهای پشت آن تصمیم یا شواهدی مبنی بر اینکه یک راه حل خاص واقعاً جواب داده است، نیاز داشته باشد.
این موضوع باعث میشود که «کامل بودن حافظه» (Memory Completeness) به یک بُعد حیاتی تبدیل شود که باید در کنار «مرتبط بودن بازیابی» (Retrieval Relevance) در نظر گرفته شود. هدف این است که از بازیابی ساده بر اساس شباهت فراتر برویم تا تضمین شود عامل هوشمند، بستر (Context) محیطی لازم برای تفسیر صحیح حافظه بازیابی شده را در اختیار دارد. همچنین باید توجه داشت که افزایش پیچیدگی حافظه، ریسکهای امنیتی جدیدی را به همراه میآورد؛ موضوعی که در بررسی سازوکارهای مسمومسازی حافظه و لزوم تبدیل حافظه به یک پروتکل اعتماد به آن پرداختیم.
به نقل از گزارش فنی منتشر شده در ۲۰ اوت ۲۰۲۶، InvMem برای حل این مشکل از یک خط لوله چندمرحلهای استفاده میکند. این فرآیند با تکهبندی ریزدانه آغاز میشود که دادههای تاریخی را به واحدهای کوچکتر تقسیم میکند تا از غلبه نویزهای نامرتبط بر سیگنال بازیابی جلوگیری شود.

جزئیات فنی خط لوله (Pipeline)
سیستم InvMem چندین مکانیزم خاص را برای تضمین اینکه اطلاعات بازیابی شده هم دقیق و هم کامل باشند، پیادهسازی کرده است:
- تکهبندی ریزدانه (Fine-grained Chunking): بهجای تبدیل تاریخچه طولانی به یک واحد غیرقابل تجزیه، InvMem آن را به قطعات کوچکتر تقسیم میکند. این کار اجازه میدهد بخشهای مختلف از یک تعامل واحد بهطور مستقل بازیابی شوند و تطبیق دقیقتری با پرسش فعلی صورت گیرد.
- بازیابی ترکیبی (Hybrid Retrieval): برای جلوگیری از گم شدن دادههای حیاتی، سیستم دو رویکرد متمایز را ترکیب میکند:
- بازیابی متراکم (Dense Retrieval): معنای مفهومی و شباهتهای انتزاعی را حتی زمانی که کلمات متفاوت باشند، استخراج میکند.
- BM25: تطبیق لغوی را برای عبارات دقیق و کلمات کلیدی خاص مدیریت میکند.
- تلفیق رتبه متقابل وزنی (Weighted RRF): این ابزار سیگنالهای حاصل از بازیابی متراکم و BM25 را در یک رتبهبندی واحد و یکپارچه ادغام میکند. این مرحله ضروری است زیرا مرتبط بودن حافظه بهندرت تکبعدی است؛ یک حافظه ممکن است از نظر معنایی مرتبط باشد اما فاقد یک کلمه کلیدی باشد، یا برعکس.

بازیابی بستر از طریق مجاوریت
بحرانیترین نوآوری این سیستم، «گسترش مجاوریت همان جلسه» (Same-session Adjacency Expansion) است. وقتی سیستم یک تکه بسیار مرتبط را پیدا میکند، در همانجا متوقف نمیشود، بلکه بهطور خودکار نوبتهای گفتگو (Turns) مجاور از همان جلسه مکالمه را نیز فراخوانی میکند.
این رویکرد مشکل «اطلاعات پراکنده» را حل میکند. برای مثال، اگر کاربر در نوبت A مشکلی را شرح دهد، عامل در نوبت B راه حلی را پیشنهاد کند و کاربر در نوبت C تایید کند که مشکل حل شده است، بازیابی تنها نوبت B باعث میشود عامل نداند چرا آن راه حل پیشنهاد شده یا اصلاً اعتباری دارد یا خیر. با گسترش به نوبتهای مجاور، InvMem کل زنجیره شواهد را بازسازی میکند.
این تغییر از «شباهت» به «کامل بودن»، فرض بنیادی حافظه در عاملهای هوشمند را تغییر میدهد. این رویکرد پیشنهاد میکند که «مشابهترین» تکه داده، بهندرت «مفیدترین» تکه است. برای توسعهدهندگان، این به معنای بهینهسازی برای «بازسازی یک روایت» است، نه صرفاً «تطبیق یک بردار».
در عمل، این روش اجازه میدهد عاملها نه تنها یک حقیقت، بلکه استدلال پشت یک تصمیم قبلی و شواهدی که نشان میدهد یک راه حل خاص واقعاً کار کرده است را به یاد آورند. این تحول، سیستم را از یک RAG ساده به سیستمی ارتقا میدهد که جریان تعاملات تاریخی را بهطور کامل درک میکند.
برای مشاهده اینکه سایر سیستمهای حافظه رتبهبالا چگونه تصمیمات مهندسی خود را با معماری InvMem مقایسه میکنند، منتظر سری تحلیلهای فنی آینده AML باشید. هدف این سری از گزارشها، سادهتر کردن درک و مقایسه سیستمهای حافظه از طریق بررسی تصمیمات مهندسی پشت امتیازات جدول ردهبندی است.
گام بعدی شما
- در پیادهسازیهای خود، بهجای تکیه بر Cosine Similarity، مکانیزمهای بازیابی مجاور (Context Window Expansion) را تست کنید.
- ساختار تکهبندی دادههایتان را از بلوکهای ثابت به تکهبندیهای معنایی ریزدانه تغییر دهید.
- نتایج سری تحلیلهای فنی AML را دنبال کنید تا متوجه شوید سایر سیستمهای برتر چه تصمیمات مهندسی متفاوتی نسبت به InvMem گرفتهاند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو