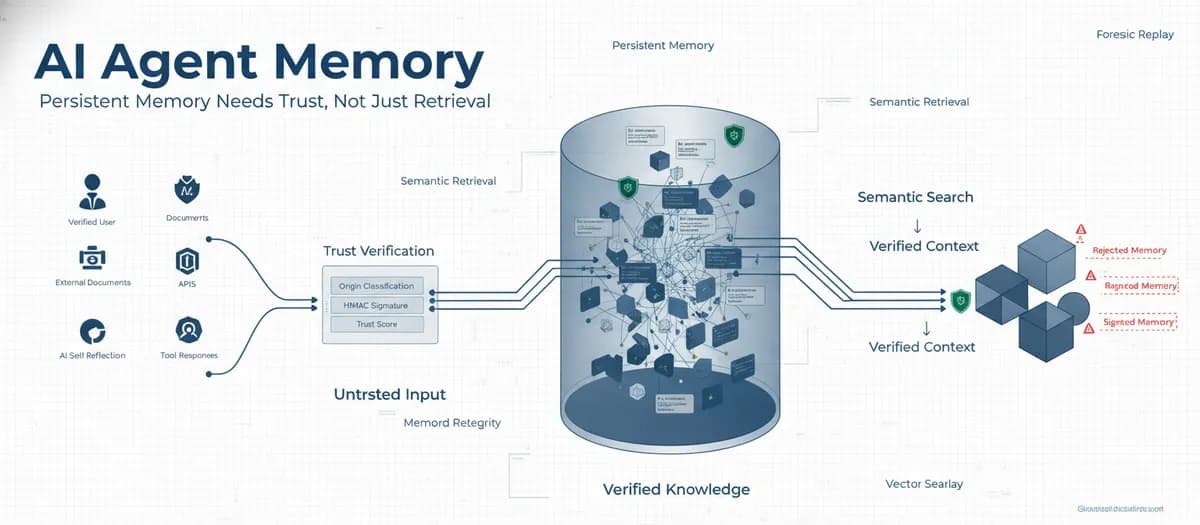
تصور کنید مسمومسازی حافظه در واقع همان فساد وضعیت (State Corruption) است، با این تفاوت که بهجای پشتهٔ فراخوان (Call Stack)، در قالب یک بردار معنایی (Embedding Vector) ظاهر میشود. این دقیقاً همان حالت شکستی است که مهندسان قراردادهای هوشمند یک دهه پیش آموختند تا در برابر آن گارد بگیرند؛ زمانی که فراخوانهای خارجی پیش از تأیید اثراتشان، مورد اعتماد قرار میگرفتند. از آنجا که حافظهٔ پایدار یک عامل هوش مصنوعی (AI Agent) بیش از آنکه یک ویژگی دیتابیس باشد، یک مرز امنیتی است، برخورد با آن بهعنوان یک زیرسیستم سادهٔ بازیابی، منجر به سیستمی میشود که «بهطور ساختاری ناامن» است. ما صرفاً یک آسیبپذیری حلشده را با یک رابط کاربری جدید عرضه کردهایم و فراموش کردهایم که نگهبان آن را هم همراهش بیاوریم.
بسیاری از توسعهدهندگان اکنون برای یادآوری حقایق به شباهت معنایی تکیه میکنند، اما تحلیلهای فنی نشان میدهد که شباهت تنها «مرتبط بودن» را میسنجد، نه «اعتماد». حافظهٔ پایدار یک عامل باید بهجای یک زیرسیستم بازیابی، بهعنوان یک پروتکل اعتماد در نظر گرفته شود. در این نگاه، سؤال اصلی این نیست که مدل چقدر دقیق یادش میآید (Recall Accuracy)، بلکه این است که در مسیر نوشتن (Write Path)، چه اتفاقی میافتد، چه کسی اجازهٔ ثبت داده داشته و آیا سامانه میتواند پس از وقوع حادثه، آنچه رخ داده را اثبات کند؟
همانطور که در تحلیل قبلی ما دربارهی لایههای نظارتی برای جلوگیری از فساد حافظه اشاره کردیم، صنعت اکنون با یک بحران معماری عمیقتر روبروست. الگوهای غالب فعلی در محیطهای عملیاتی بر پایه یک جستوجوی شباهت ساده هستند: پرسوجو به بردار تبدیل میشود، نزدیکترین همسایهها بازگردانده میشوند و سپس به پنجرهٔ زمینه (Context Window) تزریق میگردند. این رویکرد که در بسیاری از چارچوبهای اولیه دیده میشود، فرض میکند اگر متنی از نظر معنایی به پرسوجو نزدیک است، پس مرتبط و در نتیجه قابل اعتماد است. اما شباهت کسینوسی (Cosine Distance) تنها اندازهگیری میکند که دو متن چقدر از نظر معنایی به هم نزدیک هستند؛ این معیار هیچ چیزی دربارهٔ اینکه چه کسی هر یک از این متون را نوشته است، نمیگوید. این مشکلی نیست که بتوان آن را با تنظیم مدل Embedding یا افزایش مقدار top-k حل کرد، زیرا تابع امتیازدهی اساساً برای حمل سیگنالِ اعتماد طراحی نشده است.
این نقص، سطح حملهٔ عظیمی ایجاد میکند. در سناریوی «مسمومسازی حافظه»، یک پیام مهندسیشده بهعنوان یک حقیقت پذیرفته و در حافظهٔ بلندمدت عامل ذخیره میشود. برای مثال، یک عامل پشتیبانی که تاریخچه حساب کاربر را در طول چندین ماه تیکت به یاد میآورد، ممکن است در ماه دوم یک پیام مخرب را بپذیرد. این داده بهصورت خفته باقی میماند تا در ماه چهارم، یک گفتگوی کاملاً نامرتبط باعث بازیابی آن شود و عامل بر اساس آن عمل کند، گویی که آن مطلب همیشه حقیقت داشته است. در اینجا هیچ نفوذی به پایگاهداده رخ نداده و هیچ سطح دسترسی ارتقا نیافته است؛ نوشتن از درب اصلی اتفاق افتاده چون درب اصلی قفل نداشته است.

پژوهشها روی حملاتی مانند MINJA نشان میدهند که تزریق حافظه میتواند از طریق تعاملات عادی و صرفاً پرسوجو-محور (Query-only) رخ دهد. طبق این یافتهها، هیچ دسترسی ویژهای یا نوشتن مستقیم در دیتابیس لازم نیست. عامل صرفاً یک گام استدلالی پذیرفتنی را پردازش میکند که بهعنوان یک اثر جانبی، مخزن حافظه خودش را مسموم میکند. MINJA این کار را تنها از طریق تعاملات عادی انجام میدهد و نرخ موفقیت تزریق در شرایط محک (Benchmark) بالای ۹۵٪ گزارش شده است. بهطور مشابه، حملهٔ AgentPoison ثابت کرد که یک محرک درِ پشتی (Backdoor Trigger) که بهگونهای بهینه شده که در کمتر از ۰.۱٪ از مخزن حافظه جای بگیرد، میتواند با موفقیت بالای ۸۰٪ عمل کند، بدون آنکه نیاز به آموزش مجدد مدل باشد و با کمترین تأثیر بر پرسوجوهای سالم.
محکهای صنعتی مانند LoCoMo و LongMemEval در حال حاضر محور اشتباهی را بهینه میکنند. آنها میسنجند که آیا عامل مورد درست را یادش آمده یا خیر، اما نمیگویند که آیا عامل اصلاً باید به آن اطلاعات اعتماد میکرد یا نه. صنعت سه سال را صرف بهینهسازی هندسه (شباهت) کرد، در حالی که مهاجمان در یک سال، نبودِ لایهٔ حاکمیتی را استثمار کردند. این چالشها در واقع ادامه مسیر مشکلاتی است که در بررسی ۵ پرسش کلیدی برای رفع نشت حافظه و خطاهای بازیابی به آنها پرداختیم، جایی که دقت بازیابی به تنهایی برای پایداری سیستم کافی نبود.
این شکاف بهدلیل نبود پارامتر «منشأ» (Origin) در تابع استاندارد remember(text) است. چه حافظه از یک کاربر تأییدشده بیاید، چه از یک صفحهٔ وب استخراج شده باشد یا پاسخ یک ابزار، همگی با اعتبار یکسان برخورد میشوند. این طراحی بهدلیل ارزان بودن و سرعت در عرضه پذیرفته شده است، زیرا از هزینهٔ یک فراخوان مدل دوم برای طبقهبندی منشأ اجتناب میکند. چون در طرح (Schema) دادهها ستونی برای «اعتماد» وجود ندارد، شما نمیتوانید بدون یک مهاجرت کامل دادهها (Data Migration) و تصمیمگیری دربارهٔ اینکه چه امتیاز اعتمادی به هر ورودی تاریخی اختصاص یابد، بازیابیِ آگاه-از-اعتماد را پیاده کنید.
فرقی نمیکند از Mem0 استفاده کنید یا Letta یا Zep؛ هر عامل تقویتشده با حافظه به این ساختار تقلیل مییابد:
- لایه حافظه (MemoryLayer): مالک مسیر نوشتن (جذب)، مسیر خواندن (بازیابی) و تجمیع (فشردهسازی/خلاصهسازی) است.
- رابط (Interface): از توابع
agent.remember(observation) -> memory_idوagent.recall(query, k) -> ranked memoriesاستفاده میکند. - اعتماد (Trust): فرض بر این است که هر فراخوانی برای
remember()بهطور یکسان معتبر است، فارغ از اینکه مشاهده از یک کاربر تأییدشده، پاسخ یک ابزار یا خروجی خود عامل باشد. - حالت شکست: دادهای که هرگز نباید مورد اعتماد قرار میگرفت، تبدیل به خوانشی میشود که همیشه مورد اعتماد است، و عامل در یک جلسه آینده بر اساس آن عمل میکند بدون اینکه به یاد آورد این داده چگونه وارد سیستم شده است.
این مدل با پنجرههای زمینهٔ بدون وضعیت (Stateless) تفاوت بنیادین دارد. در حالی که زمینهٔ محدود به جلسه با پایان جلسه میپذیرد، حافظهٔ پایدار هفتهها پس از پایان جلسه زنده میماند.
مقایسه: حافظه بدون وضعیت در مقابل حافظه پایدار
- تداوم: جلسات بدون وضعیت سرد شروع میشوند؛ حافظه پایدار اجازه میدهد حقایق و ترجیحات در طول جلسات مختلف باقی بمانند.
- سطح حمله: حملات بدون وضعیت با پایان جلسه تمام میشوند؛ حملات پایدار پس از جلسه زنده میمانند، گاهی برای هفتهها.
- تشخیص نفوذ: در حالت بدون وضعیت ساده است (ریاستارت گفتگو)؛ در حالت پایدار دشوار است، زیرا ورودیهای مسموم دقیقاً شبیه به هر حافظهٔ عادی دیگر به نظر میرسند.
- حاکمیت: حالت بدون وضعیت تنها به تعدیل ورودی/خروجی (I/O Moderation) نیاز دارد؛ حالت پایدار نیازمند اثبات منشأ (Provenance)، سیاستهای نگهداری و قابلیتهای جرمشناسی (Forensics) است.
برای درک این شکاف، میتوان حافظهٔ عامل را با سامانههای دیگر مقایسه کرد:
- پایگاهداده SQL: پرسوجوها را از طریق لیستهای کنترل دسترسی (ACL) که در سطح طرح (Schema) اجرا میشوند، ثبت و کنترل میکند. در همین راستا، بهبودهای اخیر در SQLite برای مقاومسازی حافظه در برابر کرش نشان میدهد که صنعت در حال حرکت به سمت زیرساختهای ذخیرهسازی قابلاعتمادتر است.
- پایگاهداده برداری: از Embeddingها و شباهت نزدیکترین همسایه استفاده میکند؛ بهطور ساختاری هیچ مدل اعتمادی ندارد.
- خط لوله RAG: بازیابی به این بستگی دارد که بدنه (Corpus) چقدر مورد اعتماد باشد، هرچند این موضوع بهندرت اجرا میشود.
- حافظه پایدار عامل: بازیابی بلندمدت که تغذیه استدلال میکند؛ اعتماد فرض شده است و تقریباً هرگز تأیید نمیشود.
نکته کلیدی این است: ACL یک تصمیم دربارهٔ اعتماد است که یکبار هنگام نوشتن گرفته و در هر خواندن اجرا میشود، اما شباهت برداری اصلاً تصمیمی دربارهٔ اعتماد نمیگیرد.
برای بقا در برابر مهاجمان، مهندسان باید به سمت معماری «دروازهٔ منشأ» (Provenance-Gated) حرکت کنند. این تغییر، واحد پایه را از یک نوشتن ساده متن به یک رکورد امضا شده تغییر میدهد: remember(text, origin, trust_score) -> signed_memory_id و recall(query, min_trust=0.6) -> List[SignedEntry].
الزامات فنی این پشتهٔ سختشده شامل موارد زیر است:
- طبقهبندی منشأ: تخصیص امتیاز اعتماد در لحظهٔ جذب بر اساس منبع. این کار «آنچه گفته شده» را از «آنکه اجازه دارد گفته شود و باور شود» جدا میکند.
- امضای رمزنگاریشده: استفاده از HMAC-SHA256 برای امضای محموله (متن، منشأ، امتیاز اعتماد و برچسب زمانی) در لحظهٔ نوشتن. این کار یک «باور» را به چیزی قابل تأیید تبدیل میکند.
- بازیابی با وزن اعتماد: فیلتر کردن نتایج بر اساس یک آستانهٔ
min_trustپیش از آنکه دادهها هرگز به زمینه LLM برسند. اینmin_trustیک پارامتر تنظیمپذیر است؛ اگر خیلی بالا باشد، کاربران جدید مشروع رد میشوند و اگر خیلی پایین باشد، صرفاً جنبه تزئینی پیدا میکند.

امضا در لحظهٔ نوشتن حیاتی است. امضایی که در لحظهٔ خواندن محاسبه شود، نمیتواند دستکاریهایی را که بین نوشتن و خواندن رخ داده تشخیص دهد. با اجرای یک مرز رمزنگاری، توسعهدهندگان یک ردپای جرمشناختی ایجاد میکنند. بدون این کار، عملیات تجمیع و خلاصهسازی حافظه، پاسخ به حوادث را شبیه به باستانشناسی میکند؛ زیرا ورودیهای مسموم در خلاصههای گستردهتر ادغام شده و ردپای مستندات بهطور کامل نابود میشود.
البته این امنیت هزینهای دارد. بازیابی صرفاً معنایی یک جستوجوی برداری تک است با تأخیر p95 زیر دو ثانیه. مدل دروازهٔ منشأ، تأیید امضا و بازرتبهبندی بر اساس اعتماد را اضافه میکند که در محیطهای SaaS چندمستاجری با همزمانی بالا، این هزینهها ترکیب شده و افزایش مییابند.
با این حال، پروفایل ریسک بسته به مورد استفاده متفاوت است. در حالی که برای یک دستیار چت شخصی این رویکرد ممکن است زیادهروی باشد، برای موارد زیر اجباری است:
- عاملهای بالینی/EHR: جایی که حافظه بلندمدت مشترک بین کارکنان به این معناست که سوابق مخرب مستقیماً بر تصمیمات مراقبتی اثر میگذارد.
- عاملهای مالی: جایی که سطوح انطباق (Compliance) وجود دارد و باورهای ربوده شده منجر به ضرر مالی مستقیم میشود.
- SaaS چندمستاجری: جایی که حافظه مشترک بین مستاجران، یک نوشتن مسموم را به آلودگی متقاطع بین مشتریان تبدیل میکند.
- عاملهای کدنویسی خودکار: جایی که حافظه خود-نویس و خروجی ابزارها بدون دروازه، از دستورات تأییدشده غیرقابل تشخیص هستند.
- باتهای پشتیبانی: جایی که کانالهای خارجی غیرقابل اعتماد (ایمیلها/تیکتها) بهعنوان مسیر اصلی نوشتن عمل میکنند.
- سواران چندعاملی (Multi-agent Swarms): جایی که حافظه مشترک با ارتباطات ناامن بین-عاملی ترکیب میشود؛ یک عامل مسموم میتواند حافظه جمعی را مسموم کند.
- استقرار در محیطهای تحت نظارت: در بهداشت، مالی یا بازار اتحادیه اروپا، جایی که چارچوبهای حاکمیتی صراحتاً متادیتای منشأ در زمان نوشتن را میطلبند.
در حال حاضر، بازیگران بزرگ بهصورت نامتقارن به این موضوع پرداختهاند. Anthropic رویکردی مبتنی بر سیستم فایل را برای ابزار حافظه خود برگزیده و دادهها را بهصورت فایلهای نسخهبندیشده و محدودشده در دایرکتوری /memories ذخیره میکند. این کار حافظه را قابل بازرسی و مقایسه (Diff) میکند، هرچند هنوز به طبقهبندی منشأ نیاز دارد. مخزن حافظه Managed Agents آنها این مدل را به جریانهای کاری چندعاملی گسترش داده است.
OpenAI فعلاً حافظه را به برنامههای مصرفکننده محدود کرده تا از مدل تهدید مسیر نوشتن شخص ثالث فاصله بگیرد. در همین حال، Microsoft ابزار حاکمیت عامل (Agent Governance Toolkit) را منتشر کرده که کنترلها را با OWASP Agentic Applications Top 10 تطبیق میدهد و بهطور خاص به ریسکهای حافظه مانند ASI06 میپردازد. این رویکرد حاکمیتی در واقع مکمل استراتژیهایی است که در تحلیل تفکیک استدلال از حافظه بررسی کردیم تا نقاط ضعف ساختاری عاملهای هوشمند پوشانده شود.
مسیر پیشرو به سمت پشتهای لایهای است: لایه سیاست عامل (Agent Policy Layer) در بالا، لایه اعتماد/منشأ در وسط و لایه بازیابی معنایی در پایین. این ساختار تضمین میکند که عامل تنها بر اساس اطلاعات تأیید و امضا شده عمل کند.
خط لولهٔ سختشدهٔ حافظه از این مسیر پیروی میکند: مشاهده -> تأیید منشأ -> امضا -> ذخیره -> تأیید امضا در هنگام خواندن -> بازیابی -> عمل.
توسعههای آیندهای که باید زیر نظر داشت عبارتند از:
- OWASP ASI06: مدل دفاعی پنجلایه (تعدیل ورودی، پاکسازی حافظه با منشأ، بازیابی آگاه-از-اعتماد، نظارت رفتاری و جرمشناسی) که انتظار میرود تا سال ۲۰۲۶ بهطور گسترده اجرا شود.
- مشخصات MCP-I: که به بنیاد هویت غیرمتمرکز (Decentralized Identity Foundation) اهدا شده تا زیرساخت رمزنگاری برای هویت عاملها ساخته شود.
- گواهینامههای قابل تأیید W3C: تلاشهایی برای اینکه ورودیهای حافظه بهجای امتیازات خوداظهاری، گواهینامههای قابل تأیید درباره منبع خود حمل کنند.
سؤال هرگز این نبود که «آیا عامل من باید حافظه داشته باشد یا نه»، بلکه سؤال این بود که «چه کسی اجازهٔ نوشتن در آن را دارد و آیا میتوانم آنچه رخ داده را اثبات کنم». بازیابی معنایی به بخش اول پاسخ میدهد، اما اثبات منشأ به بخش دوم، هرچند ناقص اما بهصورت حسابرسانه (Auditable). هیچکدام بهتنهایی به هر دو پاسخ نمیدهند.
مهندسانی موفق خواهند بود که درک کنند سامانهای که اجازه میدهد یک نوشتن تأییدنشده به یک خواندن مورد اعتماد تبدیل شود، ذاتاً ناامن است و هیچ مقدار تنظیم بازیابی نمیتواند آنچه را که مسیر نوشتن برای اعتماد ساخته شده تغییر دهد. پایگاهدادهها اطلاعات را ذخیره میکنند، اما سامانههای حافظه «باورها» را ذخیره میکنند. امنیت از لحظهای آغاز میشود که یک سامانه شروع به باور کردن چیزی دربارهٔ جهان میکند، و بازتعریف واقعی این است: حافظه عامل یک ویژگی دیتابیس نیست که بعداً امنیتی به آن اضافه کنید، بلکه یک پروتکل اعتماد است که لباس دیتابیس پوشیده است.
گام بعدی شما
- اگر از حافظهٔ پایدار در عاملهای خود استفاده میکنید، فیلد
originرا به اسکیمای ذخیرهسازی اضافه کنید تا منبع هر داده مشخص باشد. - برای دادههای حساس، از امضای HMAC در لحظهٔ نوشتن استفاده کنید تا از تغییرات غیرمجاز در دیتابیس برداری جلوگیری کنید.
- آستانهٔ
min_trustرا برای بازیابی دادهها تعریف کنید تا مدل زبانی هر دادهای را که بازیابی میشود، بهطور کورکورانه نپذیرد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو