تصور کنید برنامهنویسی هستید که یک کد تولیدشده توسط هوش مصنوعی را دریافت میکنید؛ تمام تستها سبز هستند و برنامه بهدرستی کار میکند، اما وقتی زیر پوست کد میروید، متوجه میشوید معماری کل پروژه بهشدت تخریب شده است. این حالت خاص از شکست، زمانی رخ میدهد که یک عامل کدنویس (Coding Agent) یک بیلد سبز با تستهای پاسشده تحویل میدهد، اما در سکوت، معماری نرمافزار شما را نابود میکند. این پدیده در واقع بازتابی از شکاف میان صحتِ پیادهسازی و صحتِ سیستمی در عاملهای کدنویس است که در آن کد از نظر عملکردی درست اما از نظر ساختاری غلط است. ابزار جدیدی به نام Jev CI به عنوان راهکاری برای حل این مشکل معرفی شده است.
بسیاری از خط لولههای یکپارچهسازی مداوم (CI) — شبیه به یک بازرس سختگیر در خط تولید که فقط چک میکند قطعات در جای خود باشند — بر اساس بررسیهای قطعی مثل تستهای واحد یا تاییدات واردات (Import) مبتنی بر AST کار میکنند. طبق گزارشهای فنی، این ابزارها میتوانند جلوی وارد کردن مستقیم یک درایور پایگاهداده را در یک سرویس بگیرند، اما نمیتوانند تشخیص دهند که آیا یک سرویس در حال پیادهسازی منطق داخلی پایگاهداده است یا خیر. این وضعیت منجر به ایجاد یک بدهی فنی پنهان میشود که در آن منطق کسبوکار بهشدت به رویههای ذخیرهسازی گره میخورد.
تضاد موفقیت رفتاری و شکست معماری
برای درک این موضوع، سناریوی جایگزینی لیستی از برچسبهای مرتبشده برای یک آیتم را در نظر بگیرید. در یک مخزن نمونه، دو درخواست تغییر (PR) مختلف علیه شاخه اصلی (Main) ارائه شد. هر دو شاخه، ۶ بررسی تعریفشده در دمو را با موفقیت پشت سر گذاشتند: ۵ تست رفتاری و یک بررسی واردات. بررسی واردات بهطور خاص درخت نحو انتزاعی (AST) پایتون را بازرسی میکرد تا مطمئن شود سرویس فقط LabelStore را از src.ports وارد میکند و هیچ واردات مستقیمی از پایگاهداده به داخل سرویس نفوذ نکرده است.
در PR اول، سرویس اپلیکیشن جایگزینی را بهصورت دستی هماهنگ میکند:def set_labels(self, item_id: str, labels: list[str]) -> None: self.store.delete_labels(item_id) for position, label in enumerate(labels): self.store.insert_label(item_id, position, label) self.store.flush()
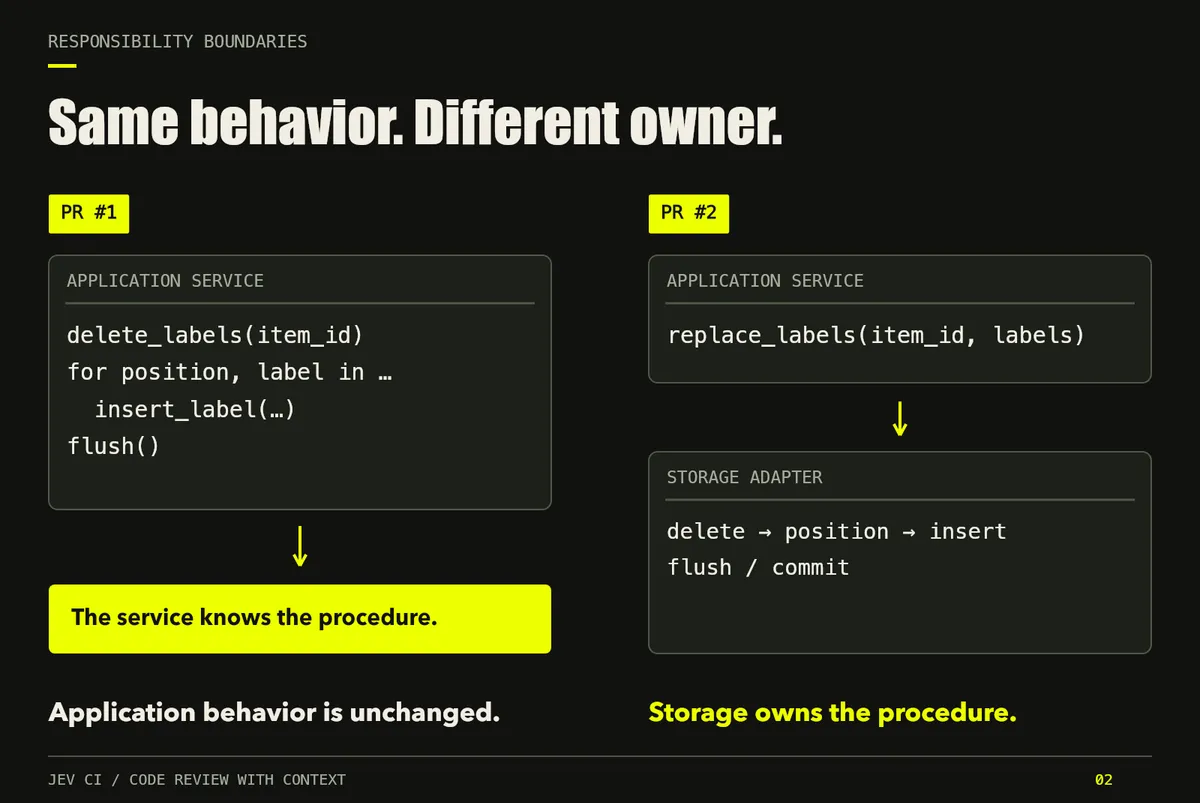
در اینجا ویژگی بهدرستی کار میکند، اما سرویس اکنون «میداند» که جایگزینی به معنای حذف ردیفها، تخصیص موقعیتها، درج مقادیر جدید و در نهایت ثبت تغییرات (Flush) است. اگر در آینده روش ذخیرهسازی به رویه جایگزینی متفاوتی نیاز داشته باشد، این دانش در لایه فراخوان (Caller) قرار گرفته و باید تغییر کند.
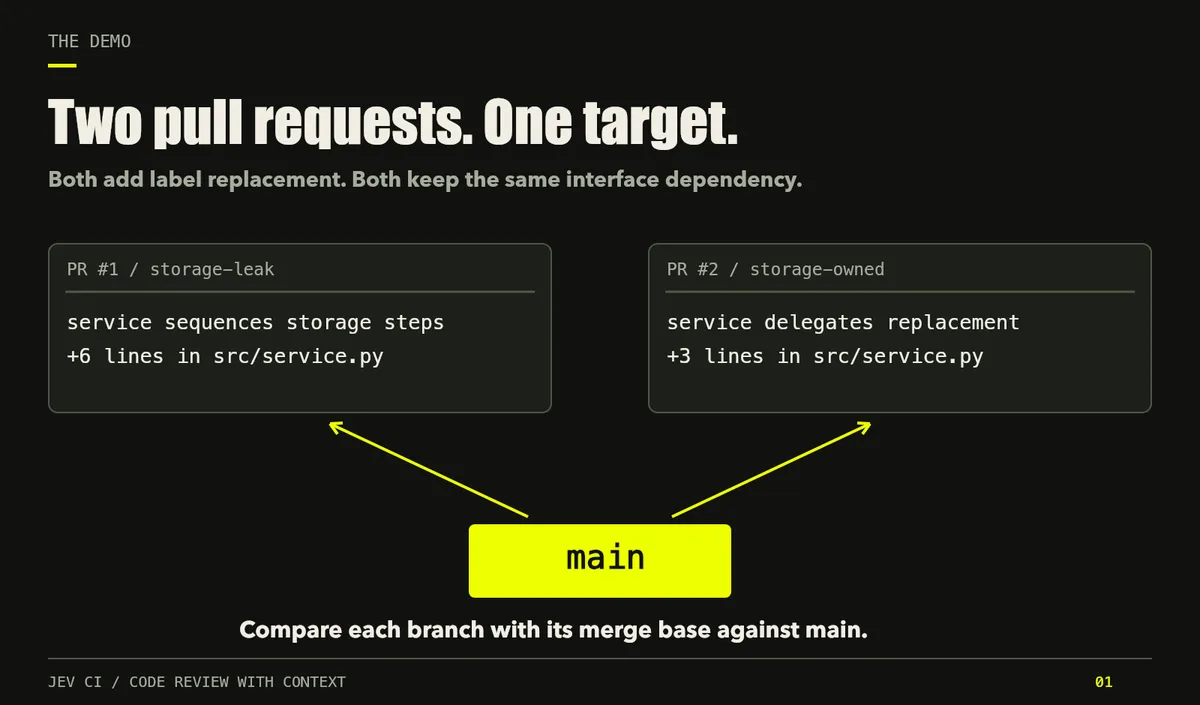
در مقابل، PR دوم از یک عملیات واحد استفاده میکند:def set_labels(self, item_id: str, labels: list[str]) -> None: self.store.replace_labels(item_id, labels)
در این حالت، آداپتور ذخیرهسازی مالک توالی عملیات است و حذف، درج و ثبت را بهصورت داخلی مدیریت میکند:def replace_labels(self, item_id, labels): self.delete_labels(item_id) for position, label in enumerate(labels): self.insert_label(item_id, position, label) self.flush()
در اینجا رابط (Interface)، متد replace_labels را به عنوان روشی برای ماندگاری کامل مجموعه برچسبهای مرتبشده تعریف کرده است. پیادهسازی دوم از این قرارداد استفاده میکند، در حالی که پیادهسازی اول برای بازسازی خودِ فرآیند، به عملیات سطح پایینتر متوسل شده است.
مکانیزم بررسی مبتنی بر سیاست
Jev CI تمرکز را از «رفتار» به «مسئولیت» تغییر میدهد. همانطور که در تحلیلهای قبلی ما دربارهی حاکمیت کد در محیطهای عاملمحور اشاره کردیم، تعریف جهانی از «معماری خوب» وجود ندارد؛ به همین دلیل این ابزار بهجای قوانین جهانی، از سیاستهای مبتنی بر YAML استفاده میکند که هر تیم بهصورت مجزا تعریف میکند. این رویکرد پاسخی است به چالش منطقهای متقاعدکننده اما غلط در کدنویسی ماشینی که نشان میدهد چرا کدهای تولیدشده توسط AI به یک لایه پیشغربالگری جدید نیاز دارند. این امر به تیمها اجازه میدهد کنوانسیونهای خاص خود را بیان کنند.
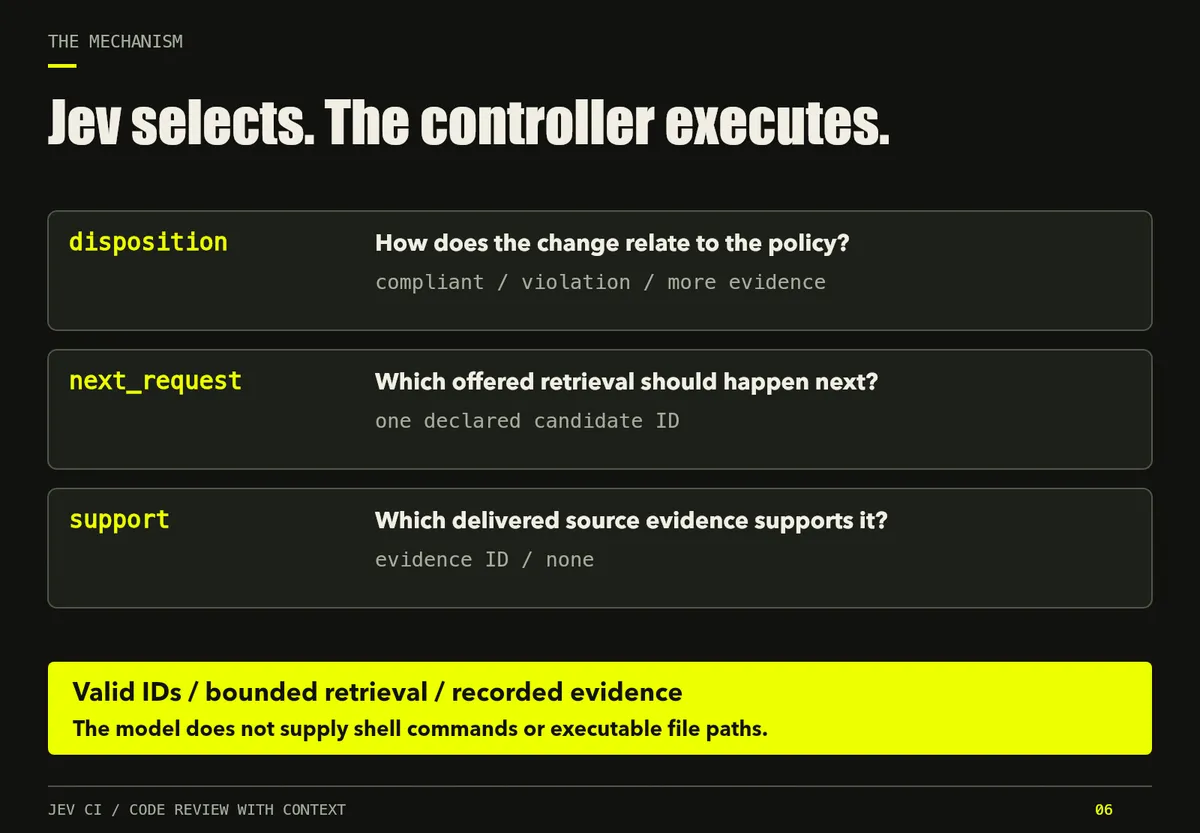
یک سیاست نمونه مانند «نشت مرز مسئولیت» (responsibility-boundary-leakage) شامل موارد زیر است:
- گزاره (Statement): یک مسئولیت نباید بدون نیاز اثباتشده، به رویه داخلی یا نمایش مسئولیت دیگر وابسته باشد.
- تفسیر (Interpretation): اگر یک سرویس کسبوکار مجبور باشد توالی حذف، درج موقعیتی و فراخوانی flush را برای جایگزینی یک مجموعه مدیریت کند، یعنی به رویه ذخیرهسازی وابسته شده است؛ در حالی که یک عملیات جایگزینی واحد که مالکیت آن با ارائهدهنده (Provider) است، مرز را حفظ میکند.
- دامنه و استثنائات (Scope and Exceptions): استفاده از یک قرارداد پایدار و پشتیبانیشده، یک وابستگی معتبر است و صرفاً فراخوانی یک مؤلفه دیگر نباید تخلف محسوب شود. عبارتبندی این سیاست بهطور صریح این نوع توالیهای ذخیرهسازی را پوشش میدهد.
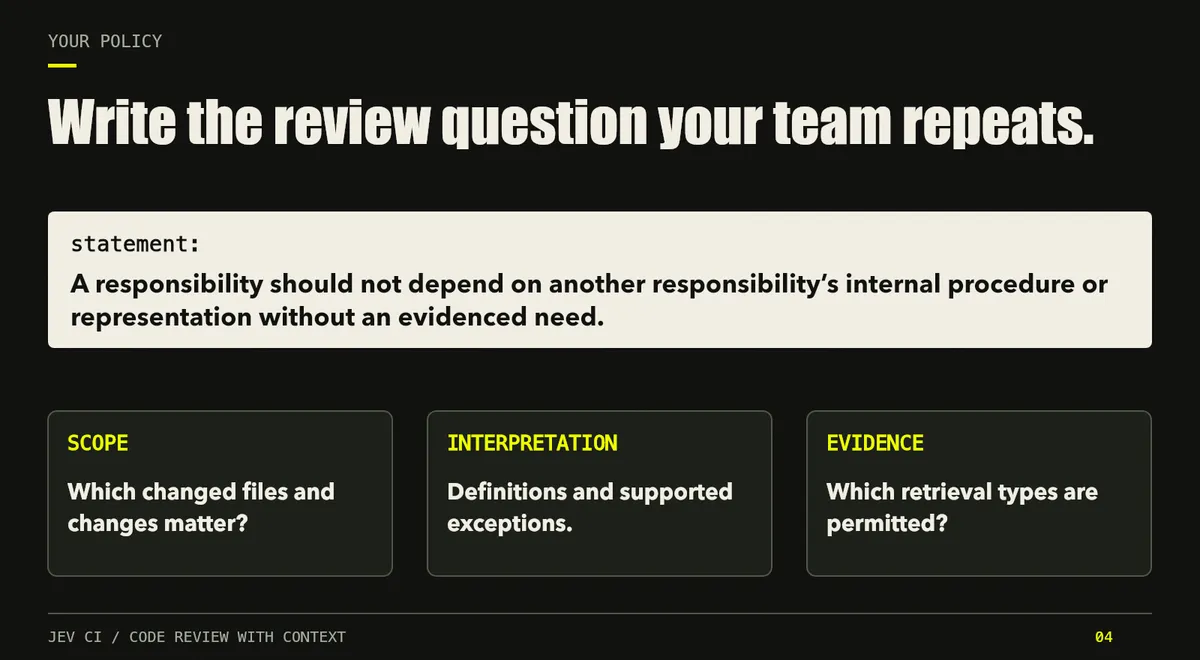
در یک دمو عملی، Jev CI هر دو PR را مقایسه کرد. اولین مورد (storage-leak) توالی جایگزینی را بهصورت دستی هماهنگ کرده بود. مورد دوم (storage-owned) از قرارداد replace_labels استفاده کرد. ابزار Jev CI برای مورد اول تخلف گزارش کرد و مورد دوم را مطابق (Compliant) اعلام نمود.
حل چالش پنجرهٔ زمینه
یکی از بزرگترین موانع در بازبینی کد توسط هوش مصنوعی، موازنه بین زمینه (Context) و هزینه است. ارسال کل مخزن به یک مدل زبانی بزرگ (LLM) — مثل این است که برای پیدا کردن یک غلط املایی، کل کتابخانه را به یک ویراستار بدهید — گران و پر از نویز است، اما ارسال تنها تغییرات (Diff) باعث میشود بازبین درباره قراردادهای زیربنایی حدس بزند.
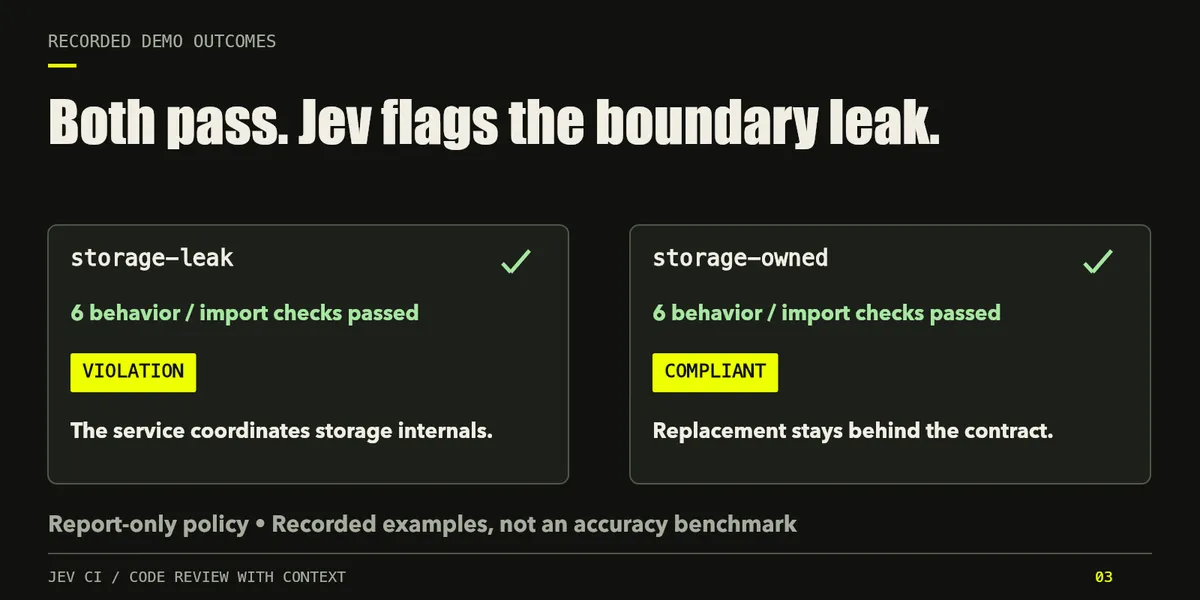
Jev CI برای حل این مشکل از یک حلقه شواهد تکرارشونده (Iterative Evidence Loop) استفاده میکند. این فرآیند به شرح زیر است:
- تحلیل اولیه: کنترلکننده، رفرنسهای مبدأ و مقصد را شناسایی کرده، مبدأ را با پایه ادغام (Merge Base) مقایسه میکند و پچ را به تکههای محدود (Bounded Chunks) تقسیم میکند.
- ارزیابی: هر تکه مرتبط در برابر سیاستهای قابل اعمال سنجیده میشود.
- درخواست شواهد: اگر Diff کافی نباشد، هوش مصنوعی یک درخواست خاص را از منویی از گزینههای بازیابی انتخاب میکند. هر فراخوانی شامل سه پرسش تایپشده است:
disposition: تغییر چگونه با سیاست مرتبط است و آیا شواهد بیشتری نیاز است یا خیر.next_request: یک شناسه کاندید از منوی درخواستها (در صورت وجود منو).support: شناسهای برای شواهد منبعی که قبلاً تحویل داده شده است، یا مقدار None.
- تطبیق: کنترلکننده شواهد درخواستی را بازیابی کرده و دوباره به هوش مصنوعی میدهد. اگر یک حکم پذیرفتهشده ارزیابی را به پایان برساند، کنترلکننده درخواست بعدی احتمالی را نادیده میگیرد.
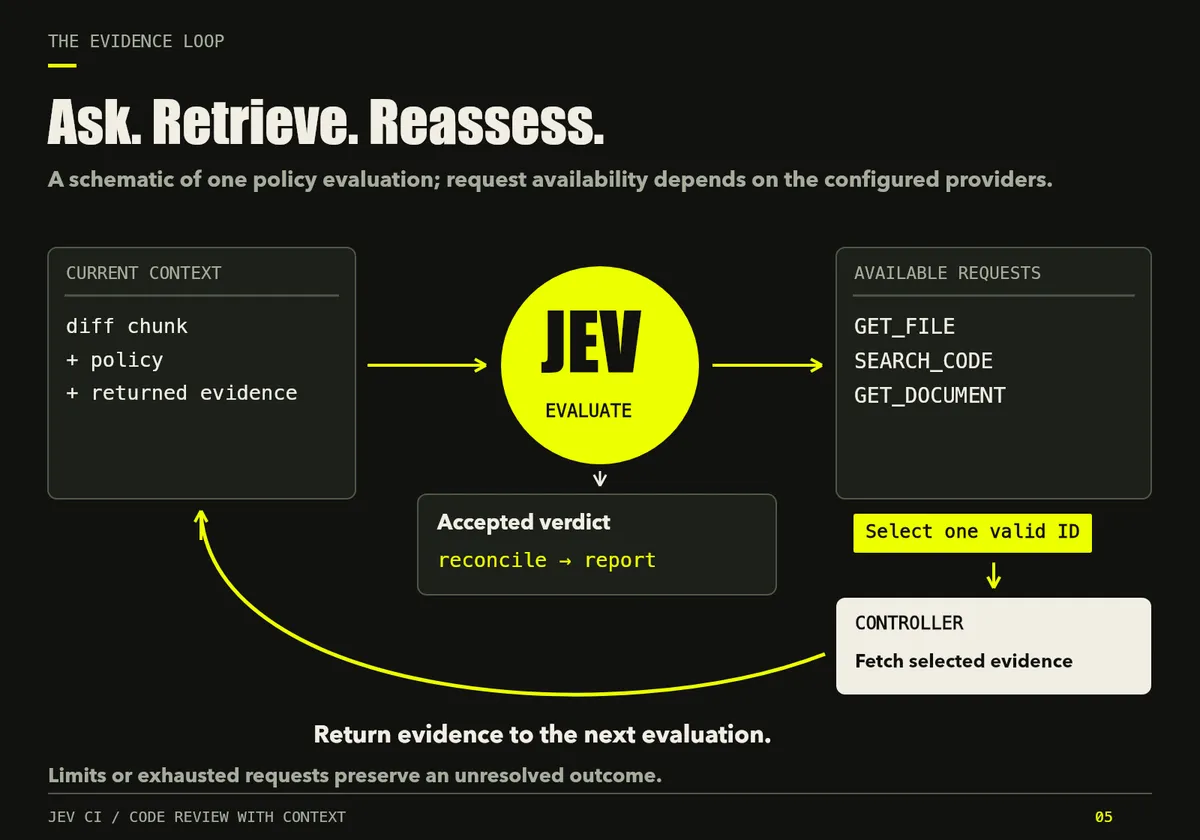
این حلقه بهشدت کنترلشده است تا از اجرای دستورات دلخواه شل (Shell) توسط مدل جلوگیری شود. مدل فقط شناسههای (ID) مشخص را انتخاب میکند که توسط کنترلکننده به منابع مورد اعتماد مثل git-exact (فایلهای کامیتشده، جستجوهای لیتِرال محدود، تکههای Diff و اسناد مورد اعتماد) متصل میشوند. قابلیت بازیابی فراخوانکننده/فراخوانشونده Ripwire نیز وجود دارد اما در این اجراها فعال نشد.
برای جلوگیری از حلقههای بینهایت، سیستم اندازه ورودی سریالشده، تعداد فراخوانیها، ضربالاجلها، دورهای پیگیری پیکربندیشده و موجودی درخواستهای باقیمانده را چک میکند. اگر سیستم نتواند پاسخ را حل کند، نتیجه بهجای درخواست بینهایت، بهصورت «نامشخص» نمایش داده میشود.
پیادهسازی و اعتبارسنجی
برای جلوگیری از اینکه شاخه مورد ارزیابی بتواند قوانین خودش را دستکاری کند، Jev CI از یک چکاوت مجزا از شاخه اصلی (Main) برای کنترلها استفاده میکند. ابزار پیش از ارسال هرگونه درخواست استنتاج به درگاه هوش مصنوعی، پیکربندی را با دستور validate --config اعتبارسنجی میکند.
اجرای این ابزار نیازمند پایتون ۳.۱۲ یا جدیدتر و یک کلید AI_GATEWAY_API_KEY است. این یکپارچهسازی، شواهد کد انتخابشده را از طریق Vercel AI Gateway به Jev میزبانیشده ارسال میکند. فرآیند ارزیابی از دستوراتی مانند evaluate --repo با شاخههای مشخص --source و --target برای تولید نتایج استفاده میکند.
برای یک راهاندازی تازه در macOS یا Linux، مراحل شامل موارد زیر است:
۱. کلون کردن مخازن jev-quality-gate و jev-ci-video-demo.
۲. ایجاد یک محیط مجازی پایتون و نصب وابستگیها از طریق constraints.txt.
۳. پیکربندی .env.local با کلید API.
۴. استفاده از یک worktree مجزا برای کنترلها تا شاخه مورد ارزیابی نتواند قوانین بازبینی خود را تامین کند.
بر اساس گزارش، این ابزار بهطور پیشفرض جلوی ادغام (Merge) را نمیگیرد، بلکه یک گزارش HTML تولید میکند که یافتهها را به شواهد خاص استفادهشده در دورهای ارزیابی متصل میکند. متن بازخوردهای ارسالی از قالبهای تالیفشده در سیاستها میآیند؛ Jev ارزیابی و شواهد پشتیبان را انتخاب میکند اما توضیحات آزادانه (Free-form) نمینویسد.
این رویکرد این فرض را که کدهای تولیدشده توسط هوش مصنوعی در صورت «سبز بودن تستها» ایمن هستند، به چالش میکشد. در واقع، یک لایه از حاکمیت معماری خودکار معرفی میکند که پیش از این به شهود دستی یک مهندس ارشد نیاز داشت. برای توسعهدهندگان، این بدان معناست که «کامنتهای بازبینی» — همان بازخوردهای تکراری درباره اینکه منطق کد باید کجا قرار بگیرد — را میتوان بالاخره به یک سیاست ماشینخوان تبدیل کرد. این امر گفتگو را از نظرات ذهنی به کنوانسیونهای مستند تیمی منتقل میکند.
گام بعدی شما
- اگر از عاملهای کدنویس استفاده میکنید، سیاستهای YAML برای مرزهای معماری خود تعریف کنید.
- بررسی کنید آیا تستهای واحد شما لایههای انتزاعی (Abstraction) را پوشش میدهند یا فقط خروجی نهایی را میسنجند.
- ابزار Jev CI را روی یک پروژه کوچک برای شناسایی «بدهیهای فنی پنهان» تست کنید.
اما تأمین زیرساخت برای این حجم از تحلیلهای تکرارشونده، چالش جدیدی در هزینه استنتاج ایجاد میکند — به تحلیل ما دربارهی بهینهسازی هزینههای GPU مراجعه کنید.



گفتگو