
تصور کنید بخواهید با مدلی صحبت کنید که اصلاً برای گفتگو طراحی نشده و تنها بلد است بین چند گزینه تصمیم بگیرد. پروژه JevChat که در ۲۰ سپتامبر ۲۰۲۶ منتشر شد، دقیقاً همین کار غیرممکن را انجام میدهد و یک مدل تصمیمگیر را به زور در قالب یک چتبات میگنجاند. به جای اینکه مدل سعی کند یک جمله کامل را پیشبینی کند، سیستم در هر گام یک سؤال واحد از مدل Jev میپرسد: با توجه به متن فعلی، کدام نماد (حرف یا کلمه) دقیقاً در جایگاه بعدی قرار میگیرد؟
این ابزار بر پایه مدل Jev بنا شده است که پیشتر توانسته بود تأخیر تصمیمگیری هوش مصنوعی را به ۷۰ میلیثانیه کاهش دهد و اکنون در JevChat برای تولید متن به کار گرفته شده است.
اکثر مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — از معماری ترنسفورمر بومی (Native Transformer) برای پیشبینی توکنها در یک گذر سریع استفاده میکنند. اما JevChat با مدل مانند یک داور برخورد میکند که فهرستی از نویسهها یا کلمات احتمالی بعدی را رتبهبندی میکند. گزینهها شامل یک الفبای منتخب به اضافهی گزینهای برای توقف تولید متن است. مدل Jev برای هر گزینه یک احتمال برمیگرداند و نمونهگیر (Sampler) نماد بعدی را از این توزیع نرمالشده استخراج میکند. این فرآیند الحاق و تکرار تا زمانی که نماد STOP (توقف) انتخاب شود، ادامه مییابد.
این رویکرد، مدلی که برای طبقهبندی (Classification) — شبیه به دستهبندی نامهها در پوشههای مختلف — طراحی شده بود را به مدلی تبدیل میکند که متن را نماد به نماد تولید میکند. سازنده پروژه این روش را یک «آزمایش شتابیافته با Claude» مینامد؛ به این معنا که توسعهدهنده الگوریتمهای نمونهگیری و استراتژیهای آن را برای Claude شرح داده و سپس Claude پیادهسازی کدها را انجام داده است.
همانطور که در تحلیلهای قبلی ما دربارهی انعطافپذیری مدلهای بنیادی اشاره کردیم، مرز بین مدلهای تحلیلگر و مولد در حال کمرنگ شدن است.
تنظیمات و محیط اجرا
برای راهاندازی این سیستم، کاربران باید کلید Jev خود را در یک فایل .env در کنار فایل pyproject.toml قرار دهند. سیستم کلیدهای JEV_API_KEY و TYPESAFE_API_KEY را میپذیرد. طبق گزارش توسعهدهنده، مقادیر موجود در فایل .env بر متغیرهای محیطی (Environment Variables) صادر شده در سیستم اولویت دارند.
تعامل با ابزار از طریق چندین دستور Poetry انجام میشود:
poetry run jevchat: شروع گفتگوی تعاملی.poetry run jevchat ask "[question]": اجرای یک پرسش واحد.poetry run jevchat alphabets: مشاهده لیست الفباهای موجود برای نمونهگیری.poetry run jevchat bench: مقایسه عملکرد تمام حالتها در قالب یک جدول.
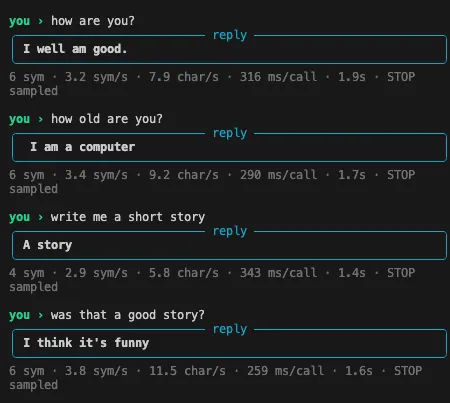
در حین تولید متن، پاسخ در پنلی با readout زنده ظاهر میشود. این پنل شامل نرخ تولید بر حسب نماد در ثانیه (symbols/s) و نویسه در ثانیه (characters/s)، میلیثانیه برای هر فراخوانی API و زمان سپریشده است. همچنین، چند نماد برتری که Jev در گام آخر به آنها امتیاز داده است نمایش داده میشود تا کاربران بتوانند توزیعی را که نمونهگیر از آن استخراج میکند، مشاهده کنند.
مکانیزمهای فنی نمونهگیری
JevChat بسته به اندازه الفبا، از استراتژیهای متفاوتی (با سوئیچ -s یا --strategy) برای تعیین نماد بعدی استفاده میکند:
- Choice: حالت پیشفرض که یک سؤال واحد درباره کل الفبا میپرسد. این حالت میتواند با
--no-shuffle-criteriaاجرا شود تا بازآرایی (Re-ordering) که برای خنثی کردن سوگیری موقعیتی (Position Bias) مدل Jev استفاده میشود، حذف گردد. همچنین با دستور--ensemble(مثلاً--ensemble 4) میتوان میانگین چندین بازآرایی را که به صورت سؤالات موازی در یک درخواست ارسال شدهاند، محاسبه کرد. - Bisect: این روش الفبا را مرتب کرده و سؤالات «بله/خیر» دربارهی بخشهای ابتدایی یا انتهایی میپرسد تا گروه گزینهها کوچک شود و سپس یک سؤال Choice میپرسد. این روش با استفاده از
--bisect-cutoff(مثلاً ۳۲) و--no-bisect-swapبرای کاهش هزینهها (از طریق پرسیدن هر تقسیمبندی تنها یک بار) بهینهسازی میشود. - Buckets: تنها استراتژی قادر به مدیریت بیش از ۲۵۵ نماد است. این روش الفبا را در چندین سؤال تقسیم میکند که هر کدام دارای یک گزینه فرار «OTHER» هستند. این حالت برای مجموعههای بزرگتر مانند
words1kیاbpe5kضروری است. - Refine: حالتی با دقت بالا که ابتدا از Buckets استفاده میکند، سپس سؤالی درباره برندگان میپرسد و در نهایت یک هسته (Nucleus) را مجدداً رتبهبندی میکند. این روش احتمال انتخاب نماد درست را دو برابر کرده و تقریباً ۱۹ برابر واژگان بیشتری را حل میکند. کاربران میتوانند این حالت را با
--refine-nucleusو--refine-roundsتنظیم کنند.
گزینههای الفبا و نوآوری در ارائه
کاربران میتوانند با دستور -a یا --alphabet سطح جزئیات تولید را تغییر دهند:
- lower26: محدود به حروف a-z و فاصله.
- ascii: اجازه میدهد مدل هر چیزی را هجی کند.
- tokens: از کلمات کامل استفاده میکند.
- words1k، bpe2k و bpe5k: واژگان بزرگتری که نیازمند استراتژی Buckets هستند.
یکی از پیشرفتهای فنی چشمگیر در این پروژه، حالت ارائه «فرضیه» (-p hypothesis) است. در این حالت، بهجای اینکه از مدل خواسته شود یک نماد لخت (مثلاً 'a') را قضاوت کند، سیستم کل رشتهی متنی حاصل را ارائه میدهد. برای مثال، اگر متن «The capital of France is Par» باشد، گزینهها به صورت «...is Para»، «...is Pari» و «...is Pars» ارائه میشوند.
در حالت قدیمیتر یعنی symbol (نماد)، مدل Jev مجبور بود گزینه را در ذهن خود الحاق کند و از دستورالعملهایی پیروی کند که میگفت: «دستور زبان و املا را روی حاصل الحاق قضاوت کن، نه روی خود گزینه به تنهایی». حالت فرضیه ابتدا الحاق را انجام میدهد و به Jev اجازه میدهد رشتههای تکمیلشده را رتبهبندی کند. این تغییر باعث شد صحت (Accuracy) رتبهی اول در الفباهای نویسهای تقریباً سه برابر شود و جرم احتمالی (Probability Mass) روی نماد درست دو برابر گردد، در حالی که توکنهای ورودی کمتری مصرف میشود.
برای کسانی که میخواهند آزمایش کنند، قابلیت جستوجوی پرتویی (Beam Search) با سوئیچ -b اضافه شده است. سیستم بهجای متعهد شدن به نماد به نماد، سه پاسخ کاندید را زنده نگه میدارد تا از خطاهای زودهنگام جلوگیری کند. هزینه این کار، یک امتیاز برای هر پرتوی زنده در هر گام است. وقتی عرض پرتوی (Beam Width) بیش از ۱ باشد، پارامترهای Temperature، top_p و top_k دیگر اعمال نمیشوند، زیرا پرتوها بر اساس احتمال رتبهبندی میشوند و نه از طریق نمونهگیری تصادفی.
از نظر عملی، این معماری عمداً ناکارآمد طراحی شده است. سازنده پروژه اشاره میکند که هزینه این روش «تا حدی غیرعملی» است و هدف اصلی، سرگرمی و آزمایش است که نتایجی را به همراه دارد که اغلب «خندهدار» هستند.
برای جامعه توسعهدهندگان، این پروژه این فرض را که هوش مصنوعی مولد نیازمند یک معماری خاص رمزگشایی (Decoder) است، تغییر میدهد. این نشان میدهد هر مدلی که قادر به رتبهبندی گزینهها باشد، میتواند یک گفتگو را شبیهسازی کند. در واقع، این سیستم با مدل LLM مانند یک CPU و با حلقه نمونهگیری مانند مجموعه دستورالعملهای (Instruction Set) آن برخورد میکند.
کاربران میتوانند نشست خود را با دستورات چت مانند /help ، /alphabet [name] ، /temp <v> ، /stop-bias <v> ، /reset ، /stats و /exit مدیریت کنند. این پروژه شامل ۱۵۸ تست آفلاین است که با استفاده از یک کلاینت جعلی اسکریپتی و httpx.MockTransport برای لایه HTTP اجرا میشوند تا اطمینان حاصل شود که حلقه بدون نیاز به کلیدهای API یا دسترسی به شبکه، پایدار باقی میماند.
گام بعدی شما
- اگر به مدلهای تصمیمگیر دسترسی دارید، سعی کنید با متد Hypothesis دقت رتبهبندی را تست کنید.
- برای کاهش هزینه در مدلهای مشابه، استراتژی Bisect را جایگزین Choice کنید.
- بررسی کنید آیا مدلهای طبقهبندی فعلی شما میتوانند با یک حلقه نمونهگیری ساده، خروجیهای متنی تولید کنند؟
اما تأثیر این رویکرد بر مدلهای کوچکتر و محلی حتی جذابتر است — به تحلیل ما دربارهی مدلهای زبانی کوچک (SLM) مراجعه کنید.



گفتگو