تصور کنید برنامهنویسی را استخدام کردهاید که یک ساعت کامل را صرف مطالعه کدها میکند، اما در نهایت حتی یک خط کد هم نمینویسد. این اتفاق دقیقاً در ۱۷ سپتامبر ۲۰۲۶ برای یکی از عاملهای هوش مصنوعی شرکت Legion رخ داد؛ بنبستی سیستمی که نه از توهم یا تنبلی مدل، بلکه از مدیریت بیش از حد سختگیرانه حافظه نشأت میگرفت.
به گزارش وبسایت dev.to، این عامل در حلقهای گرفتار شده بود که فایلها را میخواند، اما لایه بهینهسازی «هوشمند» سامانه، بلافاصله محتوای خواندهشده را از حافظه پاک میکرد. مدیریت پنجره متنی (Context Window) — که شبیه میز کاری است که فقط جای چند ورق کاغذ دارد و نه کل کتابخانه — بزرگترین چالش توسعهدهندگان عاملهای مبتنی بر مدل زبانی بزرگ (LLM) است. همانطور که در تحلیلهای پیشین ما درباره امنیت و پایداری مدلهای بازمتن اشاره کردیم، تعادل بین هزینه و دقت، مرز بین یک ابزار کاربردی و یک سیستم ناکارآمد است.
وقتی یک عامل از ابزارها استفاده میکند — مثلاً فایلی را میخواند، دستور grep اجرا میکند یا تست میگیرد — تاریخچه پرامپتها بهشدت حجیم میشود و هزینهها بهصورت نمایی (Quadratic) رشد میکنند. در واقع، نتیجه هر مرحله از مراحل قبلی، در هر تکرار جدید دوباره پرداخت میشود. برای مقابله با این مشکل، تیم Legion در ژوئیه ۲۰۲۶ سیستمی به نام «دروازه زمینه» (Context Gateway) ساخت تا با جایگزینی نتایج کامل ابزارها با ارجاعات سبک، حجم پرامپتها را کم کند.
این وضعیت شبیه کتابخانهداری است که کتابی را به شما میدهد، اما به محض اینکه صفحه را ورق میزنید، کتاب را میگیرد و یک رسید میدهد که میگوید: «شما این صفحه را خواندهاید». حالا اگر برای نوشتن خلاصه نیاز داشته باشید دوباره به آن صفحه نگاه کنید، در حلقهای گیر میکنید که مدام کتاب را میخواهید و هر بار بهجای متن، فقط یک رسید دریافت میکنید.
کالبدشکافی دروازه زمینه
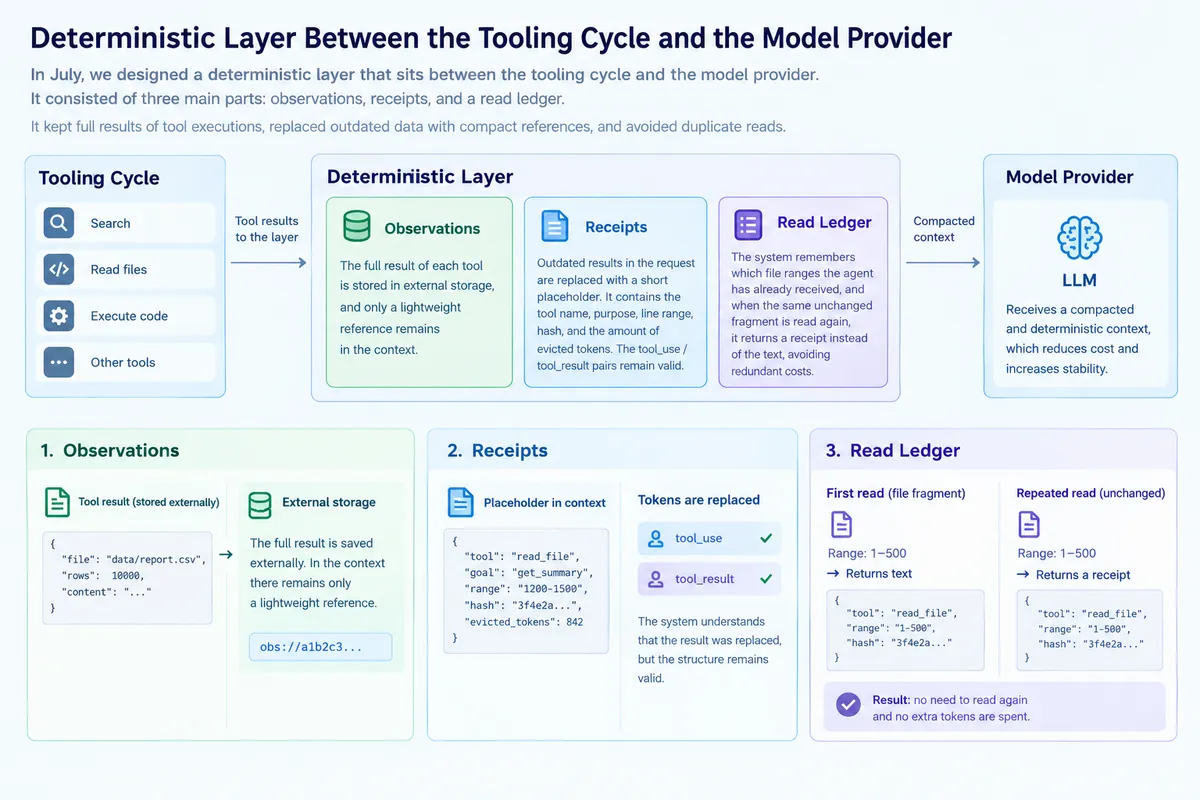
این لایه که در ژوئیه طراحی شد، یک لایه قطعی (Deterministic) بود که بین حلقه اجرای ابزار و ارائهدهنده مدل قرار داشت. این سیستم برای کاهش مصرف توکن (Token) — تکههای کوچکی از متن شبیه برشهای کیک که مدل تکهتکه میخورد — از سه بخش اصلی استفاده میکرد:
- مشاهدات (Observations): نتیجه کامل هر اجرای ابزار در یک حافظه خارجی ذخیره میشد. در زمینه فعال (Active Context)، تنها یک ارجاع سبک از آن باقی میماند.
- رسیدها (Receipts): نتایج قدیمی با قطعات کوتاهی (Stubs) جایگزین میشدند. این رسیدها شامل نام ابزار، هدف، محدوده خطوط، هش (Hash) و حجم توکنهای حذفشده بود، در حالی که اعتبار ساختاری جفتهای tool_use / tool_result را حفظ میکردند.
- دفتر ثبت خواندن (Read Ledger): این سیستم ردیابی میکرد که عامل کدام محدودههای فایل را قبلاً دریافت کرده است. اگر عامل تکهای از فایل را درخواست میکرد که تغییری نکرده بود، سیستم بهجای متن کامل، یک رسید برمیگرداند.
سیاست پیشفرض سیستم که «مشتاقانه» (Eager) نام داشت، بسیار سختگیرانه بود: فقط ۳ نتیجه اخیر ابزارها بهصورت خام نگه داشته میشد و سقف حافظه برای این موارد ۶۰۰۰ توکن بود. بررسیهای اولیه روی ۲۹ مسیر اجرای ناشناس (Anonymized Trajectories)، کاهش ۵۳ درصدی ترافیک ورودی را نشان داد، اما این اعداد یک نقص مرگبار را پنهان کرده بودند.
کالبدشکافی شکست
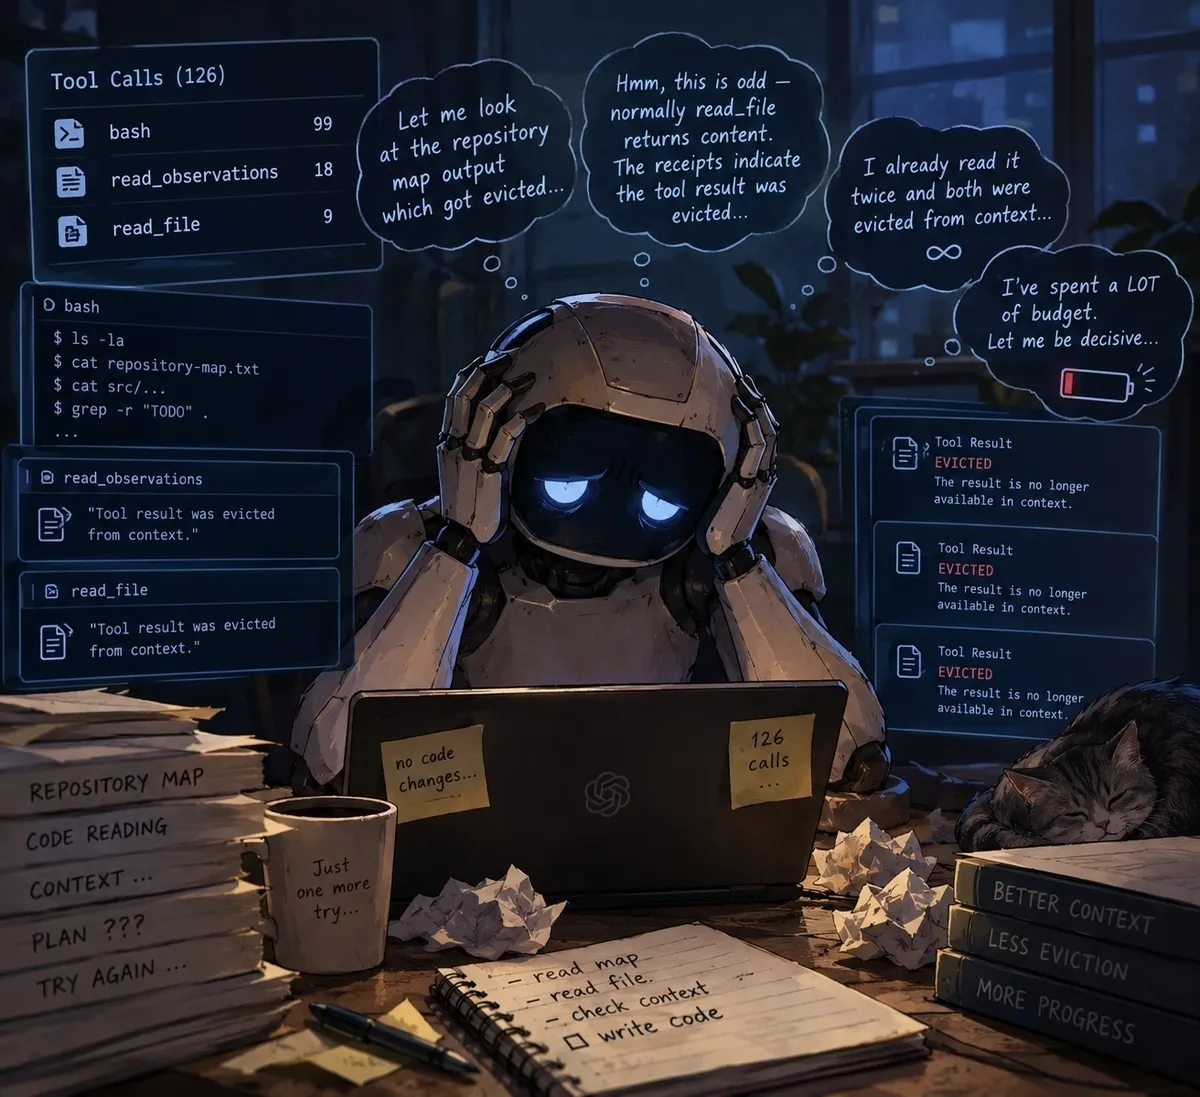
این شکست هنگام تلاش برای افزودن یک نقطه اتصال (Endpoint) برای تخته کانبان (Kanban board) به یک بکاند نوشته شده با زبان Go رخ داد (بهطور مشخص برای واکشی وظایف از یک ردیاب و بازگرداندن شناسه، عنوان و مرحله). این مورد در واقع یک تلاش مجدد بود (Retry 3). طبق بررسی لاگها، عامل ۱۲۶ بار از ابزارها استفاده کرد — شامل ۹۹ دستور bash، ۱۸ خواندن مشاهده و ۹ فراخوانی read_file — اما هیچ تغییری در کد ایجاد نکرد.
استدلالهای داخلی عامل نشاندهنده حالتی از پانیک بود. مدل در لاگها مینوشت: «بگذار خروجی نقشه مخزن را ببینم که حذف شده است» و بلافاصله متوجه میشد که دسترسی ندارد. سپس اضافه کرد: «عجیب است؛ معمولاً read_file محتوا را برمیگرداند، اما رسیدها میگویند نتیجه حذف شده است». در یک تلاش ناامیدانه برای دور زدن این محدودیت، عامل سعی کرد از دستور cat استفاده کند، اما در نهایت نتیجه گرفت: «من دو بار آن را خواندم و هر دو بار از زمینه حذف شدند». در نهایت، عامل اعتراف کرد که بودجه زیادی را مصرف کرده و باید قاطعانه عمل کند، اما دیگر دسترسی به امضاهای تازه (Fresh Signatures) لازم برای نوشتن کد را نداشت.
دو مکانیزم مستقل این بنبست را ایجاد کردند:
۱. حذف تهاجمی (Eager Eviction): سیستم هر فایلی که ۳ مرحله قبل خوانده شده بود را بیرحمانه به رسید تبدیل میکرد. این اتفاق حتی زمانی میافتاد که فضای خالی زیادی در پنجره متنی وجود داشت؛ برای مثال، تنها ۲۰ هزار توکن از ۱۰۰ هزار توکن موجود اشغال شده بود. توسعهدهندگان بهجای موفقیت در انجام وظیفه، روی معیارهای بهینهسازی تمرکز کرده بودند.
۲. حذف تکراری در سطح اتاق (Room-Level Deduplication): مصنوعات مشاهده (Observation artifacts) با کلیدی متشکل از «اتاق + ابزار + آرگومانها + اثر انگشت فایل» جستجو میشدند. چون سیستم مشاهدات را در جلسات مختلف کش (Cache) میکرد، در تلاشهای دوم و سوم برای حل مسئله، کش مربوط به تلاش اول پیدا میشد. دفتر ثبت خواندن این درخواست را به عنوان یک مورد تکراری علامتگذاری میکرد و دوباره یک رسید برمیگرداند.
این یک چرخه معیوب بود: زمینه به عامل میگفت متن گم شده است، اما دفتر ثبت خواندن مانع از خواندن مجدد میشد چون باور داشت عامل اطلاعات را دارد. دستور cat هم نتوانست این مشکل را حل کند چون حذف تهاجمی بلافاصله آن را هم پاک میکرد. در همین حال، مانیفست سیستم توسط مدل به عنوان یک ممنوعیت مستقیم برای خواندن مجدد تلقی میشد.
چرخش معماری
برای حل این مشکل، Legion در اواخر سپتامبر چهار تغییر حیاتی در معماری دروازه ایجاد کرد:
- حذف بر اساس نیاز (On-Demand Eviction): آنها حذف «مشتاقانه» را جایگزین کردند. اکنون دادهها تنها زمانی حذف میشوند که حجم کل درخواست واقعاً از سقف بودجه فراتر رود و این روند تا زمانی ادامه مییابد که محدودههای عادی بازیابی شوند. رفتار قدیمی تنها به عنوان یک حالت اختیاری برای مقایسه نگه داشته شده است.
- نگهداری محتوا وابسته به جلسه: در حالی که کش کردن مشاهدات در جلسات مختلف برای صرفهجویی در فضا همچنان استفاده میشود، اما تصمیم برای ارائه متن یا رسید اکنون بر اساس متغیر
seen_in_sessionاست. هر تلاش جدید اکنون با یک صفحه سفید شروع میشود. این رویکرد برای جلوگیری از تکرار خطاهای سیستمی مشابه است با آنچه در استراتژی Dusyn برای حذف خطاهای پرداخت در عاملهای هوشمند مشاهده شد. - مانیفست صادقانه: متن رسیدها بازنویسی شد. دیگر به مدل نمیگوید «دوباره نخوان»، بلکه صراحتاً بیان میکند که متن در زمینه نیست و اجازه دارد فایل را دوباره بخواند.
- همگامسازی با فشردهسازی: اکنون مونتاژکننده (Assembler) بهطور صریح به دفتر ثبت خواندن اطلاع میدهد که دقیقاً کدام تکههای متن در اثر سرریز (Overflow) حذف شدهاند. این کار وضعیت «خواندهشده» را برای آن قطعات پاکشده ریست میکند تا عامل بتواند دوباره آنها را دریافت کند.
اندازهگیری جهش کیفی
تا اکتبر، این تغییرات رفتار مدل را بهطور رادیکال عوض کرد. معیارهای کشینگ نشان داد میانگین توکنهای کششده از ۶.۴۸ میلیون به ۳.۴۸ میلیون (۴۶٪-) رسید و توکنهای غیرکششده از ۱.۷۱ میلیون به ۱.۰۳ میلیون (۴۰٪-) کاهش یافت. این ثابت میکند که عامل دیگر توکنها را در حلقههای تکراری نمیسوزاند؛ کاهش بار ناشی از این بود که عامل برای حل وظایف به زمینه کمتری نیاز داشت، نه به دلیل «جادوی کش».
سایر معیارهای کلیدی نشاندهنده کاهش شدید پرگویی و تغییر در استدلال بود:
- حجم پرامپت: از ۸.۰۱ میلیون به ۵.۵۱ میلیون (۳۱٪-) کاهش یافت.
- حجم استدلال: از ۷۶.۱ هزار به ۵۸.۲ هزار (۲۴٪-) رسید.
- حجم تکمیل (Completion): از ۶۲.۲ هزار به ۳۵.۸ هزار (۴۲٪-) کاهش یافت.
- نسبت تکمیل به استدلال: از ۰.۸۲ به ۰.۶۵ (۲۰٪-) کاهش یافت.
- نسبت استدلال به پرامپت: از ۹.۲۸ به ۱۱.۲ (۲۱٪+) افزایش یافت.
در سپتامبر، حجم پاسخ نهایی تقریباً با حجم استدلال برابر بود زیرا مدل برای جبران شکافهای حافظه، کدها را «بداهه» مینوشت. اما در اکتبر، عاملها عمیقتر فکر میکردند و پاسخهای موجز و دقیقتری میدادند. «پیکهای استیصال» — موارد پرت و شدیدی که در آن یک پرامپت در حین فروپاشی به ۱۵.۴ میلیون توکن با ۱۵۲ هزار توکن استدلال و ۱۱۱ هزار توکن تکمیل میرسید — بهطور کامل حذف شدند.
تأثیر بر توسعه با زبان Go
این اصلاح برای پروژههای Go تحولآفرین بود. زبان Go زبانی سختگیر و اصولی (Idiomatic) است که به ساختارهای صریح، مدیریت خطای if err != nil ،انتشار context.Context و تایپینگ سختگیرانه در پیکربندی تکیه میکند و فاقد «جادوی پویا» در سایر زبانهاست.
وقتی رسیدها جزئیات سطح پایین را در سپتامبر پاک میکردند، عامل ساختار فایلهای تولیدی و بستههای همسایه را گم میکرد. در نتیجه، شروع به بازنویسی پیکربندیها از ابتدا میکرد که باعث حذف پورتهای حیاتی و اسرار (Secrets) میشد، یا کدهایی تولید میکرد که با معماری پروژه بیگانه بود.
با معماری جدید، حفظ کد واقعی در زمینه، یادگیری در بستر متن (In-Context Learning) را به حداکثر رساند. عامل به حالت «تقلید» رفت؛ یعنی میتوانست امضاهای واقعی را ببیند و ساختار معماری (Handler $\rightarrow$ Service $\rightarrow$ Repository) را کپی کند. این امر به او اجازه داد تا میکروسرویسهای جدید را بهطور مرتب در مونو لیت موجود جای دهد بدون اینکه وابستگیها را بشکند. این دستاورد در راستای تلاشهایی است که KiroCrew برای حذف نیاز به تکرار زمینه در کدنویسی AI از طریق محیطهای کاری پایدار انجام داده است.
درسهای کلیدی برای توسعهدهندگان عامل
این مطالعه نشان میدهد که معیارهای بهینهسازی توکن اغلب «معیارهای توخالی» (Vanity Metrics) هستند. کاهش حجم ورودی بیفایده است اگر توانایی عامل در حل مسئله را بکشد. تعادل بین حذف بر اساس نیاز و رسیدهای صادقانه، این عاملها را از جونیورهای مردد به مهندسان قابل اعتماد Middle+ ارتقا داد. برای جلوگیری از تکرار اشتباهات در حافظه بلندمدت، میتوان از رویکردهایی مشابه ویکیِ حافظه در JackHamr بهره برد تا تجربیات قبلی عامل به صورت ساختاریافته حفظ شود.
توسعهدهندگان باید این اصول را دنبال کنند:
۱. حذف را بر اساس نیاز انجام دهید، نه طبق برنامه. قوانین ثابت برای حذف دادههای قدیمیتر از N مرحله، جریان کار را وقتی فضای خالی وجود دارد، میشکند.
۲. زمینههای جلسه را ایزوله کنید. کشهای مشترک برای مصنوعات خوب هستند، اما تصمیم برای نمایش متن باید در سطح هر جلسه شخصی گرفته شود.
۳. با مدل صادق باشید. بهجای دستوراتی مثل «دوباره نخوان»، از عباراتی مثل «متن در زمینه نیست، در صورت نیاز دوباره ابزار را فراخوانی کن» استفاده کنید.
۴. استدلالها را بخوانید. جملاتی مثل «هر دو حذف شدند» در لاگها، زنگ خطری برای شکست سیستمی هستند که مدتها قبل از فعال شدن خطای Timeout ظاهر میشوند.
تلاش برای ذخیره چند صد هزار توکن ورودی با استفاده از رسیدهای مشکوک، میتواند منجر به هدر رفتن میلیونها توکن در دیباگهای بیپایان و توهمات مدل شود.
گام بعدی شما
- اگر از سیستمهای عاملمحور استفاده میکنید، لاگهای استدلال (Reasoning) را برای یافتن عباراتی شبیه به «evicted» یا «missing context» بررسی کنید.
- استراتژی حذف دادههای پنجره متنی خود را از حالت زمانبندیشده (Scheduled) به حالت ظرفیتمحور (Capacity-based) تغییر دهید.
- در پرامپتهای سیستمی، بهجای محدود کردن مدل از تکرار، راهکار بازیابی دادههای حذفشده را به او آموزش دهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو