تصور کنید سیستمی داشته باشید که دقیقاً میداند ثانیه بعد چه اتفاقی میافتد، اما نمیتواند یک قدم ساده به جلو بردارد. این تضاد دقیقاً همان چیزی است که در پروژه LeMario رخ داد؛ جایی که پیشبینی دقیق دنیای بازی، تضمینی برای پیروزی در آن نبود. مدل LeMario — که نسخهای پیادهسازیشده از معماری پیشبنیاد مشترک یا JEPA (Joint-Embedding Predictive Architecture) است — توانست قوانین فیزیکی کوتاهمدت بازی Super Mario Bros را مدلسازی کند، اما در پیمودن مراحل پیچیده کاملاً ناتوان بود. این تجربه ثابت کرد که پیشبینی فریم بعدی یک بازی ویدئویی، با دانستن نحوه پیروزی در آن کاملاً متفاوت است.
این مدل تمام تستهای اولیه را پاس کرد. مدل توانست روی اپیزودهایی که در زمان آموزش ندیده بود تعمیم یابد، از ورودیهای مربوط به اقدامات (Action inputs) بهدرستی استفاده کند و آیندههای پنجگامه را بهتر از مدلهای پایه (Baselines) قدرتمند پیشبینی نماید. حتی برنامهریزی خام بدون پاداش (Reward-free planning) میتوانست ماریو را به سمت اهداف تصویری نزدیک حرکت دهد و در فاصلهی دو تا پنج پیکسل از اهداف متوقف شود.
با این حال، به محض اینکه هدف به نقاط دورتری از مرحله منتقل شد، شکست مدل آشکار گردید. ماریو نمیتوانست بهطور قابلاطمینانی از اولین مانع بزرگ بپرد یا به سمت یک تصویر هدف دوردست حرکت کند. مدل یاد گرفته بود که بازی را پیشبینی کند، اما یاد نگرفته بود که چگونه در آن پیشرفت کند. این نوشتار هم یک پیمایش فنی و هم کالبدشکافی (Postmortem) چیزی است که ساخته شد، نحوه تست آن و آزمایشهایی که مشکل واقعی را برملا کردند.
این آزمایش شکاف بین «مدلهای جهانی» (World Models) — که آینده را تصور میکنند — و «عاملهای کنترلی» (Control Agents) — که عملاً یک نقشه را اجرا میکنند — بررسی میکند. پژوهشگر تلاش کرد مدل LeWorldModel را که یک سیستم JEPA کوچک برای برنامهریزی بدون پاداش در محیط Push-T بود، با ساخت کل معماری از ابتدا بازسازی کند. این رویکرد با تمرکز بر نمایشها در فضای نهان بهجای سیگنالهای صریح پاداش، از یادگیری تقویتی سنتی فاصله میگیرد.
کالبدشکافی ماشین
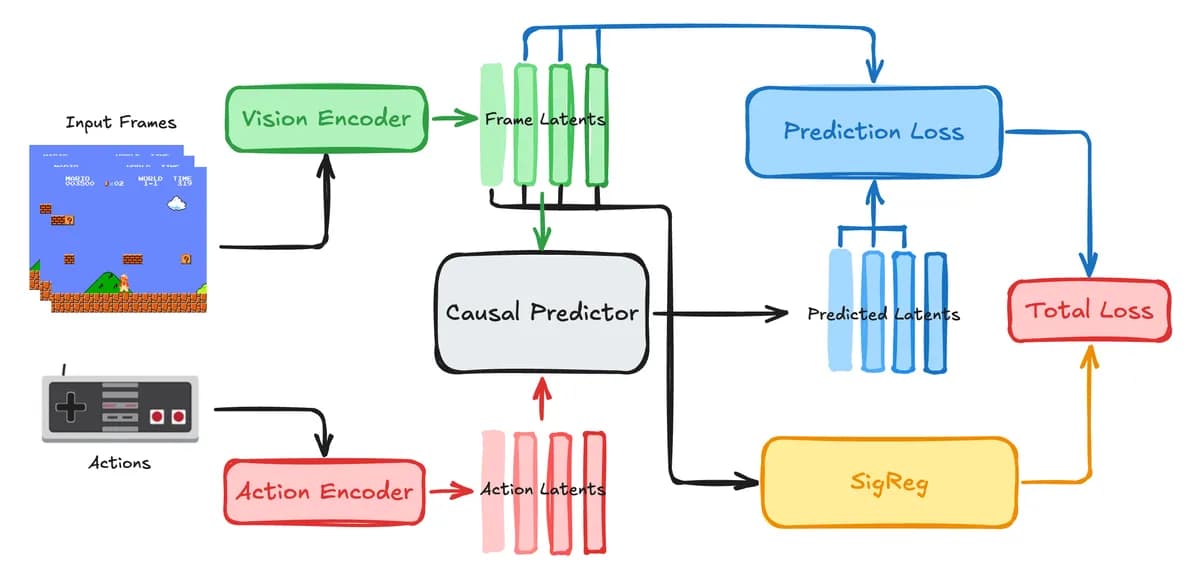
این سیستم از یک رمزگذار بینایی استفاده میکند تا فریمهای ماریو را به نمایشهایی با ۱۹۲ عدد تبدیل کند که به آنها بردار نهان (Latent) یا $z_t$ میگویند. این بردارها در واقع توصیفات خصوصی مدل از صفحه نمایش هستند. جریان دادهها شامل چهار فریم ماریو برای هر نمونه آموزشی است و رمزگذار نگاشت $z_t = E_\theta(x_t), z_t \in \mathbb{R}^{192}$ را تولید میکند.
بهطور همزمان، یک رمزگذار اقدام (Action encoder) ورودیهای کنترلر را به برداری ۱۹۲-بعدی دیگر تبدیل میکند. مسیر قرمز معماری این ورودیها را مدیریت میکند. هر جفت از مشاهدات با پنج فریم شبیهساز فاصله دارند. هر فریم شامل شش وضعیت احتمالی دکمه است: چپ، راست، بالا، پایین، A و B. ابعاد ورودیها به صورت frames: [batch, 4, 3, 224, 224] و actions: [batch, 4, 5, 6] تعریف شدهاند.

این دو جریان داده به یک پیشبین علّی متشکل از شش بلوک ترنسفورمر (Transformer) وارد میشوند. هدف پیشبین پاسخ به این پرسش است: با داشتن فریمهای قبلی و دکمههای فشار داده شده، بردار نهان فریم بعدی باید چه شکلی باشد؟ در این ساختار، هر یک از فریمها به فریمهای قبلی توجه (Attend) میکنند تا بافت زمانی (Temporal context) حفظ شود.
برای ادغام اقدامات، مدل از مکانیزم AdaLN-Zero (Adaptive LayerNorm Zero) استفاده میکند. بهجای چسباندن سادهی بردار اقدام به بردار فریم، AdaLN-Zero هر اقدام را به سه کنترل دقیق تبدیل میکند:
- جابهجایی (Shift): یک آفست وابسته به اقدام را به ویژگیهای فریم اضافه میکند و ویژگیهای نرمالشده را به سمت یک خط مبنای متفاوت میبرد.
- مقیاس (Scale): ویژگیهای خاص را تقویت یا تضعیف میکند. برای مثال، اقدام «پرش» ممکن است ویژگیهای نهان مربوط به حرکت عمودی را مقیاسبندی (افزایش) کند و ویژگیهایی را که برای پیشبینی آن پرش اهمیت کمتری دارند، کاهش دهد.
- درگاه (Gate): کنترل میکند که ترنسفورمر با چه شدتی حالت فعلی را بهروزرسانی کند و تصمیم میگیرد که بهروزرسانیهای Attention یا MLP تا چه حد بر حالت پیشبینیشده اثر بگذارند.

این کنترلها بهطور جداگانه برای شاخههای Attention و MLP تولید میشوند، به این معنی که هر بلوک در مجموع شش مقدار (یک shift، یک scale و یک gate برای هر شاخه) دارد. عبارت «Zero» به این معناست که وزنها در ابتدا صفر هستند؛ این کار تضمین میکند که پیشبین بدون اثرات تصادفی اقدامات شروع به کار کند و بهتدریج یاد بگیرد کدام درگاهها را در طول آموزش باز کند.
پس از شش بلوک ترنسفورمر، یک لایه تصویرساز (Projection head) کوچک سه بردار نهان آینده ($\hat z_1, \hat z_2, \hat z_3$) را تولید میکند. اینها با بردارهای نهان تولید شده توسط سه فریم واقعی بعدی با استفاده از تابع زیان میانگین مربعات خطا (MSE) مقایسه میشوند: $\mathcal{L}_{\text{pred}} = \operatorname{MSE}([\hat z_1, \hat z_2, \hat z_3], [z_1, z_2, z_3])$.
جلوگیری از فروپاشی نمایش
برای جلوگیری از «فروپاشی نمایش» (Representation Collapse) — وضعیتی که مدل با یکسان کردن تمام بردارها برای رسیدن به خطای صفر تقلب میکند (بهطوری که ماریو، یک لوله و یک دنیای جدید همگی یکسان به نظر برسند) — پژوهشگر مکانیزم SIGReg را پیاده کرد. این روش با تشویق بردارهای نهان فریمهای واقعی به متنوع و آموزنده ماندن، از فروپاشی جلوگیری میکند.
مکانیزم SIGReg:
- تصویر کردن (Projection): بردارهای ۱۹۲-بعدی JEPA روی ۱٬۰۲۴ جهت تصادفی تصویر میشوند.
- ارزیابی (Evaluation): هر تصویر در ۱۷ نقطه مورد ارزیابی قرار میگیرد.
- مقایسه (Comparison): نتیجه با یک توزیع گاوسی استاندارد مقایسه میشود تا میانگین خطاها به دست آید.
- اجرا (Application): SIGReg بهطور مستقل برای هر گام زمانی در کل دسته (Batch) اعمال میشود.
تابع زیان نهایی به این شکل در میآید: $\mathcal{L} = \mathcal{L}{\text{pred}} + 0.1\mathcal{L}{\text{SIGReg}}$.
عملکرد در برابر واقعیت
مدل LeMario روی ۷۳۷٬۱۳۴ فریم از ۲۸۰ اپیزود در ۳۲ مرحله مختلف آموزش دید. چون فریمهای نزدیک به هم اغلب چنان شبیه هستند که پیشبینی «هیچ چیز تغییر نمیکند» یک خط مبنای قوی است، کاهش خطای پایین بهتنهایی ثابت نمیکند که مدل دینامیکها را یاد گرفته است. پژوهشگر LeMario را با این خط مبنای تداوم (Persistence) و نسخهای با «اقدامات بههمریخته» مقایسه کرد.
| روش | خطای یکگامه | خطای پنجگامه |
|---|---|---|
| LeMario | ۰.۰۱۳۷۷۳ | ۰.۰۷۷۷۱۷ |
| پیشبینی عدم تغییر | ۰.۰۱۴۴۷۲ | ۰.۱۴۲۴۷۳ |
| بههمریختن اقدامات | ۰.۰۱۶۵۵۵ | ۰.۱۱۴۶۴۸ |
بههمریختن اقدامات، خطای یکگامه را ۲۰.۲٪ افزایش داد. در پیشبینیهای بازگشتی پنجگامه، LeMario حدود ۴۵.۵٪ بهتر از مدل «عدم تغییر» عمل کرد، در حالی که اقدامات بههمریخته ۴۷.۵٪ بدتر بودند. این ثابت کرد که هرچه افق پیشبینی مدل دورتر شود، ورودیهای دکمهها اهمیت بیشتری پیدا میکنند. LeMario با موفقیت دینامیکهای کوتاهمدت ماریو را مشروط به اقدامات بازیکن یاد گرفته بود.
جستوجو در تخیل
برای تبدیل پیشبین به یک کنترلکننده، از روش آنتروپی متقاطع (CEM) استفاده شد. این روش به مدل اجازه میدهد در میان آیندههای تخیلی جستوجو کرده و بهترین توالی اقدامات را انتخاب کند. با داشتن تصویر فعلی $x_t$ و تصویر هدف $x_g$:
۱. رمزگذار بردارهای $z_t$ و $z_g$ را تولید میکند.
۲. CEM صدها توالی اقدام را نمونهبرداری میکند.
۳. هر توالی از طریق LeMario به جلو رول (Roll forward) میشود.
۴. بردار نهان نهایی پیشبینیشده در برابر $z_g$ امتیازدهی میشود.
۵. بهترین کاندیدها نگه داشته میشوند و فرآیند دوباره حول آنها نمونهبرداری میکند.

اما نتایج ناامیدکننده بود. وقتی ماریو در موقعیت x=۴۰ بود و هدف x=۷۲، ترکیب خام JEPA+CEM در x=۴۴ متوقف شد. به زبان ساده، عملکرد مدل بسیار ضعیف بود. در این مرحله مشخص نبود که پیشبین اشتباه میکند، CEM خراب است یا رمزگذار بهطور کلی ماریو را نادیده گرفته است.

کاوشگر و تلههای بصری
برای تشخیص علت شکست، پژوهشگر این سؤال را مطرح کرد که آیا آن ۱۹۲ عدد واقعاً موقعیت ماریو را شامل میشود یا خیر. یک کاوشگر MLP کوچک ساخته شد تا مختصات شبیهساز را از بردار نهان استخراج کند، بدون اینکه رمزگذار تغییر کند. رمزگذار منجمد (Frozen) شد تا اطمینان حاصل شود که کاوشگر فقط اطلاعاتی را بازیابی میکند که JEPA قبلاً یاد گرفته است. کاوشگر با استفاده از ۶۰ مسیر (Trajectory) از مرحله World 1-1 آموزش دید که به ۳٬۲۰۳ بردار نهان آموزشی و ۸۵۹ بردار نهان خارج از آموزش (Held-out) تقسیم شدند.
ساختار کاوشگر:
- ورودی: بردار نهان ۱۹۲-بعدی JEPA
- لایه ۱: Linear(192, 128)
- فعالساز: GELU
- لایه ۲: Linear(128, 2)
- خروجی: مختصات پیشبینی شده (x, y)
نتایج کاوشگر:
- موقعیت افقی: خطای مطلق میانگین (MAE) = ۹.۳۰ پیکسل، $R^2 = 0.997$ (تقریباً کاملاً قابل بازیابی).
- موقعیت عمودی: خطای مطلق میانگین (MAE) = ۲۱.۶۲ پیکسل، $R^2 = 0.188$ (نمایش بسیار ضعیفتر).
وقتی برنامهریز بهطور موقت از این کاوشگر افقی برای امتیازدهی به آیندهها بهجای فاصله خام بردار نهان استفاده کرد، ماریو واقعاً حرکت کرد و برای هدفی در x=۱۷۷، به x=۱۷۶ رسید. این اولین اجرای موفقیتآمیز بود! این موضوع تأیید کرد که مدل JEPA میتواند حرکت افقی مفیدی را تصور کند و کاوشگر قادر به یافتن آن است، که نشان میدهد برنامهریزی نهان بهطور تئوری باید کار کند.
مشکل دوربین متحرک (Scrolling Camera)
پژوهشگر فرض کرد شاید هدف اول بیش از حد به فریم شروع شبیه بوده و باعث شده «هیچ کاری نکردن» مانند موفقیت به نظر برسد. برای تست این موضوع، کاوشگر حذف شد و برنامهریزی با بردار نهان خام با تصاویر هدف قابل دستیابی در اواسط مراحل World 1-1، 2-1 و 3-1 امتحان شد.
در مرحله ۳-۱، ماریو به طور قابلتوجهی بیشتر از قبل پیش رفت. بهجای رسیدن به x=۴۴، سه اجرا به محدوده x=۲۹۰ تا ۳۰۷ رسیدند. با این حال، آنها همچنان در اولین مانع جدیe جان باختند.
یک کشف حیاتی صورت گرفت: ماریو ۱٬۴۴۲ پیکسل جهانی با هدف فاصله داشت، اما رمزگذار برای صحنه نهایی او فاصله نهانی تنها ۰.۱۶۴ را اختصاص داد. چون CEM مقدار ۰. Artisan-۰.۱۵۳ را پیشبینی کرده بود، پیشبین دچار توهم نشده بود؛ بلکه خودِ رمزگذار صحنه اشتباه را «نزدیک» میدید. بهدلیل دوربین متحرک، دو مکان دوردست میتوانند بسیار شبیه به هم باشند. مدل باور داشت که مسیری به هدف پیدا کرده است، اما در واقع در مکانی گیر کرده بود که تعبیه (Embedding) آن شبیه به هدف بود.
اصلاح اهداف
برای رفع این مشکل، مسیر انسانی به اهداف تصویری میانی کوچکتر تقسیم شد تا تفاوتهای بصری بین فریمها افزایش یابد. این کار کمی کمک کرد: برنامهریزی با بردار نهان خام به x=۳۱۴ رسید که بیشترین پیشرفت بدون کاوشگر در کل پروژه بود.
با این حال، فاصله همچنان معیار شکنندهای برای پیشرفت بود. در یک مورد، ماریو در فاصله دو پیکسل به هدف رسید. در مورد دوم، او از هدف گذشت و به x=۲۸۳ رسید، سپس به عقب برگشت و در x=۲۳۹ (پنج پیکسل فاصله از مرجع) متوقف شد. از نظر بصری او در جای درست بود، اما بنچمارک آن را شکست تلقی کرد زیرا تعبیه نهایی به اندازه کافی به تعبیه هدف نزدیک نبود (احتمالاً بهدلیل تفاوتهای جزئی در HUD یا جزئیات دیگر).
اهداف کوچکتر به افق برنامهریزی کمک کردند، اما فاصله نهان را به معیاری قابل اعتماد تبدیل نکردند. وقتی هدف بعدی نیاز به پرش داشت، برنامهریز دوباره شکست خورد؛ این موضوع دقیقاً یافتههای کاوشگر مبنی بر نمایش ضعیف موقعیت عمودی را تکرار میکرد.
کالبدشکافی نهایی
این شکستها به سه مشکل اصلی اشاره دارند. نخست، «حالت پیشبین» با «حالت کنترلی» متفاوت است. رمزگذاری که برای پیشبینی تصاویر آینده پاداش میگیرد، موقعیت دوربین، فاز دشمن، انیمیشن و وضعیت تایمر را نمایش خواهد داد. اما یک کنترلکننده به حالتی نیاز دارد که در آن، فاصله بهطور خاص با «پیشرفت قابل کنترل» مطابقت داشته باشد.
دوم، CEM مانند یک «یافتار نقاط ضعف» عمل میکند. CEM دقیقاً همان کاری را انجام میدهد که از او خواسته شده: یافتن اقداماتی که LeMario باور دارد به هدف میرساند. CEM نمیتواند تشخیص دهد که مدل اشتباه میکند و همین امر باعث میشود نقاط ضعف مدل — مانند یکسان دیدن مکانهای بصری مشابه — کاملاً آشکار شود.
LeMario در برابر Push-T
پژوهشگر متوجه شد که موفقیت مدل اصلی Push-T بر پیشفرضهایی استوار بود که در ماریو صدق نمیکردند:
- دوربین: Push-T دوربین ثابت داشت؛ ماریو دوربین متحرک دارد.
- حرکت: Push-T دارای حرکات نرم بود؛ ماریو شامل تکانه (Momentum)، پرش، چالهها، دشمنان، انیمیشن و مرگ است.
- اهداف: Push-T از اهداف نزدیک در مسیرات خبره استفاده میکرد؛ LeMario از اهدافی در فاصله نیمی از مرحله استفاده کرد.
- مقیاس: Push-T برای ۱۰ اپوک روی ۲۰٬۰۰۰ اپیزود خبره آموزش دید؛ LeMario برای یک اپوک روی ۲۸۰ اپیزود در ۳۲ مرحله آموزش دید.
با کپی کردن معماری اما تغییر این شرایط محیطی، پژوهشگر ناخواسته عواملی را که برای موفقیت این روش حیاتی بودند، حذف کرد.
درسهای نهایی
LeMario به یک عامل کامل تبدیل نشد، اما دینامیکهای کوتاهمدت مشروط به اقدام را به خوبی ثبت کرد. این تجربه آموخت که دیتاست، محیط، ارزیابی و پیشفرضهای زیربنایی به اندازه خودِ معماری اهمیت دارند. نتایج غیرمنتظره پایان یک آزمایش نیستند؛ بلکه با جداسازی پیشبین، نمایش، برنامهریز و معیار ارزیابی، پژوهشگر درک عمیقتری از مدل بهدست آورد.
برای پروژههای آینده، هدف این است که پیشفرضهای مرکزی را بسیار زودتر اعتبارسنجی کرد، خطوط مبنای سادهای را پیش از اعتماد به یک معیار ایجاد کرد و ارزیابیها را حول «رفتارهای مطلوب» طراحی کرد، بهجای آنکه صرفاً برای بهینهسازی تابع زیان آموزش دید.



گفتگو