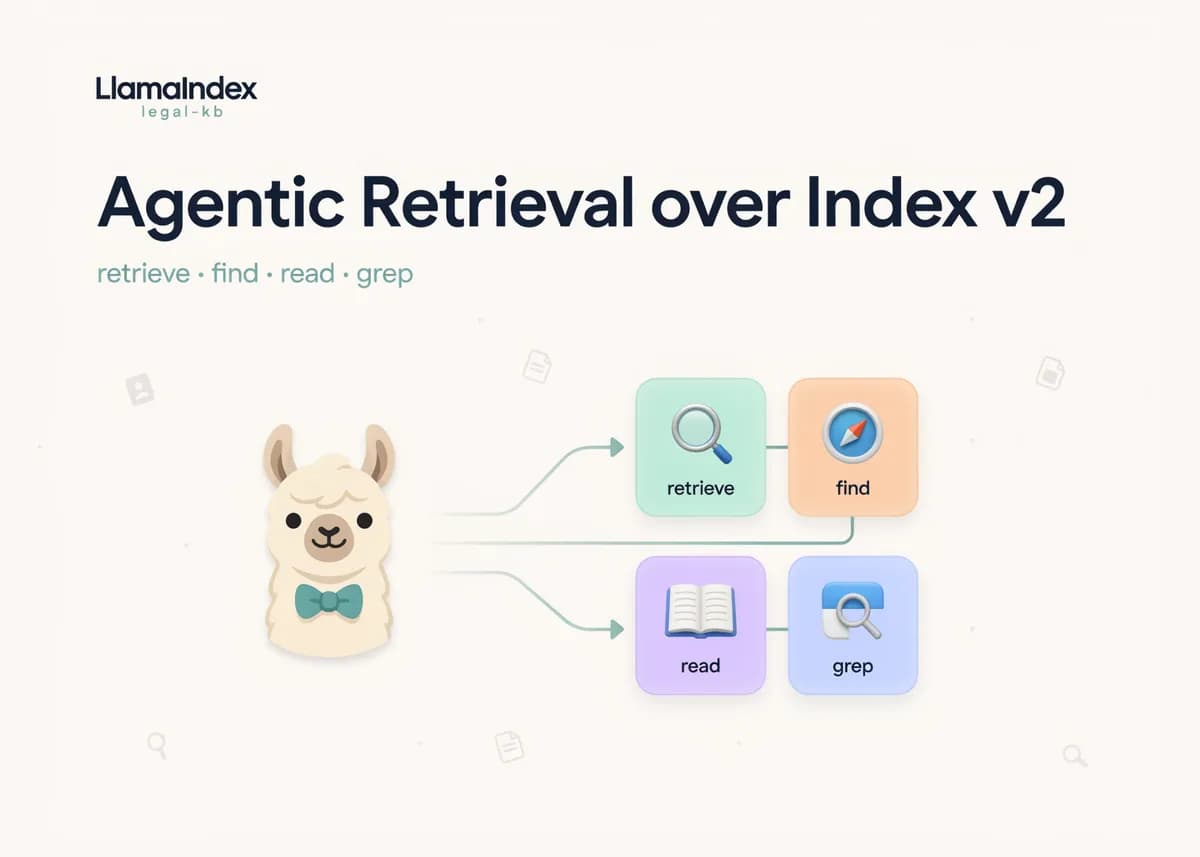
تصور کنید یک وکیل باید در میان صدها صفحه قرارداد، یک بند خاص را پیدا کند؛ تکیه بر یک جستوجوی ساده، ریسک گم کردن جزئیات حیاتی را بهشدت بالا میبرد. برای حل این چالش، LlamaIndex اپلیکیشن مرجع legal-kb را در گیتهاب منتشر کرد تا مدل سنتی بازیابی تکضربه را با یک «هارنس بازیابی» (Retrieval Harness) عاملمحور (Agentic) جایگزین کند.
بسیاری از توسعهدهندگان فعلاً از تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، سریع یک نگاه به کتاب میاندازد و هر چه نزدیک بود را میگوید — استفاده میکنند. در این مدل ساده، سیستم فقط چند تکه (Chunk) مشابه را میگیرد و امیدوار است پاسخ در آنها باشد. در حالی که پیشتر بررسی کردیم چگونه ابزارهایی مانند Ollama و Spring Boot دسترسی به APIهای محلی LLM را تسهیل میکنند، اکنون گلوگاه پیشرفت از دسترسی به API به دقت بازیابی تغییر یافته است. بهخصوص در حوزههای حقوقی و فینتک، گم کردن حتی یک عبارت یا بند کوچک میتواند کل تحلیل حقوقی را باطل و بیاعتبار کند. برای دستیابی به چنین دقتی، استفاده از متدهای پیشرفته ارزیابی ضروری است؛ برای مثال، ترکیب جستوجوی ترکیبی و چارچوب RAGAS میتواند توهمات را در سیستمهای RAG حقوقی بهطور چشمگیری کاهش دهد.
زمینه و ساختار اپلیکیشن
طبق مستندات این پروژه، legal-kb به جای یک کتابخانه، به عنوان یک اپلیکیشن وب عملیاتی با استفاده از TanStack Start ساخته شده است. گردشکار این سیستم دقیقاً برای کاربران نهایی طراحی شده است: کاربر ابتدا وارد حساب خود میشود، یک پروژه ایجاد میکند، فایلهای حقوقی خود را آپلود کرده و سپس با یک عامل (Agent) وارد گفتگو میشود.
هر پروژه در این سیستم به شکل یک LlamaCloud Index v2 مدیریتشده منعکس میشود. فایلهای آپلودشده در پسزمینه بهصورت خودکار تحلیل (Parse) و ایندکس میشوند. این فرآیند یک خط لوله داده (Data Pipeline) دائمی روی اسناد شما ایجاد میکند که به منبع داده متصل مانده و آن را بهروز نگه میدارد؛ این سازوکار به عامل چت اجازه میدهد در هر نوبت از گفتگو، ایندکس را بهصورت زنده کوئری کند.
نوآوری اصلی در اینجا، تبدیل جستوجوی ایستا به یک حلقه ابزار پویا است. هارنس بازیابی مجموعهای از ابزارها را در اختیار عامل قرار میدهد که تعمداً بسیار نزدیک به عملیات سیستمفایل (Filesystem) طراحی شدهاند. به دلیل ماهیت عمومی این ابزارها، این هارنس میتواند به هر نوع پیادهسازی از عاملها متصل شود.
مکانیسم هارنس بازیابی
در این مدل، به جای ارسال یک کوئری واحد، عامل (که در فایل src/lib/agent.ts پیادهسازی شده است) به چهار ابزار سبک سیستمفایل مجهز شده که با API بازیابی Index v2 مطابقت دارند:
- retrieve: این ابزار بر پایه
beta.retrieval.retrieveعمل میکند. جستوجوی معنایی ترکیبی (Hybrid Semantic Search) را با قابلیت بازرتبهبندی (Reranking) اختیاری اجرا میکند. پارامترهای کلیدی آن شاملquery(پرسوجو)،top_k(تعداد تکهها)،score_threshold(آستانه امتیاز)،rerank_top_n(تعداد برای بازرتبهبندی)،file_nameوfile_versionاست. خروجی این ابزار شامل تکههای متن و استنادات است. - findFiles: این ابزار بر پایه
beta.retrieval.findاست. فایلها را بر اساس نام دقیق یا زیررشتهها از طریق پارامترهایfile_nameوfile_name_containsجستوجو میکند و نتایج را بهصورت خودکار صفحهبندی (Paginate) میکند تا یک فهرست کامل از اسناد موجود تهیه شود. - readFile: این ابزار بر پایه
beta.retrieval.readعمل کرده و محتوای خام فایل را با استفاده ازfile_id(شناسه فایل)،offset(آفست) وmax_length(حداکثر طول) میخواند تا پنجرههای محتوایی دقیقی ایجاد کند. - grepFile: بر پایه
beta.retrieval.grepاست. یک الگوی خاص را در یک فایل با استفاده ازfile_id،pattern(الگو)،context_chars(کاراکترهای زمینه) وlimitتطبیق میدهد و موقعیتهای دقیق کاراکتری را برمیگرداند.
برای تضمین صحت، پرامپت سیستمی یک ترتیب عملیاتی سختگیرانه را تحمیل میکند: عامل باید ابتدا با findFiles فضای دانش را نقشهبرداری کند، سپس با retrieve جستوجو را محدود کرده و در نهایت پیش از استناد به منبع، با استفاده از readFile یا grepFile کلمات و عبارات دقیق را تأیید کند.
معماری فنی و نسخهگذاری
در لایهی زیرساختی، آپلودها از طریق یک خط لوله مشخص در src/lib/files.ts مدیریت میشوند. بایتهای فایل به دایرکتوری منبع LlamaCloud در پروژه منتقل میشوند. اپلیکیشن از Prisma برای نوشتن ردیفهای File و ProjectFile در یک پایگاهداده PostgreSQL استفاده میکند. پس از آپلود، یک همگامسازی (Sync) ایندکس تحریک میشود؛ هرچند سیستم منتظر پایان آن نمیماند (não-awaited)، اما رابط کاربری وضعیت را تا زمان آماده شدن اسناد بررسی (Poll) میکند.
یک ویژگی حیاتی، پیادهسازی نسخهگذاری (Versioning) برای هر فایل است که بر اساس جفتِ (پروژه، نام فایل) تعریف شده است. اگر کاربر سندی به نام nda.pdf را مجدداً در همان پروژه آپلود کند، سیستم نسخههای v1، v2 و v3 را بهصورت موازی نگه میدارد.
از آنجا که ابزار retrieve یک فیلتر متادیتای file_version را میپذیرد، عامل میتواند کنترل نسخه روی خودِ پایگاه دانش داشته باشد. این قابلیت به عامل اجازه میدهد تغییرات را در طول زمان ردیابی کند یا یک نسخه تاریخی خاص از یک خطمشی یا قرارداد را کوئری نماید.
AI SDK و استنادهای بصری
این عامل از ToolLoopAgent در Vercel AI SDK 6 بهره میبرد. این ساختار به کاربران اجازه میدهد کلیدهای API خود را وارد کرده و در هر نوبت، مدلهای OpenAI یا Anthropic را انتخاب کنند. استدلالها بهصورت جریانی (Stream) ارسال میشوند: مدلهای Claude از تفکر گسترده (Extended Thinking) و مدلهای استدلالی OpenAI از تلاش استدلالی متوسط (Medium Reasoning Effort) استفاده میکنند.
دقت سیستم از طریق استنادهای بصری (Visual Citations) تقویت شده است. به هر تکه بازیابیشده یک شناسه کوتاه (مثلاً cite:c7f2qa) اختصاص مییابد. عامل این شناسه را بهصورت درونمتنی با فرمت cite:<id> ارجاع میدهد.
زمانی که عامل به این شناسه ارجاع میدهد، رابط کاربری یک «چیپ» (Chip) قابل کلیک نمایش میدهد. با کلیک بر روی آن، تصویری (اسکرینشات) از صفحه منبع باز میشود که در آن مستطیلهای محدوده (Bounding-box rectangles) دقیقاً متن استناد شده را هایلایت میکنند؛ این یعنی عبور از تکههای متنی ساده به سمت اثبات بصری.
مقایسه RAG ساده در مقابل هارنس بازیابی
مقایسهی این دو مدل، تغییری بنیادی در نحوه اجرا را نشان میدهد:
| محور مقایسه | RAG ساده / تکضربه | هارنس بازیابی عاملمحور (Index v2) |
|---|---|---|
| جریان بازیابی | یک جستوجوی برداری برای هر کوئری | حلقه ابزار چندمرحلهای: یافتن $\rightarrow$ بازیابی $\rightarrow$ خواندن/grep |
| حالتهای جستوجو | فقط شباهت برداری | جستوجوی معنایی ترکیبی، کلمات کلیدی و grep با Regex |
| زمینه (Context) | تکههای ثابت top-k | خواندن کامل فایلها یا پنجرههای متنی بر اساس نیاز عامل |
| تازگی دادهها | ایندکس ایستا | خط لوله دائمی با همگامسازی و نسخهگذاری |
| کنترل دقت | عمدتاً پنهان | دسترسی مستقیم به top_k و score_threshold و rerank_top_n |
| استنادات | شناسههای تکه (Chunk IDs) | استنادهای بصری با اسکرینشات صفحه و Bbox |
| بهترین کاربرد | پاسخ به سوالات کوتاه | کارهای اسنادی طولانیمدت و پیچیده |
موارد کاربرد با اثرگذاری بالا
این طراحی دقیقاً برای حوزههایی هدفگذاری شده که عاملها باید در مجموعههای بزرگ و در حال تکامل از اسناد پیمایش کنند، مانند حقوق و فینتک.
- تحلیل قرارداد: برای پرسشی مانند «چه اطلاعیهای برای فسخ MSA لازم است؟»، عامل ابتدا لیست فایلها را میگیرد، یک بازیابی ترکیبی اجرا میکند و سپس بند دقیق را با grep مییابد تا پاسخی با استناد به صفحه خاص ارائه دهد.
- بررسیهای Due Diligence: در سناریوی اتاق داده (Data Room)، عامل میتواند با
findFilesاسناد را بر اساس نام پیدا کرده و سپس بهطور متوالی هر کاندید را باreadFileبخواند تا بندها را بدون نیاز به باز کردن دستی هر PDF توسط انسان، تطبیق دهد. - ردیابی خطمشیها: با استفاده از فیلتر
file_version(نسخه فایل)، عامل میتواند خطمشی فعلی را با نسخه قبلی مقایسه کرده و تغییرات خاص را شناسایی کند.
این رویکرد، شیوه حرفهای پیادهسازی AI را تغییر میدهد. تمرکز را از بهینهسازی مدلهای Embedding به طراحی گردشکارهای عاملمحوری منتقل میکند که تقلیدی از نحوه بازرسی واقعی یک وکیل از اتاق داده است. این استک کامل شامل TanStack Start، AI SDK 6، Prisma و WorkOS است و از کلیدهای رمزنگاریشده برای هر کاربر پشتیبانی میکند.
گام بعدی شما
- اگر توسعهدهنده RAG هستید، ساختار
src/lib/agent.tsدر ریپازیتوری legal-kb را برای یادگیری ترتیب عملیات (Operational Order) بررسی کنید. - برای کاهش توهمات در اسناد طولانی، ابزار grep را به جای تکیه صرف بر بردار معنایی در زنجیره عامل خود بگنجانید.
- قابلیت نسخهگذاری فایلها را برای پیادهسازی سیستمهای «تاریخچه تغییرات سند» آزمایش کنید.
اما تأثیر این رویکرد بر هزینههای استنتاج در مقیاس بزرگ هنوز جای بحث دارد — به تحلیل ما دربارهی بهینهسازی هزینههای GPU در مدلهای زبانی مراجعه کنید.



گفتگو