
سیستمهای نرمافزاری احتمالی؛ این است حقیقتِ پنهان در پسِ رابطهای کاربری زیبا. اگر میخواهید محصولی بسازید که فراتر از یک پرامپت هوشمندانه باشد، درک این واقعیت تنها راه دستیابی به قابلیت اطمینان است.
طبق اعلام وبسایت dev.to در ۱۹ سپتامبر ۲۰۲۶، مدیران محصول (PM) برای مدیریت توازن میان تأخیر، هزینه و دقت، نیازمند مدلهای ذهنی فنی دقیقی هستند. اکثر قابلیتهای هوش مصنوعی نه به دلیل کمهوشی مدل، بلکه به دلیل شکاف در درک معماری محصول شکست میخورند. در حالی که مهندسان بر ریاضیات تمرکز میکنند، مدیر محصول باید بداند توکنها چگونه به هزینههای API تبدیل میشوند و پنجرههای زمینه چگونه تجربه کاربر را محدود میکنند.
همانطور که در تحلیل قبلی ما دربارهی فرمتهای مدل مانند GGUF و GPTQ اشاره کردیم که بر نحوه ذخیرهسازی و فشردهسازی متمرکز بود، این چارچوب توضیح میدهد که مدلها در لحظه چگونه اطلاعات را پردازش میکنند. این موضوع در حالی اهمیت مییابد که صنعت از رابطهای سادهی چت به سمت گردشهای کاری عاملمحور (Agentic Workflows) حرکت میکند.
خط لوله توکنسازی
یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — کلمات را نمیخواند، بلکه توکنها را پردازش میکند. فرآیند توکنسازی (Tokenization) متن را به تکههای کوچکتر تبدیل میکند؛ مثلاً کلمه «internationalization» ممکن است به چندین توکن تقسیم شود. این تمایز حیاتی است زیرا توکنها، و نه کلمات، موتور محرک اقتصاد هوش مصنوعی هستند.
سادهترین مدل ذهنی این است: «یک LLM توکنها را به عنوان ورودی میگیرد و پیشبینی میکند کدام توکن باید در ادامه بیاید.» برای مثال، اگر مدل عبارت «پایتخت فرانسه است» را ببیند، احتمالات را برای توکن بعدی محاسبه میکند: پاریس (۹۲٪)، لندن (۲٪) و غیره. سپس توکن برتر را انتخاب کرده و این چرخه را تا پایان پاسخ تکرار میکند.
برای یک مدیر محصول، توکنسازی یک مسئله اقتصادی است. اگر برنامهای ۱۰ هزار کاربر داشته باشد که هر کدام روزانه ۱۰ درخواست با ۲ هزار توکن ورودی ارسال کنند، سیستم روزانه ۲۰۰ میلیون توکن پردازش میکند. این عدد مستقیماً بر صورتحساب API، توان عملیاتی (Throughput) و تأخیر (Latency) اثر میگذارد.
پس از توکنسازی، این واحدهای مجزا به بردار معنایی (Embedding) تبدیل میشوند — مثل کارت معرفی عددی برای هر واژه که میگوید این کلمه «همسایهی» چه کلمات دیگری است. این بردارها فضای عددی چندبعدی هستند که اجازه میدهند مدل روابط را بفهمد؛ مثلاً درک کند که «سیب» به «میوه» نزدیکتر است تا به «ماشین».
درون معماری ترنسفورمر
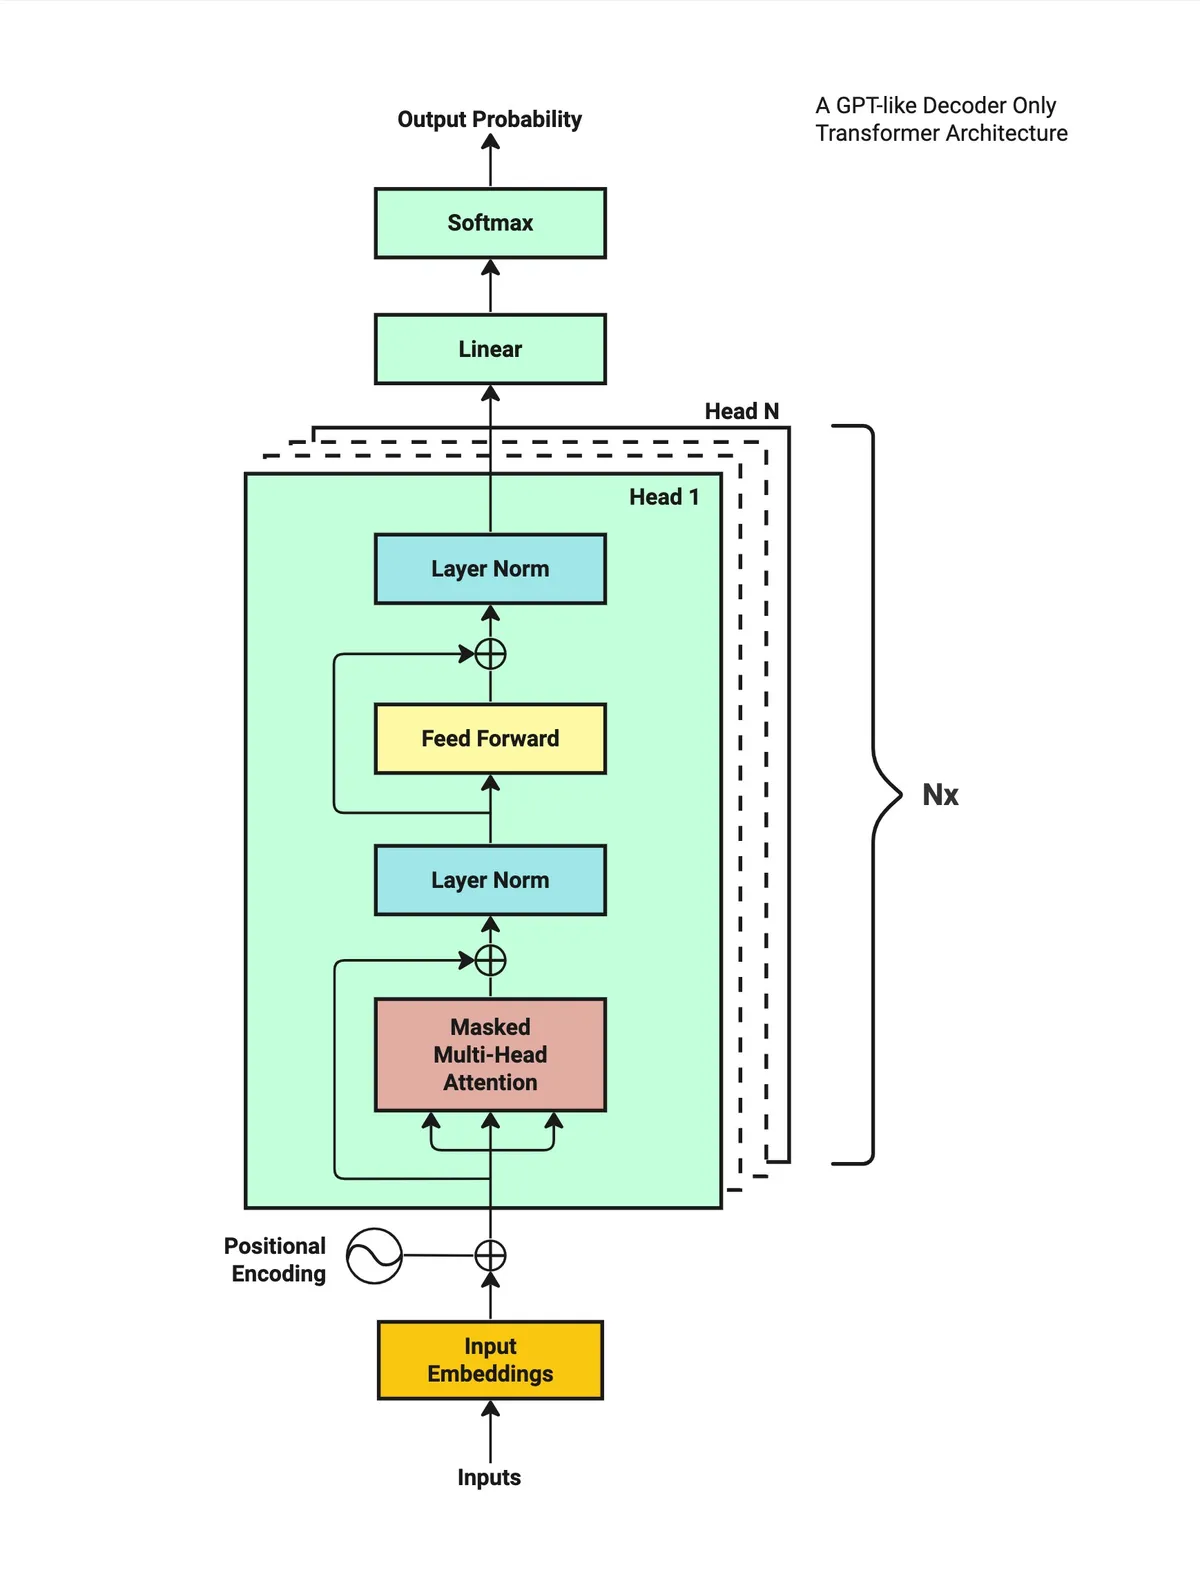
مدلهای مدرن بر پایه معماری ترنسفورمر (Transformer) بنا شدهاند که نخستین بار در مقاله سال ۲۰۱۷ با عنوان «Attention Is All You Need» معرفی شد. نوآوری اصلی، مکانیزم خودتوجهی (Self-Attention) است که به مدل اجازه میدهد تشخیص دهد کدام توکنها در یک توالی برای یکدیگر مرتبط هستند. باید به خاطر داشت که ترنسفورمر با LLM یکی نیست؛ ترنسفورمر معماری است و LLM مدلی است که با آن معماری ساخته شده است.
در جملهی «برنامهنویس لپتاپ را روی میز گذاشت چون خراب بود»، خودتوجهی به مدل کمک میکند تا کلمه «آن» (یا مفهوم خراب بودن) را به «لپتاپ» پیوند دهد، نه به «میز». این آگاهی از زمینه است که باعث میشود هوش مصنوعی زاینده منسجم به نظر برسد.
از نظر فنی، این اتفاق از طریق بردارهای پرسوجو (Query)، کلید (Key) و مقدار (Value) رخ میدهد. مدل میپرسد کدام بخشهای زمینه برای یک توکن خاص مرتبط هستند، امتیاز توجه را محاسبه کرده و یک نمایش وزندار جدید از آن توکن میسازد.
ترنسفورمرها از «سرهای توجه» متعددی استفاده میکنند تا انواع مختلف روابط را بهطور همزمان یاد بگیرند. همچنین از رمزگذاریهای موقعیتی (مانند RoPE یا ALiBi) بهره میبرند تا ترتیب کلمات را بفهمند و تفاوت میان «سگ مرد را گاز گرفت» و «مرد سگ را گاز گرفت» را درک کنند.
جزئیات بلوکهای ترنسفورمر
هر بلوک ترنسفورمر از اجزای تکرارشوندهای تشکیل شده است:
- خودتوجهی: تبادل اطلاعات زمینهای بین توکنها.
- اتصالات باقیمانده و نرمالسازی: تثبیت فرآیند یادگیری در لایههای متعدد.
- شبکه پیشخور (MLP): اعمال تبدیلات غیرخطی روی نمایشها پس از مرحله توجه.
این بلوکها در لایههای متعددی روی هم قرار میگیرند. هر لایه نمایش داده را تغییر میدهد و به همین دلیل است که مدلهای بزرگ به منابع محاسباتی عظیمی نیاز دارند.
پارامترهای مدل و آموزش
وقتی مدلی «7B» یا «70B» نامیده میشود، B به معنای میلیاردها پارامتر (Parameters) است. اینها وزنهای عددی هستند که در طول آموزش برای کاهش «زیان» (Loss) — یعنی تفاوت بین پیشبینی مدل و توکن واقعی — تنظیم میشوند.
آموزش در چندین مرحله رخ میدهد:
- پیشآموزش (Pretraining): آموزش در مقیاس وسیع روی دادههای عظیم برای ساخت مدل پایه.
- تنظیم دستوری (Instruction Tuning): اصلاح مدل برای پیروی از دستورات خاص.
- همراستاسازی (Alignment): استفاده از تکنیکهایی مثل RLHF برای تضمین ایمنی و کاربردی بودن.
- تیم قرمز و ارزیابی: تستهای امنیتی برای جلوگیری از خروجیهای مضر.
- انطباق دامنه: تخصصی کردن مدل برای صنایع یا وظایف خاص.
مدیران محصول باید تفاوت آموزش و استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه خودِ آشپزی و نه دورهی آموزش آشپز — را بدانند. آموزش یعنی تغییر پارامترها، اما استنتاج یعنی استفاده از پارامترهای ثابت برای تولید پاسخ. برای اکثر تصمیمات محصول، بهینهسازی استنتاج اهرم اصلی موفقیت است.
چرخه حیات استنتاج
وقتی کاربر پرامپتی میفرستد، سیستم پاسخ را توکن به توکن تولید میکند. مدل ابتدا «لاجیتها» (Logits) یا امتیازات خام را برای تمام توکنهای احتمالی تولید کرده و سپس با تابع سافتمکس (Softmax) آنها را به احتمال تبدیل میکند.
تنظیمات دما (Temperature) این فرآیند را کنترل میکند:
- دمای پایین: نمونهگیری متمرکزتر. مدل قطعی و سازگار است (مناسب برای استخراج داده از فاکتورها).
- دمای بالا: نمونهگیری متنوعتر. خلاقیت بیشتر میشود (مناسب برای نویسندگی).
به دلیل تولید متوالی توکنها، برنامهها میتوانند پاسخها را «استریم» کنند. این یک تصمیم UX است که تأخیر ادراکشده را کاهش میدهد و باعث میشود پاسخ سریعتر به نظر برسد، حتی اگر زمان کل تولید تغییر نکند.
پنجره زمینه و KV Cache
پنجره زمینه (Context Window) — میزان متنی که مدل همزمان «در ذهن» نگه میدارد، شبیه میز کاری که جا برای چند ورق دارد — حد نهایی اطلاعاتی است که مدل در یک تعامل پردازش میکند. این شامل دستورات سیستمی، تاریخچه گفتگو، اسناد بازیابیشده و خروجی تولید شده است.
اما گنجاندن داده در پنجره، تضمینکننده استفاده مؤثر از آن نیست. زمینههای بزرگتر اغلب منجر به هزینه بیشتر، تأخیر بالاتر و ریسک نادیده گرفتن اطلاعات توسط مدل میشوند.
برای بهینهسازی، سیستمها از KV Cache استفاده میکنند. این قابلیت به مدل اجازه میدهد اطلاعات مربوط به توجه در توکنهای قبلی را بازیافت کند و مجبور نباشد برای هر توکن جدید، کل توالی را دوباره محاسبه کند. این موضوع برای کاهش تأخیر استنتاج و مدیریت حافظه GPU حیاتی است.
RAG در برابر تنظیم دقیق
یکی از رایجترین چالشهای محصول، انتخاب بین تولید بازیابیافزا (RAG) — مثل دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — و تنظیم دقیق (Fine-tuning) است. RAG اطلاعات خارجی را در زمان اجرا بازیابی کرده و به پرامپت اضافه میکند. در مقابل، تنظیم دقیق — مثل وقتی به یک پزشک عمومی، تخصص پوست میدهیم — مدل را روی یک مجموعه داده تخصصی آموزش میدهد تا رفتار یا سبک آن تغییر کند.
ماتریس تصمیمگیری:
- از RAG استفاده کنید برای: اطلاعاتی که مدام تغییر میکنند، دانش داخلی شرکت (ویکیها)، پاسخهای مستند به اسناد و مواردی که نیاز به ارجاع دارند.
- از تنظیم دقیق استفاده کنید برای: سبکهای خاص پاسخدهی، رفتارهای تخصصی در وظایف و فرمتهای خروجی ثابت.
توهمات و حفاظها
مدلهای زبانی پایگاه داده نیستند، بلکه پیشبینیکننده الگو هستند. توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که اصلاً وجود ندارد — زمانی رخ میدهد که مدل بر اساس الگوها توکن بعدی را پیشبینی میکند، نه با چک کردن یک جدول واقعیت.
کاهش توهمات نیازمند رویکردی چندلایه است:
- مبنیسازی (Grounding): الزام مدل به تکیه بر اطلاعات RAG.
- خروجیهای ساختاریافته: محدود کردن فرمت پاسخ.
- فراخوانی ابزار (Tool Calling): اجازه بازیابی داده از سیستمهای داخلی معتبر.
- حفاظها (Guardrails): اعتبارسنجی یا مسدود کردن خروجیهای مشکلساز.
- ارزیابیها: تست مداوم سیستم با مجموعههای داده مرجع.
از LLM به عامل هوش مصنوعی
یک LLM یک جزء است، اما یک عامل (Agent) یک سامانه است. در حالی که LLM استدلال میکند، عامل از این استدلال برای تعامل با ابزارها (پایگاه داده، CRM، تقویم) جهت رسیدن به یک هدف استفاده میکند. در یک گردش کار عاملمحور، LLM تصمیم میگیرد کدام ابزار لازم است، برنامه ابزار را اجرا میکند، نتیجه مشاهده میشود و LLM گام بعدی را تعیین میکند. این گذار از مدلهای ساده به سیستمهای پیچیده، نیازمند جایگزینی زیرساختهای سختگیرانه با مهندسی پرامپت در عاملهای هوش است تا از شکست در مقیاس عملیاتی جلوگیری شود.
پشته تولید هوش مصنوعی
فراخوانی یک API ساده است، اما ساخت یک محصول دشوار. یک پشته آماده تولید شامل یک ارکستراتور، لایه RAG، درگاه مدل (Model Gateway) برای مسیریابی و لایه اعتبارسنجی برای حفاظها است. هزینه کل فقط قیمت API نیست؛ بلکه شامل فراخوانیهای بردار معنایی، بازرتبهبندی (Reranking)، ذخیرهسازی در پایگاهداده برداری و محاسبات است. برای دستیابی به پایداری در این پشته، استفاده از جریانهای کاری ساختاریافته در برابر رابطهای ساده کلید مقیاسپذیری LLMها در محیطهای سازمانی است.
انتخاب مدل یک موازنه است. مدلهای با قابلیت بالا (مثلاً ۷۰ میلیارد پارامتر) برای استدلالهای پیچیده لازماند، اما مدلهای کوچکتر برای طبقهبندیهای حجیم جهت کاهش هزینه و تأخیر بهترند.
معیارهای عملکرد
عملکرد هوش مصنوعی بخشی از تجربه کاربر است. مدیران محصول باید این موارد را رصد کنند:
- زمان تا نخستین توکن (TTFT): سرعت مشاهده شروع پاسخ توسط کاربر.
- توکن در ثانیه: سرعت تولید متن.
- تأخیر بازیابی: زمان یافتن اسناد مرتبط در RAG.
- نرخ خطا: دفعاتی که سیستم شکست میخورد یا خروجی نامعتبر میدهد.
گام بعدی شما
- بررسی توازن بین مدلهای کوچک (SLM) و مدلهای بزرگ برای کاهش هزینه استنتاج در بخشهای تکراری محصول.
- پیادهسازی لایه بازرتبهبندی (Reranker) در معماری RAG برای کاهش نرخ توهمات.
- تحلیل TTFT در محیط تولید برای بهینهسازی تجربه کاربر از طریق استریم کردن پاسخها.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید. در این راستا، درک این موضوع که چرا LLMها در نقش مترجم سختافزار موفقتر از یک چتبات ساده عمل میکنند، دیدگاه شما را نسبت به آینده سختافزار تغییر میدهد.



گفتگو