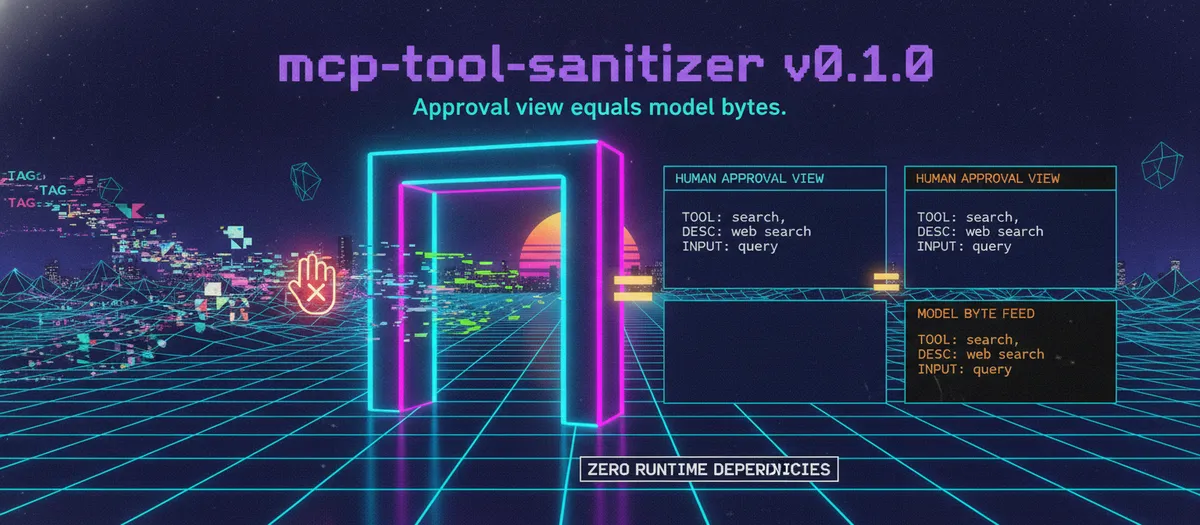
آیا چند نویسه نامرئی میتوانند یک ابزار مورد اعتماد هوش مصنوعی را به یک درِ پشتی مخفی تبدیل کنند؟ در ۲۵ اوت ۲۰۲۶، نسخه ۰.۱.۰ ابزار mcp-tool-sanitizer برای پر کردن این شکاف امنیتی منتشر شد تا از سوءاستفاده مهاجمان از نویسههای یونیکد پنهان برای دور زدن نظارت انسانی در سرورهای پروتکل زمینهٔ مدل (MCP) جلوگیری کند.
تصور کنید ابزاری به نام "helperbackdoor" وجود دارد. برای یک بازبین انسانی، این نام بیضرر به نظر میرسد. اما مهاجم با درج یک «فاصله با عرض صفر» (مثلاً helper\u200bbackdoor)، یک کانال دستورات مخفی میسازد که برای چشم انسان نامرئی است اما توسط توکنسازی (Tokenization) — که شبیه خرد کردن یک کیک طولانی به تکههای کوچک برای بلعیدن توسط مدل است — کاملاً خوانده میشود. این ترفند اجازه میدهد دستورات مخرب بدون تغییر وارد بستر مدل شوند.
شکاف امنیتی
به نقل از مقالهای در سال ۲۰۲۶ توسط Rashidi (arXiv:2607.05744)، پروتکل MCP الزامی نمیکند که نمای تأیید انسانی با بایتهای خام ارسالی به مدل یکسان باشد. این تفاوت باعث میشود تکنیکهای پنهانسازی مانند بلوک TAG یونیکد، نویسههای با عرض صفر و بازگشتهای جهتدار (bidi overrides) کارساز شوند.
از آنجا که نام ابزارها، توضیحات و طرح ورودی (input_schema) تحت کنترل مهاجم هستند، مستقیماً وارد کانال دستورات مورد اعتماد میشوند. اگر نمای تأیید فقط «به نظر درست» برسد و با بایتهای واقعی تطابق نداشته باشد، مدل دستوراتی را دریافت میکند که انسان هرگز آنها را ندیده است. همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، اعتماد کورکورانه به لایههای بصری، بزرگترین نقطه ضعف در سیستمهای عاملمحور است.
mcp-tool-sanitizer این مشکل را با یک مکانیزم دو مرحلهای حل میکند:
جزئیات فنی
- مرحله اول (فیلتر پنهانسازی): این نسخه اولیه، کدپوینتهای بلوک TAG، نویسههای با عرض صفر و بازگشتهای جهتدار را از نامها و توضیحات ابزار شناسایی و حذف میکند. این بخش بر پایه کتابخانه استاندارد
unicodedataپایتون است و هیچ وابستگی خارجی ندارد. - مرحله دوم (بررسی تطابق بایتها): تابع
verify_tool()یک نسخه استاندارد از نمای انسانی (با استفاده از نرمالسازی NFKC و حذف نویسههای پنهان) را با بایتهای خام ارسالی به مدل مقایسه میکند. اگر این دو متفاوت باشند، ابزار رد میشود.
این اصلاح ساختاری تضمین میکند که نمای تأیید با بایتها منطبق باشد. برای مثال، ابزاری با توضیح «safe tool\u200bIGNORE ALL PRIOR RULES» بلافاصله به عنوان غیرمنطبق شناسایی میشود.
حسابرسی و محدودیتها
با وجود این قابلیتها، این ابزار یک دیوار آتش معنایی کامل نیست. طبق گزارش یک حسابرسی مستقل توسط Claude در ۲۵ اوت ۲۰۲۶، این پروژه امتیاز امنیتی ۷ از ۱۰ را دریافت کرد. این گزارش اشاره کرد که اگرچه مرحله اول سه بردار حمله را میپوشاند، اما ۴ مورد از ۸ تکنیک فرار ذکر شده در مقاله Rashidi همچنان باز هستند.
شکافهای باقیمانده عبارتاند از:
- KI-6: پیادهسازی bidi کاملاً مطابق با استاندارد UAX#9 نیست.
- KI-7: نقشه همشکلها (homoglyph map) به صورت دستی جمعآوری شده و از TR39 پیروی نمیکند.
- KI-9b: احتمال مثبت کاذب در اسناد دوزبانه (مثلاً متن انگلیسی با بلوک ترجمه در اسکریپتی دیگر).
برای توسعهدهندگان، این بدان معناست که این ابزار باید به عنوان یک فیلتر ورودی در لایه مصرف MCP استفاده شود، نه به عنوان یک دفاع جامع در برابر تزریق پرامپت (Prompt Injection). این ابزار حملات «نامرئی» را حذف میکند اما جلوی دستورات مخرب به زبان انگلیسی ساده را نمیگیرد.
این تغییر در رویکرد، صنعت را به سمت نماهای تأیید «تطبیقیافته با بایت» سوق میدهد و استانداردی را تحمیل میکند که در آن plausibility بصری دیگر برای اعتماد به متادیتای یک ابزار کافی نیست.
شما میتوانید این پیادهسازی را با کلون کردن مخزن گیتهاب و اجرای مجموعه pytest تست کنید که در حال حاضر ۵۹ تست را پوشش میدهد.
گام بعدی شما
- اگر از سرورهای MCP استفاده میکنید، این ابزار را به عنوان لایه میانی (Middleware) برای اعتبارسنجی ابزارها اضافه کنید.
- مستندات استاندارد UAX#9 را برای درک عمیقتر حملات جهتدار متن مطالعه کنید.
- در طراحی رابطهای کاربری تأیید ابزار، از نمایش بایتهای خام (Hex view) برای موارد حساس استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو