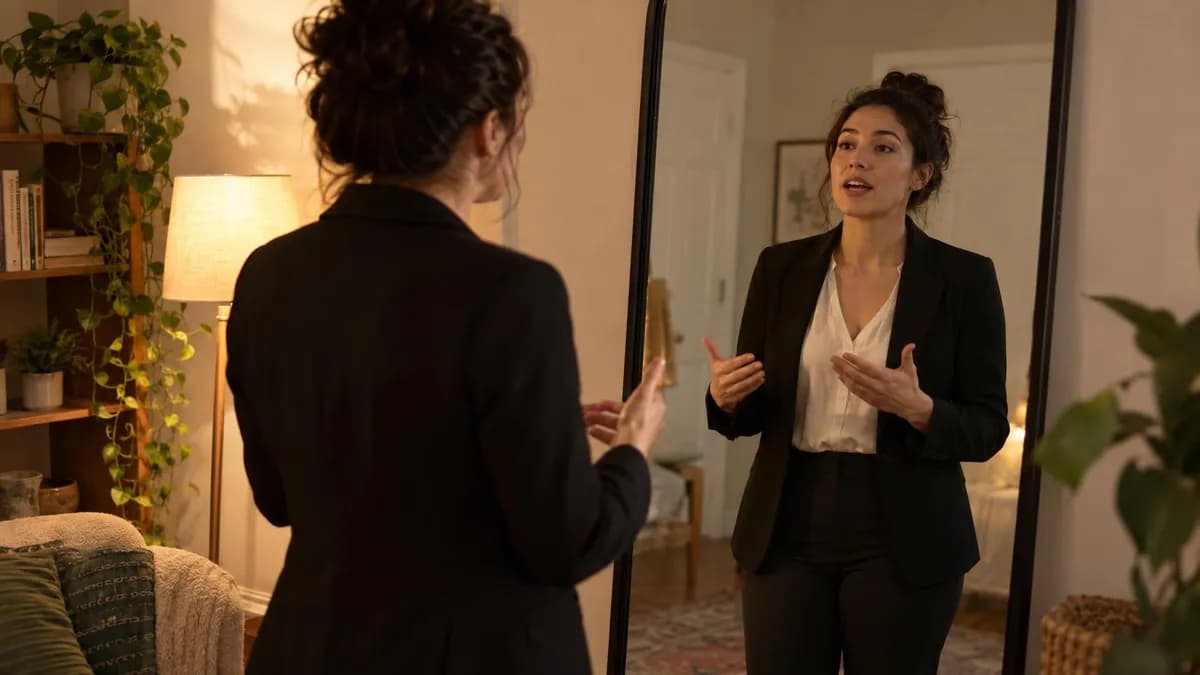
مِتا در ۵ نوامبر ۲۰۲۶ عامل موز را با گفتگوی صوتی زمانواقع و آواتار بیانگر در آمریکا منتشر کرد. این سیستم با معماری پخشرو واحد تأخیر پاسخ را به ۸۷۰ میلیثانیه میرساند. این رویکرد به یکپارچهسازی وظایف پسزمینه در یک جلسه، هدف از معماری جدید Muse Wonder برای حل بنبستهای عاملمحور است. رونمایی اولیه موز از طریق اپلیکیشن و واتساپ، در پی عرضه Muse برای آیپد تنها یک ماه پس از نسخه موبایل قرار گرفت.
پیشینه و زمانبندی انتشار
موز برای نخستین بار در ۸ سپتامبر ۲۰۲۶ با تعامل از طریق اپلیکیشن موز یا واتساپ رونمایی شد و قابلیتهای ارسال ایمیل، رزرو سفر و کارهای پسزمینهی پایدار را ارائه داد. پیشنمایش Connect ۲۰۲۶ در ۲۳ سپتامبر ۲۰۲۶ مکالمات طولانی زمانواقع و مفهوم آواتار زمانواقع موز را نشان داد؛ اعلامیه ۵ نوامبر این دموها را به استقرار کاربری تبدیل کرد.
معماری پخشرو واحد و تأخیر ۸۷۰ میلیثانیه
موز اکنون از یک خط لوله علی (causal pipeline) واحد بهره میبرد که مدل صدا، رمزگشای صوت (audio decoder) و مدل آواتار را در یک جریان توکن مشترک متصل میکند. توکنهای گفتار هم محتوا و هم نحوه تحویل را کدگذاری میکنند؛ رمزگشای صوت آنها را به گفتار تبدیل میکند و مدل آواتار از همان جریان برای تولید اجرا بصری همگام استفاده میکند. این طراحی انحراف همگامسازی (synchronization drift) را که در سیستمهای متوالی (cascaded) رایج است، از ریشه حذف میکند.
جزئیات فنی: ترنسفورمر انتشار صوت-مشتق و تقطیر ۶۰ برابری
آواتار یک ترنسفورمر انتشار (Diffusion Transformer) صوت-مشتق است که بر جریان توکن، رسانههای مرجع (مانند عکس پورتریه) و یک پنجره نهانی متحرک (rolling latent window) از ویدیوهای اخیر مشروط شده است. تقطیر (distillation) فرآیند تولید را از ۱۲۰ ارزیابی راهنماییشده معلم (teacher) به دو ارزیابی بدونراهنمای شاگرد (student) در هر تکه (chunk) کاهش داده — یک جهش ۶۰ برابری که برای نخستین بار تولید ویدیو پخشرو را از نظر محاسباتی در مقیاس سرویسدهی ممکن میسازد.
شاخصهای کلیدی کارایی
- رزولوشن خروجی: ویدیو پورتریه ۴۴۸ در ۷۶۸ در ۲۵ فریم بر ثانیه
- تأخیر از رأس تا پای: حدود ۸۷۰ میلیثانیه از پایان نوبت کاربر تا اولین بایت پاسخ همگام
- بازده تقطیر: کاهش ۶۰ برابری از ۱۲۰ ارزیابی معلم به دو ارزیابی شاگرد در هر تکه
- ظرفیت سرویسدهی: هشتبرابری بر پایه خط پایه دومرحلهای BF16
- همزمانی: ۱۲ جلسه همزمان تولید ویدیو زمانواقع روی یک GB200 واحد
ظرفیت سرویسدهی و همزمانی روی GB200
هشتبرابری ظرفیت و پشتیبانی از ۱۲ جلسه همزمان روی یک GB200 نشان میدهد که استنتاج مداوم ویدیو انتشارِ پیوسته اکنون اقتصاداً قابلتوجیه است. این پیشرفت مسیر استقرار عاملهای چندوجهی (multimodal) در مقیاس میلیونی را هموار میکند.
مصونیتها: واترمارک نامرئی مِتا ویدیو سیل
ویدیوهای آواتار تولیدشده شامل واترمارک نامرئی و پایدار «مِتا ویدیو سیل» (Meta Video Seal) هستند که بدون افزودن تأخیر زمانواقع تعبیه میشود. اپلیکیشن صدای قابل انتخاب در صدها سبک ارائه میدهد (مثالها: سبک پرانرژی نیویورکی و دزد دریایی). کاربران میتوانند تعامل را فقط صوتی نگه دارند، آواتار را در کنار چت قرار دهند یا به نمای تمامصفحه روبرو (fullscreen face-to-face) تغییر دهند. عامل در حین مکالمه روی وظایف تفویضشده — برنامهریزی سفر، تمرین مصاحبه، نگارش ایمیل — کار میکند.
چشمانداز رقابتی و گامهای بعدی
موز نخستین عامل اصلی است که صدا قابلوقفه (interruptible)، حضور بصری بیانگر و استفاده از ابزارِ پسزمینه را در یک جلسه ادغام میکند. پروژه آسترا (Project Astra) گوگل و حالت صدا پیشرفته (Advanced Voice Mode) اوپنایآی تأخیر پایین در گفتار را نشان دادهاند اما نه جریان آواتار یکپارچه با اجرای وظیفه پایدار. آزمون بعدی زمانی است که همین پشته بر روی عینکهای هوش مصنوعی (AI Glasses) و دستگاه جیبی موز چارم (Muse Charm) — هر دو فاکتورهای شکل دست آزاد و صدا-اول — مستقر شود. محدودیتهای حرارتی و انرژی روی دستگاه نشان میدهد که آیا پیشرفتهای تقطیر بدون انتقال به ابری (cloud offload) برقرار میمانند. توسعهدهندگان باید دسترسی API به خط لوله آواتارِ پخشرو را رصد کنند؛ این دسترسی میتواند یک کلاس جدید از اپلیکیشنهای چندوجهیِ زمانواقع را باز کند.
گفتگو