تصور کنید در پروندهٔ یک ملک، یک ردیف از پایگاهداده بیان میکند که خانه سه اتاقخواب دارد؛ در حالت عادی این مورد بهعنوان یک حقیقت مطلق پذیرفته میشود، اما به محض اینکه شخص دومی با این عدد مخالفت کند، آن حقیقت به یک «دروغ» تبدیل میشود. ML Systems برای حل این بحران بنیادین در یکپارچگی دادهها، مفهوم «واقعیت» (Fact) را در خط لولهٔ دادههای ساختمانی خود حذف و جایگزین آن را «ادعا» (Claim) کرده است.
بیشتر سامانههای مدیریت ساختمان، دادهها را بهمحض ورود بهعنوان حقیقت مطلق میپذیرند. برای مثال، اگر ردیفی در دیتابیس بگوید سقف بنا ۵ سال پیش تعویض شده یا متراژ خانه ۲۰۰۰ فوت مربع است، سیستم از لحظه تایپ این اعداد، آنها را حقیقت میداند. اما این مدل زمانی فرو میپاشد که یک صاحبخانه، یک ارزیاب شهرداری و یک عامل هوش مصنوعی (AI Agent) همزمان توصیفات متفاوتی از یک ملک ارائه دهند. در زنجیرهٔ حساس و پرریسکِ اعطای وام، تخریب بنا و ساختوساز، یک «واقعیت» اشتباه میتواند منجر به ریسکهای مالی عظیمی شود. این چالش با بحران گستردهتری در دنیای هوش مصنوعی همسو است، جایی که بسیاری از مقالات فنی تولیدشده توسط AI حاوی ادعاهای ساختگی هستند و اعتماد به دادههای خودکار را به شدت کاهش دادهاند.
طبق یک گزارش فنی که در ۶ سپتامبر ۲۰۲۶ منتشر شد، ML Systems از یک «دفتر کل اصلی» (Master Ledger) برای ردیابی هر تکه داده بهعنوان یک ادعا استفاده میکند. در این ساختار، هر ملک توسط یک رکورد قابلحسابرسی (Auditable Record) نمایش داده میشود که نویسندگان متعددی دارد. هر ورودی در این سیستم به سه ویژگی خاص متصل است: منبع (Source)، درجهٔ شواهد (Evidence Grade) و وضعیت تأیید (Verification State). در این معماری، هیچ دادهای بهصورت حقیقتِ عریان و بدون پشتوانه وارد سیستم نمیشود. این رویکرد در واقع پیادهسازی عملی از راهکارهای جدید برای صادقانه کردن تحلیلهای AI از طریق گزارشهای قابلحسابرسی است تا از توهمات مدلهای زبانی جلوگیری شود.
مکانیزم مرجعیتِ دامنه
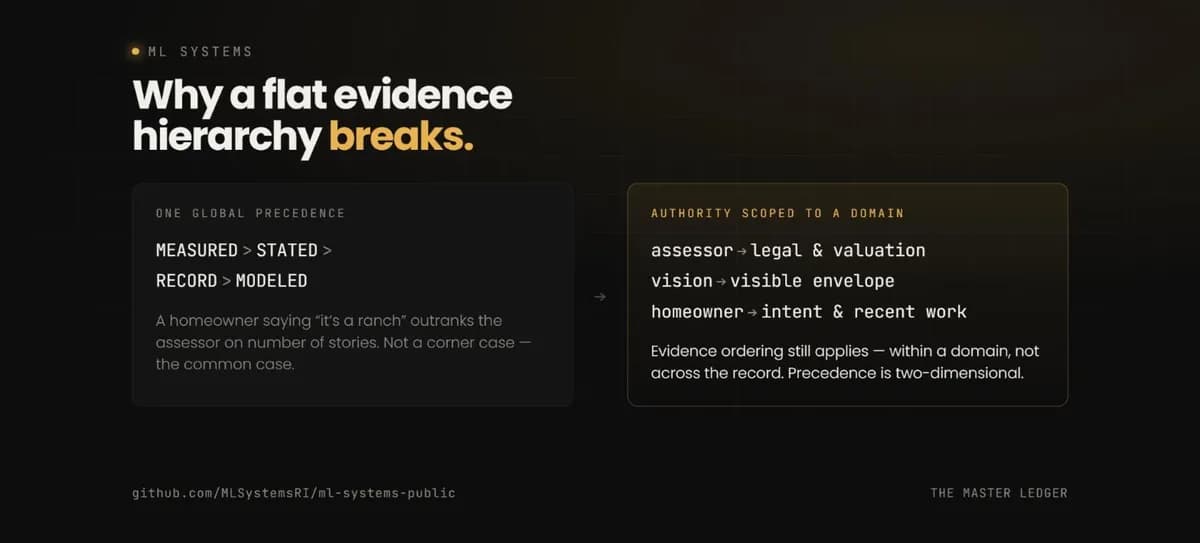
سیستمهای سنتی معمولاً از یک سلسلهمراتب تخت (Flat Precedence) استفاده میکنند؛ برای مثال، ساختاری که در آن «اندازهگیری شده» > «بیان شده» > «ثبت شده» > «مدلسازی شده» است. در چنین مدلی، یک اندازهگیری فیزیکی همیشه بر یک رکورد مکتوب برتری دارد. ML Systems استدلال میکند که این رویکرد اشتباه است زیرا باعث ایجاد خطاهای رایج در موارد معمول میشود. برای مثال، در یک مدل تخت، اگر صاحبخانه ادعا کند خانه از نوع «رانچ» است (STATED)، این ادعا بر رکورد ارزیاب درباره تعداد طبقات (RECORD) اولویت مییابد، در حالی که صاحبخانه ممکن است درباره مفاهیم قانونی اشتباه کند.
صاحبان ملک اغلب درباره واقعیتهای قانونی اشتباه میکنند، اما درباره جزئیات داخلی خانه که در رکوردهای رسمی ثبت نشده، درست میگویند. برای رفع این تضاد، سیستم مرجعیت را به دامنههای خاص محدود میکند:
- ارزیابان شهری: مرجع نهایی در واقعیتهای قانونی و دادههای ارزشگذاری (مانند دادههای VGSI یا ارزشگذاری شهرداری).
- هوش مصنوعی بینایی: عاملهایی مانند VERA مرجع بصریِ پوسته و نمای ساختمان هستند.
- صاحبان ملک: مرجع نیتهای کاربر و بازسازیهای اخیر که در اسناد ثبت نشده است.
- عاملهای تخصصی: مدلهای هوش مصنوعی مانند CDA (برای برآورد متریال/Takeoffs) و REAPER (برای محاسبه تناژ) ادعاهای تخصصی در دامنههای خود ارائه میدهند.
بنابراین اولویتبندی در این سیستم دوبعدی است: سیستم ابتدا بررسی میکند که چه کسی مالک آن دامنه خاص است و سپس کیفیت شواهد ارائه شده را میسنجد. این رویکرد تضمین میکند که یک رکورد با نویسندگان متعدد بتواند در مواجهه با ورودیهای دنیای واقعی، پایداری خود را حفظ کند.
مدیریت تضادها و بنبستها
به جای استفاده از استراتژی «آخرین تغییر برنده است» (Last Write Wins) یا استراتژیهای ادغام (Merge) که بهطور خاموش یک برنده را برای پاکسازی دادهها انتخاب میکنند، دفتر کل اصلی تضادها را حفظ میکند. یک بنبست (Standoff) میان دو منبع معتبر، بهجای آنکه یک باگ برای حذف باشد، بهعنوان یک «اطلاعات ارزشمند» درباره ملک تلقی میشود. این متدولوژی دقیقاً برای مقابله با رفتارهای مخربی است که در آن عاملهای کدنویس برای پوشاندن شکافهای اطلاعاتی به جعل دادهها روی میآورند.
ورودیها در نهایت به پنج وضعیت متمایز تبدیل میشوند:
- تأییدشده (Confirmed): زمانی که چندین منبع مستقل با هم توافق دارند.
- تطبیقیافته (Reconciled): منابع مخالف بودند، اما اختلاف از طریق مرجعیت دامنه و درجه شواهد حل شد.
- تکمنبعی (Single-source): تنها یک منبع وجود دارد؛ داده ثبت میشود اما علامتگذاری (Flag) میگردد.
- متضاد (Conflict): یک بنبست واقعی که بهجای پنهان شدن، برای کاربر نمایش داده میشود.
- تأییدنشده (Unverified): دادهای که هنوز هیچ مهر تأییدی روی آن زده نشده است.
دو قانون سختگیرانه بر این فرآیند حاکم است. اول، بنبستها بر اساس «درجه شواهد» مدیریت میشوند، نه رتبه یا مقام. یک طرف با مرجعیت بالا اما شواهد ضعیف، بهطور خودکار بر طرفی با مرجعیت پایین اما شواهد قوی پیروز نمیشود؛ مرجعیت تنها «حق صحبت» در یک دامنه را میدهد، نه «حق پیروزی» بدون داشتن مدرک. دوم، ادعاهای مشکوک حذف نمیشوند، بلکه تنزل رتبه مییابند. ادعا در رکورد باقی میماند اما با جایگاه پایینتر، تا اگر بعدها شواهدی برای حمایت از آن پیدا شد، بتوان آن را بازیابی کرد و بدین ترتیب ردپای حسابرسی (Audit Trail) حفظ شود.
یکپارچگی رمزنگاری و انقضا
برای جلوگیری از ویرایشهای خاموش و بدون اثر، سیستم از فرآیند تأیید دو-کلیدی شامل صاحبخانه و یک متصدی انسانی (Custodian) استفاده میکند. هر مهر تأیید (VER:...) از طریق یک entryHash بهطور مستقیم به محتوا متصل است.
مکانیزم فنی به این صورت عمل میکند:entry.value $ \rightarrow $ entryHash $ \rightarrow $ entryHash + signer $ \rightarrow $ VER: stamp
اگر مقداری در دادهها ویرایش شود، entryHash تغییر میکند و امضا بهطور خودکار منقضی (Lapse) میشود. این تغییر، پایگاهداده را از یک محیط صرفاً قابلویرایش به یک دفتر کل قابلحسابرسی تبدیل میکند. اکثر ابزارهای داخلی در این نقطه شکست میخورند، زیرا ردیفی در دیتابیس که ستون approved_by دارد، هیچ پیوند فیزیکی و ریاضی بین تأییدیه و خودِ داده ندارد. در Master Ledger، انقضا یک خطا نیست، بلکه گزارش درست سیستم است که یک ادعا نیاز به تأیید مجدد دارد.
نظارت متصدی انسانی
متصدی انسانی بهجای استفاده از یک صندوق ورودی (Inbox) ساده، از یک «صف بررسی مشتقشده» (Derived Review Queue) استفاده میکند. این صف توسط رویدادها (Events) به جلو رانده نمیشود، بلکه بهطور مستمر از روی تمام خانههای موجود در سیستم مشتق میشود. این صف موارد را بر اساس ریسک با اولویتهای زیر مرتب میکند:
۱. قرنطینه شده (Quarantined)
۲. منقضی شده (Lapsed)
۳. تأییدنشده (Unverified)
۴. در انتظار مهر (Awaiting-stamp)
۵. بدون مهر (Unstamped)
۶. مهرخورده (Stamped)
این ساختار تضمین میکند رکوردهایی که حتی ۶ ماه است دستنخورده ماندهاند، همچنان با اولویت درست برای بررسی ظاهر شوند. این مدل ریسک ذاتی سیستمهای رویداد-محور را حذف میکند؛ جایی که دادههای ارسالنشده — که در واقع بیشترین ریسک را دارند — بهسادگی فراموش میشوند.
رابط کاربری و زیرساخت محور-رکورد
در اپلیکیشن، دفتر کل بهصورت «رکورد-محور» (Record-first) نمایش داده میشود. پینها، رکوردها و امتیازها در یک ترتیب تخت ظاهر میشوند. نمادهای تأیید-کننده (⚖) تا زمان مهر خوردن کمرنگ میمانند تا وضعیت اعتبارسنجی در هر خط بهوضوح قابل مشاهده باشد. برای حفظ خوانایی دادهها، «پوسته ساختمان» (Building Envelope) ادعاهای مربوط به تکتک دیوارها را جذب میکند؛ یعنی در حالی که ادعاهای سطح دیوار در دادهها وجود دارند، اما واحد نمایش در رابط کاربری نیستند.
این دفتر کل بهعنوان زیربنای (Substrate) چندین خروجی با ارزش بالا عمل میکند:
- HomeGenome: کوچکترین توصیف کامل که میتوان از طریق آن یک خانه را بهطور کامل بازسازی کرد.
- Loan Pit: یک محیط مزایده معکوس که در آن وامدهندگان بر اساس یک توصیف فشرده و قابلتأیید از وثیقه رقابت میکنند، بهجای اینکه با فایلهای PDF سر و کار داشته باشند.
- REAPER: تبدیل ورودیهای تأییدشده به یک بانک متریال بازیافتی و فید بازار برای مواد بازیابی شده.
- Collective Ontology: ورودیهای تأییدشده و حقیقت-زمینی (Ground-truth)، این هستیشناسی را به قدری قابلاعتماد میکند که بتوان لایسنس آن را فروخت.
ML Systems استدلال میکند که دادههای مرجع ساختمانی تنها زمانی قابل فروش (Licensable) هستند که خریدار بتواند منشأ (Provenance) هر ورودی را بررسی کند. در واقع، منشأ دلیل ارزش داشتن داده است، نه صرفاً یک ویژگی برای رعایت قوانین (Compliance).
برای حفظ این انضباط، شرکت حتی مستندات عمومی خود را با سه برچسب واقعیت علامتگذاری میکند: «اندازهگیری شده» (MEASURED - امروز اعتبارسنجی شده)، «مدلسازی شده» (MODELED - پیشبینی کالیبره شده)، یا «آرمانی» (ASPIRATIONAL - یک هدف). برای مثال، توالی جرثقیل تخریب با برچسب ASPIRATIONAL علامتگذاری شده است، زیرا هنوز هیچ تخریب واقعی توسط ML Systems انجام نشده است. سیستمی که از پذیرش ادعاهای بدون برچسب درباره یک خانه خودداری میکند، نباید ادعاهای بدون برچسب درباره خودش داشته باشد.
گام بعدی شما
- اگر در حال طراحی سیستمهای مدیریت داده هستید، مدل «ادعا بهجای واقعیت» را برای کاهش ریسک در دادههای متناقض بررسی کنید.
- ساختار تأیید مبتنی بر هش (Hash-based verification) را برای جایگزینی ستونهای سادهٔ
approved_byدر دیتابیسهای خود به کار ببرید. - اولویتبندی صفهای بررسی را از «رویداد-محور» به «ریسک-محور» تغییر دهید تا دادههای رهاشده فراموش نشوند.
اما تأثیر این رویکرد بر کاهش هزینههای بیمه ساختمان حتی چشمگیرتر است — به تحلیل ما دربارهی مدلهای تخمین ریسک در صنعت ساختوساز مراجعه کنید.



گفتگو