
تصور کنید ساعت ۲ صبح است و شما تنها مهندسی هستید که میدانید چرا یک پردازش دستهای در دیتاسنتر متوقف شده، در حالی که تمام داشبوردها چراغ سبز نشان میدهند. این دقیقاً همان «منطقه خاکستری» است که ریک هولیهان با معرفی mneme قصد دارد آن را از حافظهٔ شخصی مهندسان به حافظهٔ ساختاری عاملهای هوش مصنوعی (AI Agents) منتقل کند. در مهندسی نرمافزار، گرانترین نوع شکست زمانی رخ میدهد که سیستم گزارش موفقیت میدهد، اما در واقع هیچ کاری انجام نداده است. هولیهان که سی سال تجربه در عرضه سیستمهای پیچیده دارد، mneme را به عنوان یک حلقه یادگیری طراحی کرده تا این «شکستهای موفقیتگونه» را شکار کرده و آنها را به داراییهای بادوام برای عاملهای هوش مصنوعی تبدیل کند.
بسیاری از پلاگینهای فعلی با تغذیه مدلها از دفترچههای راهنمای استاتیک و راهنمای توسعهدهندگان ساخته میشوند. این روش شبیه استخدام نیروی جدیدی است که تمام کتابها را خوانده اما هیچ تجربهای از «زخمهای» دنیای واقعی ندارد؛ یعنی باگهای مستند نشده، رفتارهای عجیب منطقهای و مسیرهای جایگزینی که فقط مهندسی که در نیمهشب بیدار شده تا سیستم را نجات دهد، از آنها خبر دارد. همانطور که در تحلیلهای قبلی ما دربارهی حافظهٔ بلندمدت مدلها اشاره کردیم، شکاف بین آنچه در مستندات آمده و آنچه در فشار کاری واقعی، در منطقه زمانی شما و با حجم دادههای شما رخ میدهد، جایی است که تیمهای مهندسی هفتهها بهرهوری خود را از دست میدهند. این اتکای بیش از حد به ابزارهای خودکار، گاهی منجر به چالشهای عمیقتری میشود؛ چنانکه در بررسی اثرات دستیارهای کدنویسی بر تفکر سیستمی اشاره کردیم، این ابزارها میتوانند توهمی از تسلط ایجاد کنند در حالی که درک بنیادین از سیستم در مهندسان تازهکار کاهش مییابد.
هزینه زوال سازمانی
هولیهان اشاره میکند که دانش سازمانی گرانترین دارایی است که شرکتها به دست میآورند، اما کمترین میزان حفظ را دارد. او الگویی تکرار شونده را در دوران مختلف مشاهده کرده است: مهندس ارشدی که میداند چرا یک پردازش دستهای در ساعت ۳ صبح اجرا میشود بازنشسته میشود، یا مشاری یک قطعی را حل میکند، هزینه تعمیر را میگیرد و دلیل اصلی مشکل را با خود میبرد.
دانش اغلب در صفحات ویکی میپوسد که آخرین بار در سال ۲۰۱۹ درست بودند. از آنجایی که ثبت این دانش مستلزم آن است که مهندس در میانه کار متوقف شود تا مستندات بنویسد — کاری که کمتر کسی برایش زمان دارد — این دانش با فرد میرود. هوش مصنوعی این وضعیت را بدتر کرده است، زیرا مدلها دفترچههای راهنما را حفظ هستند اما از «زخمهای» مهندس هیچ خبری ندارند. mneme ساخته شد تا عملِ «انجام کار» را به عملِ «بهبود خودکار پلاگین» تبدیل کند.
با تکیه بر این درک که دانش سازمانی معمولاً از در شرکت خارج میشود، هولیهان mneme را برای خودکارسازی ثبت این دانش توسعه داد. این سیستم صرفاً دادهها را ذخیره نمیکند، بلکه یک خط لوله حاکمیتی ایجاد میکند که یک جلسه کاری زنده را به یک بهروزرسانی مهارت دائمی برای عامل هوش مصنوعی تبدیل میکند. این امر تضمین میکند دانشی که کسب آن یک هفته زمان میبرد، برای تیم بعدی از بین نرود.
معماری حلقه یادگیری
به نقل از مستندات این پروژه در GitHub، mneme خلأ خاصی را در اکوسیستم فعلی هوش مصنوعی پر میکند. در ۱۱ اوت ۲۰۲۶، هولیهان بیش از ۴۰ سیستم را در چهار مسیر بررسی کرد: اکوسیستم Claude Code، زیرساختهای حافظه، ویژگیهای تجاری دانش تیمی و کارهای آکادمیک روی عاملهای خود-بهبودبخش. او دریافت که هر سیستم موجود تنها نیمی از حلقه لازم را دارد:
- دانش دستی/اشتراکی در گیت: ابزارهایی مانند Cursor Rules،
CLAUDE.md،AGENTS.mdو مهارتهای Amp اجازه اشتراک دانش از طریق Pull Requestها را میدهند، اما مستلزم آن هستند که همه چیز با دست نوشته شود. در این جوامع، دانش از طریق PRها به اشتراک گذاشته میشود، اما فرآیند کاملاً دستی است. - ثبت خودکار اختصاصی: سیستمهایی مانند Devin Knowledge، Augment Cosmos، Windsurf Memories، mem0، Zep و Letta دادهها را به طور خودکار ثبت میکنند، اما آنها را در پایگاههای داده اختصاصی ذخیره میکنند که کاربر مالک آنها نیست و اغلب فرآیندهای بازبینی ضعیفی دارند.
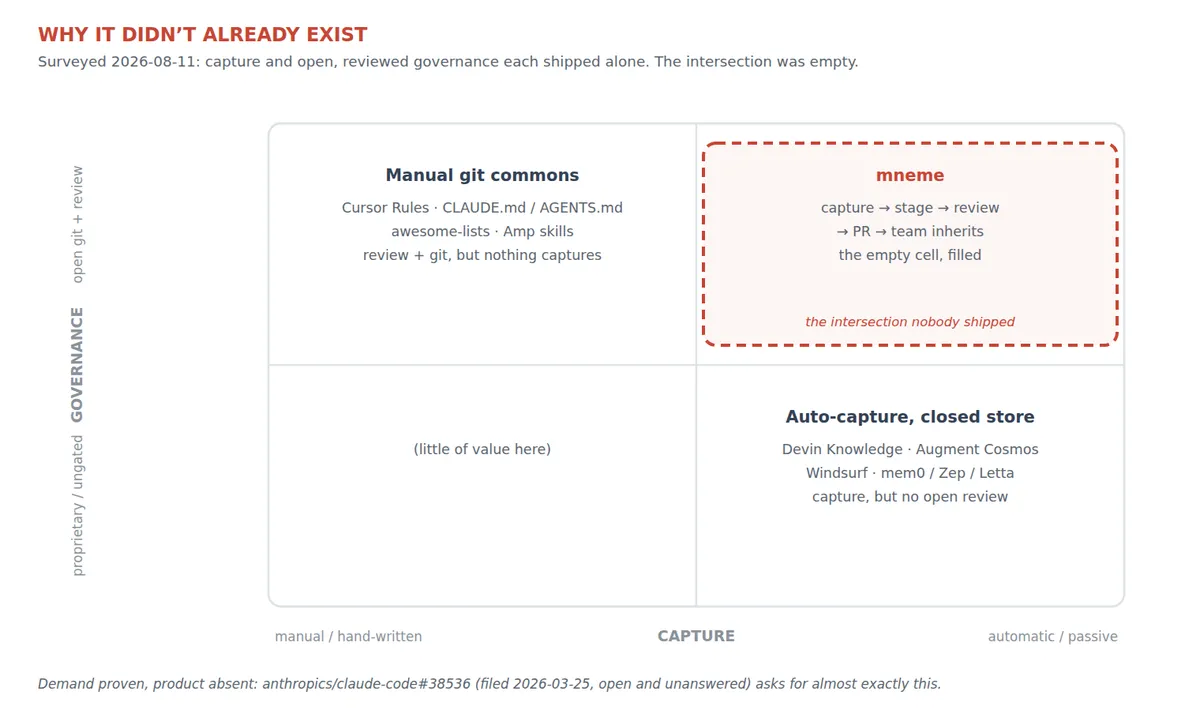
mneme نقطه تلاقی این دو است: ثبت غیرفعال حین کار $ \rightarrow $ مرحلهٔ آمادهسازی محلی $ \rightarrow $ بازبینی انسانی $ \rightarrow $ ارسال یک Pull Request به یک مخزن گیت باز $ \rightarrow $ ارثبری تیمی از طریق یک بهروزرسانی عادی پلاگین. این نیاز پیشتر در ۲۵ مارس ۲۰۲۶ در یک درخواست ویژگی برای Claude Code (در مسیر anthropics/claude-code#38536) مطرح شده بود.
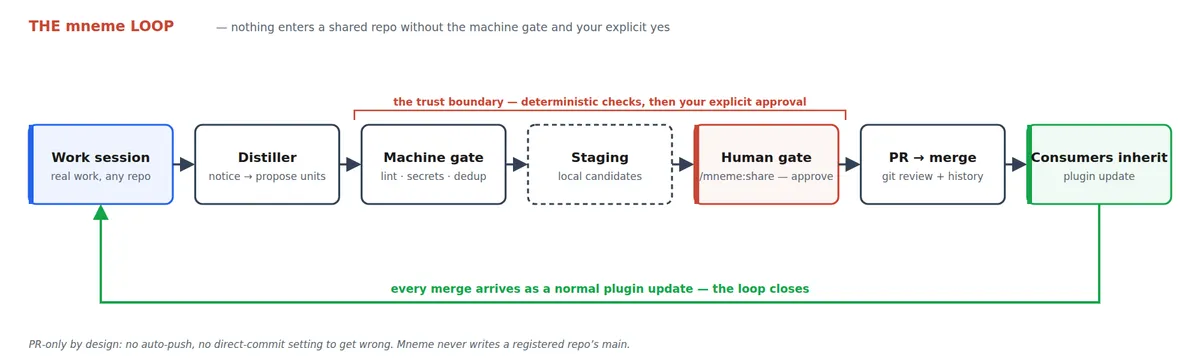
این چرخه از چهار دروازه عبور میکند:
- ثبت غیرفعال: یک تقطیرکننده در پسزمینه، یافتههای ارزشمند را حین جلسه شناسایی کرده و آنها را به صورت واحدهای کوچک و تایپشده پیشنهاد میدهد.
- دروازه ماشینی: یافتهها از بررسیهای قطعی برای Linting، اسکن اسرار (Secrets) و حذف موارد تکراری عبور میکنند. این کار تضمین میکند که ماشینها فرمت را تعیین کنند پیش از آنکه انسانها درباره محتوا قضاوت کنند.
- دروازه انسانی: یک فرد هر واحد تقطیر شده را یکی یکی بازبینی میکند تا تأیید کند ادعا واقعاً درست است. این کار از «فروپاشی زمینه» جلوگیری میکند؛ جایی که عاملها ممکن است ۱۸,۲۸۲ توکن را به ۱۲۲ توکن فشرده کنند و به سطحی پایینتر از خط پایه بدون حافظه سقوط کنند. راه حل، ویرایشهای دلتا-محور (فقط تغییرات) پشت یک دروازه ادغام انسانی است.
- توزیع: واحدهای تأییدشده از طریق PR به مخزن گیت اضافه میشوند. mneme به طور طراحی فقط PR-محور است؛ هرگز مستقیماً روی شاخه اصلی (main) یک مخزن ثبتشده نمینویسد و بدین ترتیب یک مرز اعتماد ایجاد میکند که برای تیمهای امنیتی حیاتی است. این روش از توزیع SHA-pinned و همگامسازی سازمانی به صورت رایگان بهره میبرد.
سختسازی موتور
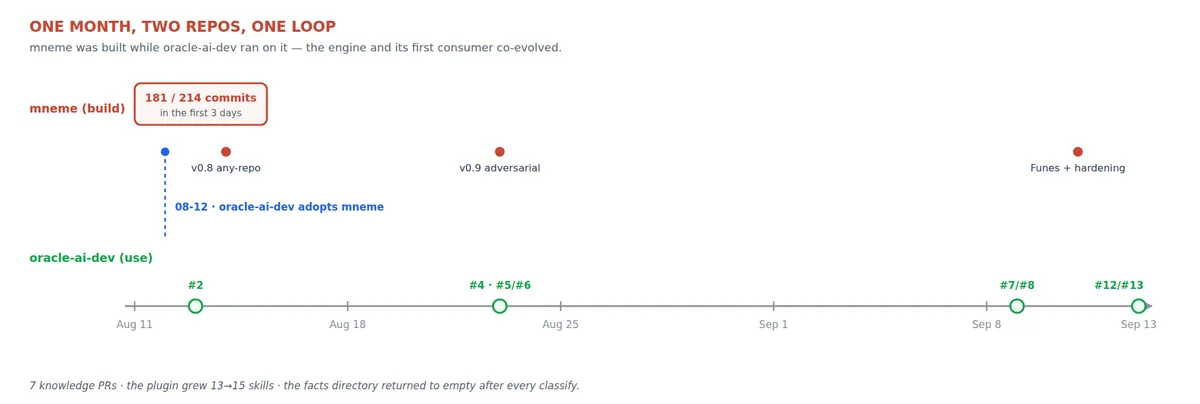
توسعهٔ خودِ mneme باعث شد هولیهان با همان مشکلی روبرو شود که قصد حلش را داشت. او متوجه شد ۱۸۱ کامیت از ۲۱۴ مورد در سه روز اول انجام شد، اما سه هفته بعد صرف بازبینی متخاصم (Adversarial Review) و سختسازی شد. او چندین «شکست موفقیتگونه» را در خودِ سیستم یافت:
- نگهبان خاموش: حفاظی برای جلوگیری از نشت دانش محدود به مخازن کمتر محدود طراحی و تست شده بود، اما حتی یک بار هم اجرا نشد چون خط لوله پسزمینه هرگز آرگومان لازم برای فعال کردن آن را ارسال نمیکرد.
- تأییدکننده کور: یک سازنده ایندکس و تأییدکننده آن، هر دو از فراخوانیای استفاده میکردند که برای دایرکتوریهای غیرقابل خواندن، مقدار خالی برمیگرداند. وقتی دایرکتوری حقایق (facts) غیرقابل خواندن شد، سازنده کور شد و تأییدکننده با او موافقت کرد. بازسازی گزارش موفقیت داد و بررسی با کد صفر خارج شد، در حالی که جستجو هیچ نتیجهای برنمیگرداند.
- باگ مودب: قانونی برای «احترام به ساختار موجود» هنگام افزودن دانش، قرار بود انتخابی برای «آسیب نرساندن» باشد. در عوض، به مکانیزمی تبدیل شد که یک ساختار قدیمی و غلط را دائمی کرد.
تأثیر واقعی روی oracle-ai-dev
برای تست واقعی، این ابزار در ۱۲ اوت ۲۰۲۶ روی oracle-ai-dev (مجموعهای از مهارتها برای Claude Code و Codex) پیاده شد. تا اواسط سپتامبر، این حلقه ۳۷ موضوع مجزا را در ۱۲ مهارت و ۱۷ فایل ثبت کرد.
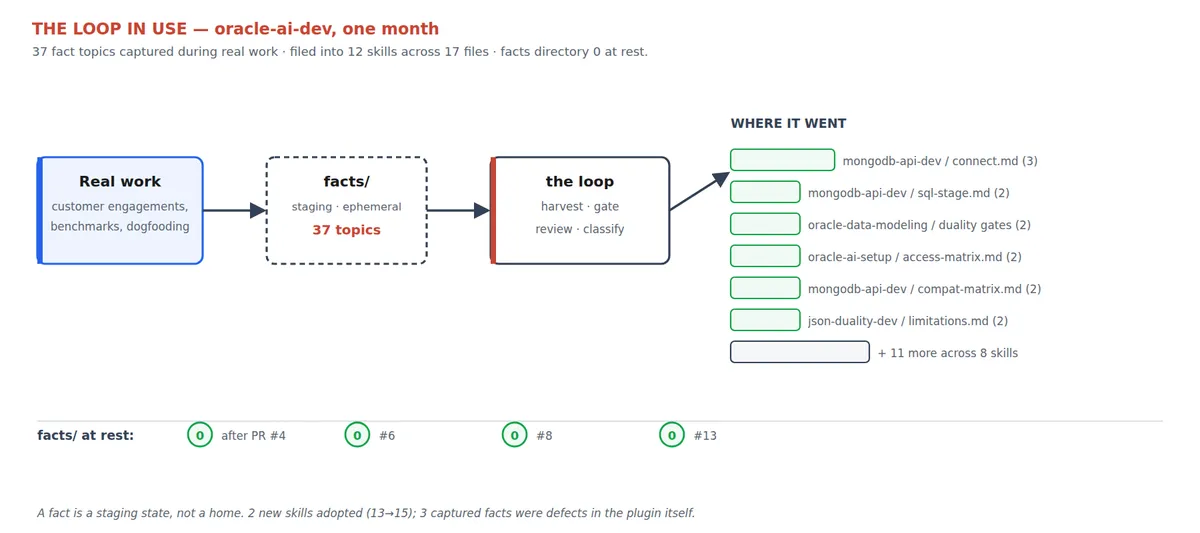
یکی از موفقیتهای طراحی این است که دایرکتوری حقایق در حالت استراحت خالی میماند. پس از PRهای شماره ۴، ۶، ۸ و ۱۳ تأیید شد که این دایرکتوری هر بار صفر فایل داشت، زیرا حقایق یک وضعیت آمادهسازی (staging) هستند. پس از تأیید، آنها مستقیماً به مهارت خاصی که متعلق به آن هستند هدایت میشوند تا پایگاه دانش به یک ایندکس غیرقابل خواندن و همیشه در حال رشد تبدیل نشود.
یک ثبت بسیار ارزشمند مربوط به یک اپلیکیشن جاوا بود که نمیتوانست به API اوراکل سازگار با MongoDB متصل شود. با وجود تنظیم tlsInsecure=true اتصال برقرار نمیشد. حلقه یادگیری یک یافته سخت و اندازهگیری شده را ثبت کرد: در درایور جاوا MongoDB، گزینه tlsInsecure فقط بررسی نام میزبان را تسهیل میکند و اعتمادسازی گواهینامه را تغییر نمیدهد. علاوه بر این، tlsAllowInvalidCertificates اصلاً یک گزینه جاوا نیست — بلکه فقط یک هشدار (WARN) ثبت میکند و نادیده گرفته میشود. این موضوع در سه نسخه درایور و دو نوع نقطه انتهایی (endpoint) تأیید شد.
سایر حقایق استخراج شده شامل باگهایی در خودِ پلاگین بود. برای مثال، اعتبارسنج نمای دوگانه پلاگین خطایی میداد که ادعا میکرد یک شکل شماتیک «نمیتواند谓 predicate پیوند متمایز را بیان کند»، در حالی که یک حقیقت استخراج شده ثابت کرد موتور دقیقاً همان شکل را میپذیرد. پایگاه دانش در واقع دارای ستون فقرات شد و شروع کرد به بحث کردن با میزبان خود.
اصطکاک و بازخورد
حتی با وجود این حلقه، اصطکاک وجود دارد. هولیهان مواردی را ذکر میکند که در آن یک فیلد تولید شده (ترکیبی از پیشوند محدوده و توضیحات) از حد ۵۰۰ کاراکتر پلتفرم فراتر رفت — به ۵۷۹ و سپس ۸۵۴ کاراکتر رسید — چون در مبدأ تولید محدود نشده بود. در مورد دیگر، یک اسکنر اسرار، یک نام فایل ۵۴ کاراکتری با خط تیره را به عنوان یک بلوک با آنتروپی بالا علامتگذاری کرد، در حالی که صرفاً یک نام توصیفی بود. چون اینها اکنون به عنوان حقیقت در پلاگین ثبت شدهاند، برای مهندس بعدی هیچ هزینهای نخواهند داشت.
سه جایگاه مشارکت
mneme سه نقش متمایز را در چرخه دانش میشناسد: سازنده (Builder)، مصرفکننده (پلاگین) و مشارکتکننده (عاملی که در حال انجام کاری نامرتبط است).
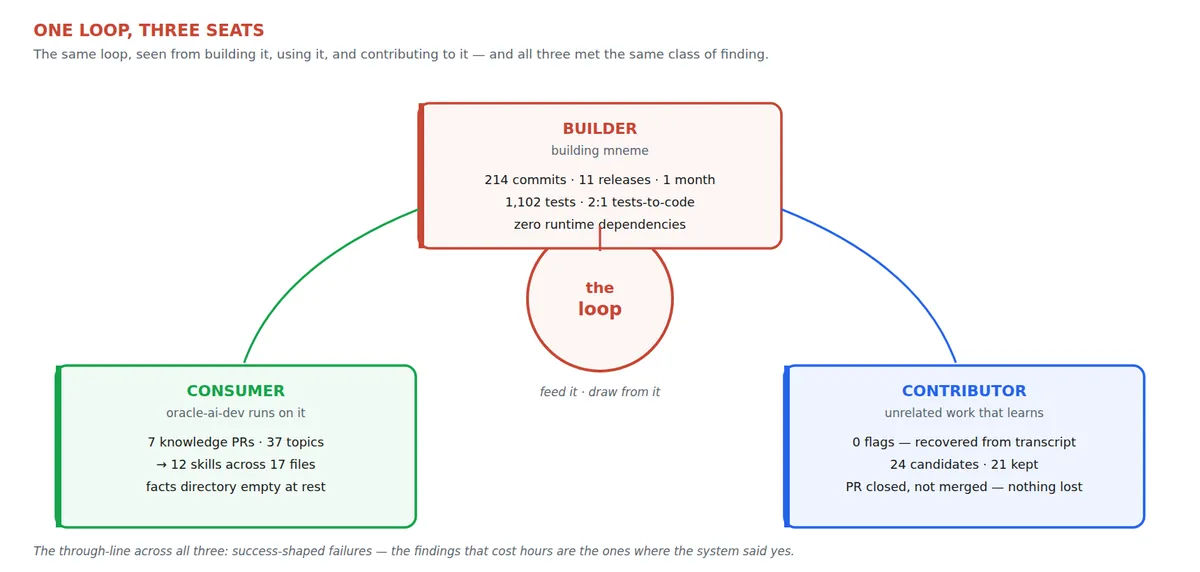
یک جلسه مربوط به بنچمارک تأخیر DynamoDB در AWS که بعدها به اوراکل منتقل شد، یک شکست بحرانی در ثبت غیرفعال را نشان داد. در طول ۱۲ ساعت کار که منجر به ۶ یافته مستند نشده شد، عامل حتی یک بار هم دستور «این را علامتگذاری کن» (flag this) را فراخوانی نکرد. این نشان داد که عاملها اغلب در شدیدترین بخشهای یک وظیفه، زمانی که توجه روی یافتن خطا (bisect) است و نه دانش، ثبت را فراموش میکنند.
راه حل، استخراج مستقیم از متن گفتگوها (Transcripts) بود. این روش بر علامتگذاری دستی برتری داشت زیرا متنها شامل بنبستها، دو فرضیه غلط و مقایسههای کنترل شده هستند.
این جلسه همچنین ثابت کرد که چرا دروازه انسانی را نمیتوان خودکار کرد. در حالی که دروازه ماشینی ۲۴ کاندید را عبور داد، یک بازبین انسانی دریافت که دو حقیقت کمتر از آنچه در عبارت آمده بودند: یکی ادعا میکرد فیلدی «هرگز پر نمیشود» در حالی که این نتیجه فقط بر اساس چهار عملیات بود، و دیگری ادعا میکرد «هیچ مسیر خواندن با سازگاری نهایی وجود ندارد» که بر اساس ورودی کاربر بود نه اندازهگیری.
علاوه بر این، بازبین دریافت که توصیفی که برای دقت زیاد نوشته شده بود، در واقع با چهارده مهارت دیگر برای پرامپتی که اصلاً نباید به آن پاسخ میداد، رقابت میکرد. این ثابت کرد که «تناسب» (fit) ویژگیِ مقصد است، نه ویژگیِ خودِ دانش.
خطر «شکستهای موفقیتگونه»
هولیهان الگویی تکرار شونده را شناسایی میکند که در آن سیستمها وضعیت 200 OK یا پیام موفقیت گزارش میدهند اما هیچ چیزی ایجاد نمیکنند. او حداقل ۱۵ مورد از این دست را در طول توسعه mneme و استفاده از پلاگین مستند کرده است:
- شکستهای زیرساختی: فراخوانی
CreateTableکه وضعیت 'CREATING' برمیگرداند اما هرگز جدول را نمیسازد؛ یک تگ ویژگی که باقی میماند اما هیچ چیزی را فعال نمیکند؛ یک منطقه امضا (signing region) که باید حتماًus-west-2باشد صرفنظر از مکان دیتابیس، در حالی که خطا به اشتباه اعتبارنامهها (credentials) را مقصر میداند. - شکستهای ابزاری: یک اسکریپت تخریب (teardown) که پیام «تخریب کامل شد» را ثبت میکند در حالی که یک Gateway و VCN را فعال نگه داشته است چون دستور شکستخورده به
/dev/nullهدایت شده بود؛ تستی که هیچ چیز را تأیید نمیکند چون رشته بررسی شده، زیرمجموعهای از یک پیام خطای نامرتبط است. - شکستهای منطقی: خواندن یک رجیستری که دو بار به صورت fail-open عمل کرد؛ مجموعهای از تستها که سبز میماندند در حالی که سقفهای اندازه به مقادیر شکستدهنده کاهش یافته بودند، چون تستها همان ثابتی را میخواندند که قرار بود آن را پین کنند.
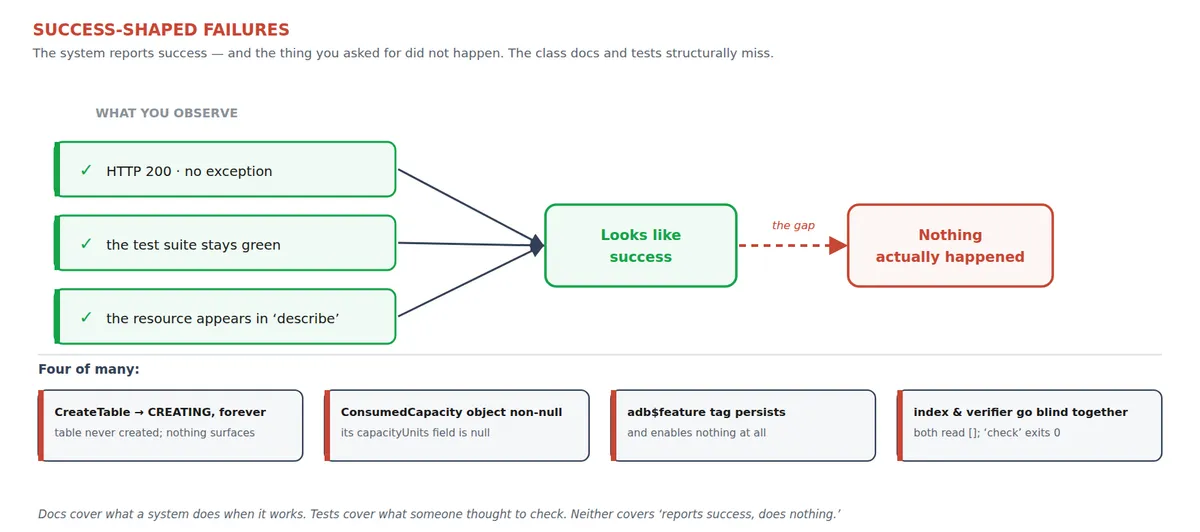
این شکستها از مستندات و تستهای CI جان سالم به در میبرند چون از بیرون شبیه موفقیت هستند. مستندات توصیف میکنند سیستم وقتی کار میکند چه میکند؛ تستها پوشش میدهند آنچه کسی فکر کرده بررسی کند. هیچکدام «گزارش موفقیت، انجام ندادن هیچ کاری» را پوشش نمیدهند. ارزش mneme در این است که هزینه ثبت این لحظات را به قدری ارزان کند که به جای تروماهای تکراری، به داراییهای بادوام تبدیل شوند.
تحلیل: تغییر پارادایم حافظه
برای جامعه مهندسی هوش مصنوعی، mneme تمرکز را از ذخیرهسازی به حاکمیت (Governance) منتقل میکند. صنعت تلاش زیادی روی پایگاههای داده برداری و پنجرههای زمینه بلند (long-context windows) کرده است، اما اینها اگر مدیریت نشوند، اساساً «لندفیل» یا محل دفن زباله هستند. با استفاده از گیت به عنوان لایه حاکمیتی، mneme از اعتماد سازمانی موجود، توزیع SHA-pinned و زیرساخت نسخهبندی بهره میبرد.
این رویکرد اذعان میکند که اگرچه LLMها ابزارهای فوقالعادهای هستند، اما اربابان بدی هستند. همانطور که Claude (شریک پیادهسازی) اشاره میکند، یک مدل میتواند با اطمینان کامل و بیهوده تصور کند کد درست است، در حالی که حفاظی مینویسد که هرگز اجرا نمیشود. تنها راه بستن این شکاف، نگه داشتن یک انسان در حلقه است که بتواند تفاوت بین یک چراغ سبز و یک سرویس در حال کار را تشخیص دهد.
اگر در حال ساخت حافظه برای عاملها هستید، سوال حیاتی دیگر این نیست که «چقدر میتوانیم ذخیره کنیم»، بلکه این است که «چگونه حقیقت یک ادعا را تأیید کنیم». آینده دانش پایدار هوش مصنوعی به طراحی تجربه بازبین بستگی دارد، نه فقط مکانیسم ثبت. برای بررسی پیادهسازی، مشخصات کامل طراحی و کد متنباز در github.com/rhoulihan/mneme در دسترس است.
گام بعدی شما
- اگر از Claude Code یا Cursor استفاده میکنید، ساختار
CLAUDE.mdرا برای ثبت «زخمهای» فنی تیمتان بازبینی کنید. - در زمان عیبیابی، هرگاه با وضعیتی روبرو شدید که سیستم «موفقیت» گزارش داد اما نتیجهای حاصل نشد، آن را به عنوان یک «شکست موفقیتگونه» مستند کنید.
- مخزن کد mneme را در گیتهاب بررسی کنید تا متوجه شوید چگونه میتوان گیت را به لایه حاکمیتی حافظه AI تبدیل کرد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو