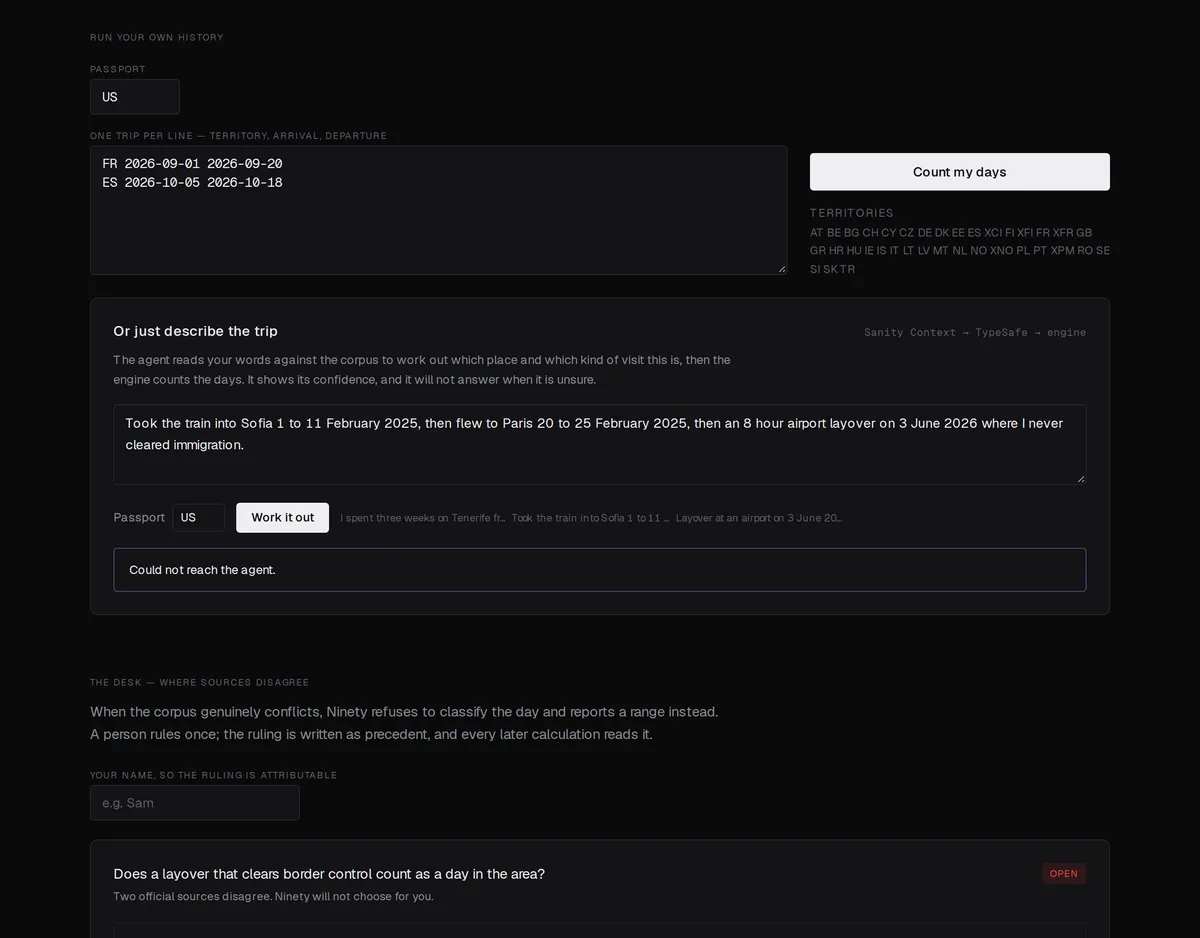
تصور کنید یک مسافر دربارهٔ برنامهای پیچیده سؤال کند: «سه هفته در تنریف بودم و سپس یک توقف ۸ ساعته در فرودگاه داشتم که هرگز از گمرک رد نشدم». در حالی که اکثر دستیارهای هوش مصنوعی با اعتمادبهنفس کامل تعداد روزهای باقیمانده را حدس میزنند، عامل سفر Ninety با یک تغییر معماری بنیادین، حق بیان هرگونه عدد را از هوش مصنوعی گرفت تا توهمات عددی را بهطور کامل ریشهکن کند. این سیستم تمام محاسبات را به یک موتور قطعی TypeScript واگذار کرده است.
این رویکرد در زمانی ارائه میشود که توسعهدهندگان با عدم اطمینان ذاتی مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — در منطقهای حساس دستوپنجه نرم میکنند. همانطور که در تحلیل قبلی ما دربارهی استفاده از Sanity Context MCP برای جلوگیری از تقلب در بورسیههای تحصیلی اشاره کردیم، Ninety نیز اصل مبنیسازی (Grounding) عاملها را در دادههای ساختاریافته و فقط-خواندنی، بهجای تکیه بر وزنهای داخلی مدل، پیاده کرده است. این تلاش برای دستیابی به دقت مطلق، یادآور رویکرد AERO-KIT در حذف توهمات از طریق پیمایش گراف است که نشان داد ساختارهای دادهای سختگیرانه چگونه میتوانند خطاهای مدل را به صفر برسانند.
در این سیستم، مدل زبانی دیگر یک ماشینحساب نیست، بلکه صرفاً به عنوان یک طبقهبندیکننده و بازیاب عمل میکند. برای مثال، Ninety اقامت در تنریف را با اطمینان ۹۰٪ به جزیرات کاناری (که یک منطقه استثنا یا carve-out است و روزهای آن شمرده نمیشود) و توقف فرودگاهی را با اطمینان ۱۰۰٪ به عنوان ترانزیت فرودگاهی (که روزهای آن شمرده نمیشود) شناسایی میکند. اگر متنی مثل «پرواز به پاریس از ۲۰ تا ۲۵ فوریه» ظاهر شود، عامل بهجای حدس زدن، آن را به عنوان یک قطعه ناقص (fragment) گزارش میدهد.
معماری قطعیت
به نقل از مستندات فنی Ninety، این سیستم از یک خط لوله سختگیرانه برای جداسازی درک زبانی از اجرای منطقی استفاده میکند. این فرآیند از مراحل زیر پیروی میکند:
- استخراج تاریخ: کلمات کاربر توسط کدهای تستشده و قطعی (Deterministic) به اقامتهای تاریخدار تبدیل میشوند. این لایه تضمین میکند «۱ تا ۲۱ فوریه ۲۰۲۶» یک اقامت واحد باشد، نه دو مورد مجزا، و تاریخهای ناممکن مثل «۳۰ تا ۳۱ فوریه ۲۰۲۶» بهجای اینکه به مارس منتقل شوند، بهطور کلی رد شوند.
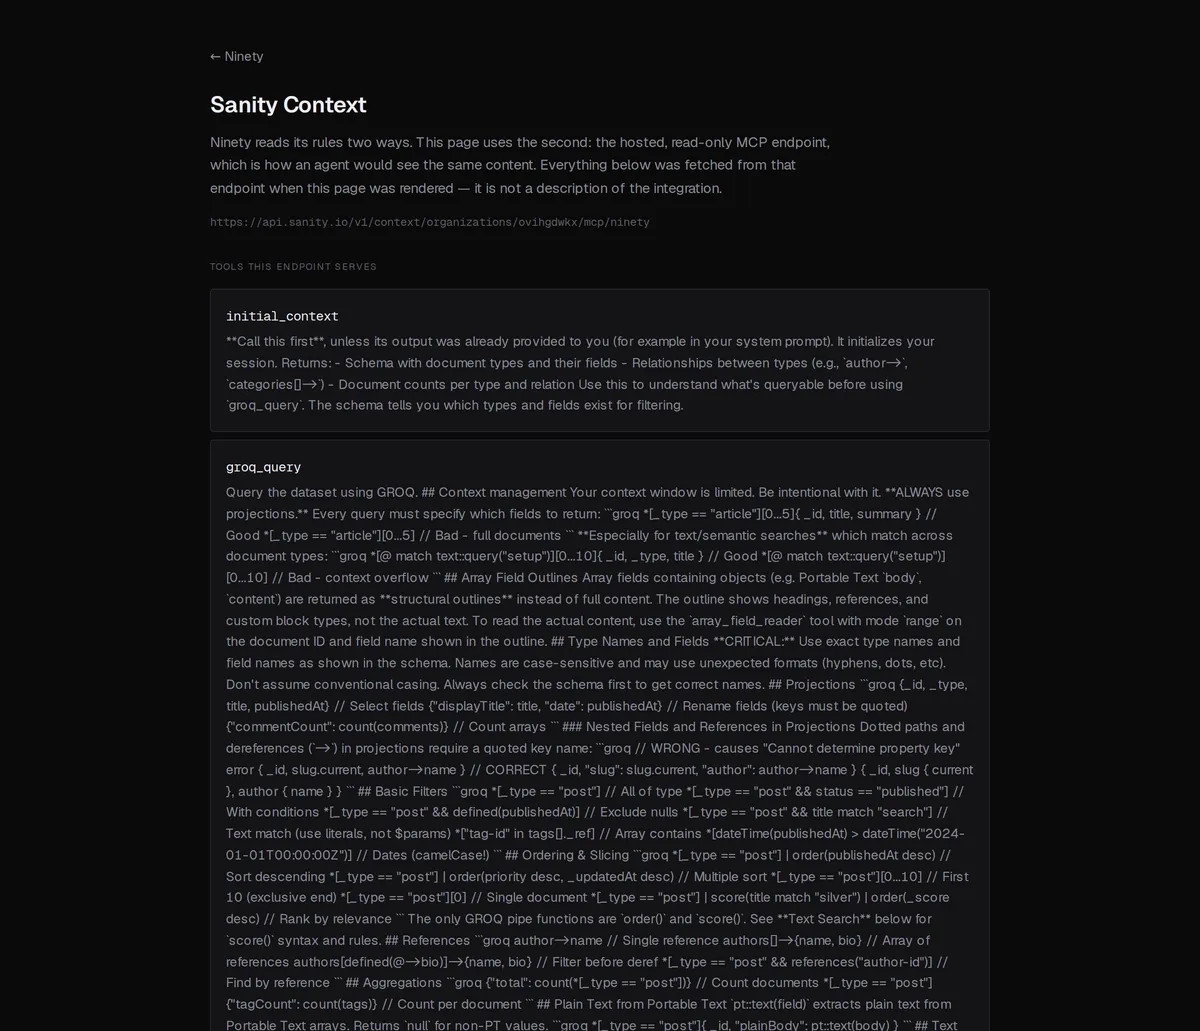
- زمینه Sanity (MCP): عامل از یک نقطه انتهایی میزبانیشده MCP برای بازیابی مجموعهای از قوانین کاندید از طریق پرسوجوهای GROQ استفاده میکند. این یک نقطه انتهایی فقط-خواندنی است، نه یک پرامپت سختافزاری یا ایندکس برداری که در زمان استقرار (deploy) ساخته شده باشد.
- سیستم یک TypeSafe: مدل اقامت را با استفاده از توابع نوعبندیشده (Typed Primitives) و امتیازات اطمینان کالیبره شده طبقهبندی میکند. خروجی مدل شامل یک مقدار از یک مجموعه تعریفشده به همراه توزیع احتمالی کامل است.
- موتور محاسباتی: یک موتور خالص TypeScript — بدون مدل، بدون شبکه و بدون متغیرهای محیطی — عدد نهایی را بر اساس قوانین بازیابیشده محاسبه میکند. امضای این موتور به صورت
evaluate(snapshot, itinerary, {asOf})است که تعداد روزهای استفاده شده، تاریخهای انتساب و روزهای حلنشده را برمیگرداند.
حذف رفلکس «حدس زدن»
توسعهدهنده با حذف توانایی مدل در تولید متن برای اعداد، سه حفاظ امنیتی بحرانی ایجاد کرده است. اول، عامل نمیتواند مکانی را اختراع کند. لیست مناطق در لحظه درخواست از مجموعه داده (Corpus) بازیابی میشود. اگر مکانی در لیست نباشد، هیچ گزینهای برای انتخاب وجود ندارد و خروجی «مکانی با این نام یافت نشد» خواهد بود. سیستم هرگز نزدیکترین تطابق را حدس نمیزند.
دوم، سیستم بهطور فیزیکی قادر به انجام محاسبات ریاضی نیست. چون طبقهبندی از طریق مدلهای TypeSafe System One انجام میشود، هیچ کانال تولید متنی برای انتقال اعداد وجود ندارد. کل اپلیکیشن وب تنها با پنج وابستگی زمان اجرا (runtime dependencies) کار میکند و از هیچ SDK ارائهدهنده مدلی استفاده نمیکند.
سوم، عامل برنامهریزی شده تا نادانی خود را بپذیرد. اگر امتیاز اطمینان برای یک طبقهبندی به زیر ۰.۶۲ برسد، سیستم بهجای ارائه یک حدس، گزارش میدهد که خوانش مورد نظر نامطمئن (uncertain) است. این نوع کنترل دقیق بر خروجیهای مدل، مشابه سیستم لایه نظارتی در Claude Code است که برای مدیریت عملیاتهای خودمختار و جلوگیری از رفتارهای پیشبینینشده طراحی شده است.
مکانیسم موتور محاسباتی
یک باگ خاص، ضرورت این جداسازی را برجسته کرد: یک بار طبقهبندیکننده پاسخ داد که فرد در جایی حضور ندارد که باید شمرده شود، زیرا نمیدانست گذرگاههای زمینی بلغارستان در فوریه ۲۰۲۵ داخلی بودهاند. در نتیجه برای یک سفر با قطار به صوفیه پاسخ «خیر» داد. اما موتور محاسباتی — که قوانین را بهدرستی میشناسد — ۱۰ روز را محاسبه کرد. بهجای نمایش دو برچسب متناقض، عدد «N روز شمرده شد» مستقیماً از دفتر کل (ledger) که توسط موتور تولید شده است، خوانده میشود. طبقهبندیکننده هرگز اجازه ندارد درباره محاسبه یا شارژ روزها نظر بدهد.
محتوای ساختاریافته در برابر جستوجوی کلیدواژهای
برای اثبات ارزش این ساختار، توسعهدهنده آزمونی را روی ۲۳ تاریخچه سفر خصمانه (adversarial) با انتظاراتی که بهصورت دستی محاسبه شده بود، اجرا کرد. در این تست، هیچکدام از دو بازو از مدل زبانی استفاده نکردند تا اثر ساختار محتوا بهطور مجزا بررسی شود. نتایج شکاف عظیمی را بین بازیابی ساختاریافته و جستوجوی سنتی نشان داد:
- ساختاریافته (GROQ + موتور): ۲۳ پاسخ صحیح از ۲۳ مورد و تولید شمارش روز در ۲۱ مورد از ۲۳ مورد.
- جستوجوی کلیدواژهای (BM25): تنها ۱ پاسخ صحیح از ۲۳ مورد و صفر مورد شمارش روز.
- دقت (Precision): سیستم ساختاریافته در تنها مورد تخلف، تاریخ دقیق را نام برد و در ۲ مورد مناسب، از حدس زدن خودداری کرد.
این تفاوت به این دلیل است که قانونی بودن سفر یک مسئله بازیابی (Retrieval) نیست، بلکه یک مسئله «اتصال» (Join) است. در بازوی جستوجوی کلیدواژهای، همان سوابق مناطق و قوانین حضور بهصورت متنی ساده (flattened prose) ارائه شد. سیستم مکرراً پاراگراف درست را پیدا میکرد، اما نمیتوانست حکمی صادر کند. سؤالی مانند «من ۱۱ سفر در سال جاری ثبت کردهام و یکی هم رزرو شده است؛ آیا هنوز وضعیت قانونی دارم؟» نیازمند اتصال قوانین به ۱۱ بازه تاریخی است که برخی در مناطق استثنا هستند و باید روز به روز در یک پنجره زمانی غلتان ارزیابی شوند. بازیابی فقط پاراگرافها را مییابد؛ اما نمیتواند آنها را به یک تقویم متصل کند. برای درک بهتر اینکه چرا بنچمارکهای سنتی در شناسایی این نوع خطاهای منطقی ناتوان هستند، متدولوژی جدید سنجش کیفیت مدلها را بررسی کنید که بر روی شناسایی واقعی توهمات در محیطهای عملیاتی تمرکز دارد.
نقش Sanity Context
Ninety از Sanity Context به عنوان یک نقطه انتهایی MCP فقط-خواندنی استفاده میکند که شمای مجموعه داده را ارائه داده و به پرسوجوهای GROQ در لحظه پاسخ میدهد. عامل از ابزارهای خاصی برای نیازهای مختلف استفاده میکند:
initial_context: ارائه نمای کلی از شما شامل انواع (types)، فیلدها، روابط و تعداد اسناد.groq_query: انجام بازیابی ساختاریافته با استفاده از Projectionها برای ایجاد مجموعه کاندیداها برای هر درخواست.schema_explorer: ارائه جزئیات در سطح فیلد زمانی که نمای کلی کافی نباشد.array_field_reader: اجازه خواندنaccessBands[]وcompetingClaims[]بدون وارد کردن کل اسناد به پنجره متنی (Context Window) — مثل میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه.
اهمیت شکل دادهها
کیفیت یک عامل توسط ساختاری که میتواند از آن پرسوجو کند، محدود میشود. Ninety چهار تصمیم دادهای کلیدی گرفته است:
۱. آرایههای باند تاریخ: عضویت بهجای یک مقدار بله/خیر (boolean)، به صورت آرایهای از باندها ذخیره شده است. یک مقدار ساده مثل isSchengen: true برای هر کشوری که دیرتر پیوسته است، یک دروغ است؛ به همین دلیل اکثر دستیاران در مورد کرواسی و بلغارستان اشتباه میکنند. accessBands[] (شامل from ،to ،counted و modes) امکان پاسخ به این سؤال را فراهم میکند که آیا فرد در یک روز خاص از طریق یک مسیر خاص در یک منطقه بوده است یا خیر.
۲. مناطق به عنوان استثنائات: جزایر کاناری، مادیرا، اولاند، اسوالبارد، دپارتمانهای دوردست فرانسه، ایرلند، قبرس و ایسلند هر کدام اسناد منطقهای مستقل با باندهای خاص خود هستند. این اجازه میدهد عامل دقیقاً مشخص کند یک روز در کجا سپری شده است.
۳. ابهام به عنوان یک مقدار: یک presenceRule میتواند «شمردهشده» (counted)، «نشمردهشده» (not_counted) یا «مورد اختلاف» (disputed) باشد. در صورت اختلاف، موتور از طبقهبندی روز خودداری میکند و عامل باید هر دو خوانش را ارائه داده و دلیل اختلاف را نام ببرد.
۴. استنادات قابل بررسی: هر باند و قانون دارای sourceRef[] به یک سند واقعی با ناشر، URL و تاریخ بازیابی است. استنادات بهجای اینکه «محتمل» باشند، «قابل بررسی» هستند.
درسهای استقرار
توسعهدهنده اشاره کرد که برخی باگهای بحرانی در مسیر اصلاح شدند. یکی از مسائل اصلی مربوط به دستهبندی طبقهبندیها (batching) بود؛ عامل یک توقف فرودگاهی را جزایر کاناری تشخیص داد صرفاً چون اقامت قبلی در آن دسته، تنریف بود. این مشکل با تغییر استراتژی به «یک درخواست برای هر اقامت» حل شد.
سایر چالشهای فنی عبارت بودند از:
- استقرار استودیو: نقطه انتهایی Context در ابتدا با خطای «فقط مجموعهدادههایی با اپلیکیشنهای استودیوی مستقر پشتیبانی میشوند» مواجه شد که با استقرار استودیو در یک دستور حل شد.
- شکستهای Regex: در Template Literalها، کاراکتر
\sبهsتبدیل میشد و باعث میشد Regexهای حذف تاریخ هیچچیز را پیدا نکنند و تاریخهای خام به طبقهبندیکننده ارسال شوند. - اعتبارسنجی دادهها: کد منطقهای جزایر کاناری بهاشتباه به صورت
es-canary(کلید سند) بهجایXCIنوشته شده بود. چون موتور برای مناطق ناشناخته بهطور پیشفرض صفر روز محاسبه میکند، این مورد به دلیل اشتباه، پاس شد. برای حل این موضوع، دستورpnpm check:codesاضافه شد تا در صورت افتادن هر اقامت، بیلد (Build) شکست بخورد. - خطاهای حقیقت مرجع: ایسلند در ابتدا بهجای EEA به عنوان شینگن علامتگذاری شده بود، زیرا یک تابع کمکی تاریخ تأسیس را روی تمام ایالتها مهر میزد.
تحلیل: تغییر به سمت عاملهای قطعی
Ninety نشاندهنده تغییری در طراحی عاملها از «مهندسی پرامپت» به «محدودیت معماری» است. با تبدیل LLM به یک سوئیچ با ابعاد بالا بهجای یک موتور استدلال، توسعهدهنده سیستمی ساخته است که اعتماد به آن ایمن است، زیرا بهطور فیزیکی قادر به دروغ گفتن درباره اعداد نیست.
یک شکاف باقیمانده، جذب متون توصیفی (prose) است. در حال حاضر، اسناد راهنمای اتحادیه اروپا به عنوان منبع ذکر میشوند اما به عنوان متن قابل جستوجو جذب نشدهاند. تبدیل اینها به یک پایگاه دانش (Knowledge Base) به عامل اجازه میدهد پاراگرافهای خاصی را نقل کند تا توضیح دهد چرا یک روز مورد اختلاف است، بهجای اینکه فقط به دو عنوان اشاره کند.
برای توسعهدهندگان، این بدان معناست که آینده عاملهای قابل اعتماد، مدلهای بزرگتر نیست، بلکه دادههای ساختاریافتهتر است. وقتی هزینه یک اشتباه بالا باشد — مانند وضعیت قانونی ویزا — تنها معماری قابل قبول، معماریای است که در آن مدل از عمل محاسبه منع شده باشد.
برای مشاهده این سیستم در عمل، میتوانید اپلیکیشن زنده و صفحه شواهد (evidence page) را بررسی کنید که پاسخهای خام JSON-RPC دریافتی توسط عامل را چاپ میکند تا تشخیصها نشان دهند عامل واقعاً چه چیزی دریافت کرده است، نه آنچه یک کتابخانه ترجیح میدهد نشان دهد.
گام بعدی شما
- اگر در حال ساخت عاملهایی هستید که با اعداد سر و کار دارند، منطق محاسباتی را از مدل زبانی جدا کرده و به یک موتور قطعی (Deterministic) منتقل کنید.
- برای کاهش توهمات، بهجای پرامپتهای طولانی، از دادههای ساختاریافته و پروتکلهایی مثل MCP برای بازیابی دقیق قوانین استفاده کنید.
- سیستمهای خود را با «دادههای مرجع» (Ground Truth) و سناریوهای خصمانه تست کنید تا نقاط کور مدل در طبقهبندی را بیابید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو