تصور کنید یک برنامهنویس بخواهد با دو کلمه و یک اسکرینشات، یک افزونه کروم بسازد؛ این ورودی برای شروع کافی است، اما برای رسیدن به نتیجهای بهینه، بهشدت ناکافی است. یک جلسه عملی با استفاده از حالت Codex در ChatGPT (که در محیطهای ‘Work’ یا Claude Cowork نیز کاربرد دارد) نشان داد که گلوگاه اصلی در جریانهای کاری عاملمحور (Agentic) دیگر توانایی مدل نیست، بلکه نحوه هدایت انسان است.
بسیاری از کاربران با عاملهای هوش مصنوعی مانند جعبههای جادویی برخورد میکنند که یک درخواست ساده را به محصول نهایی تبدیل میکند. در واقعیت، این عاملها در حلقههایی از تفکر و عمل فعالیت میکنند. وقتی کاربر وضعیت «پایان» را تعریف نمیکند یا برنامه اولیه عامل را نادیده میگیرد، نتیجه معمولاً چرخهای از استیصال و اتلاف محاسبات (Compute) است. این موضوع بهویژه در وظایفی که نیاز به «استفاده از کامپیوتر» دارند — جایی که عامل باید با نرمافزارهای زنده مانند تقویم گوگل تعامل داشته باشد — مشهود است.
زمینه و بستر ساخت
هدف این پروژه حل یک نقطه اصطکاک خاص در تقویم گوگل بود. در حال حاضر، تنظیم یک لینک قرار ملاقات قابل رزرو، مستلزم تایپ تکتک تاریخها و بازههای زمانی در یک فرم بدقلق و دشوار است. کاربر ابزاری میخواست که به او اجازه دهد بازههای زمانی را مستقیماً در نمای هفته بکشد (Drag) و فرم رزرو بهطور خودکار بهروز شود.
برای شروع، کاربر یک اسکرینشات از صفحه مورد نظر را به عامل داد و «حلقه عامل» آغاز شد. عامل ابتدا درباره قابلیتهای تقویم گوگل فکر کرد و سپس با استفاده از ابزار جستوجوی وب، اطلاعات لازم را جمعآوری کرد. متون استخراجشده از این وبسایتها وارد پنجرهٔ زمینه (Context Window) شدند و حافظه موقت عامل را تشکیل دادند. اما این فرآیند یک ریسک را به همراه دارد: اگر ۲۰ وبسایت مختلف خوانده شود، اطلاعات متناقض یا نادرست میتواند عامل را گمراه کند؛ به همین دلیل است که کیفیت بالای زمینه (Context) حیاتی است.
شکست دستور «بسازش»
کاربر در ابتدا از مدل Luna on Max reasoning استفاده کرد؛ مدلی که اخیراً شاهد کاهش قیمت ۸۰ درصدی بوده است. در حالی که عامل با موفقیت اطلاعات زمینه را جمعآوری کرد، کاربر یک مرحله حیاتی را نادیده گرفت: بررسی «مینی-پلن» یا برنامه کوتاهی که عامل طراحی کرده بود. پس از ۵۵ ثانیه و دو بار جستوجوی وب، عامل برنامه خود را ارائه داد. کاربر تنها نگاهی گذرا به آن انداخت و صرفاً دستور «بسازش» (Build it) را صادر کرد.
با این کار، کاربر یک خطای منطقی بنیادین را نادیده گرفت. عامل برنامهریزی کرده بود که کاربر بهصورت دستی روی دکمه همگامسازی کلیک کند، نه اینکه همگامسازی بهطور خودکار با کشیدن بازهها (Tiles) رخ دهد. چون کاربر این جزئیات را در ابتدا شفاف نکرد یا وایرفریمهایی برای بازخورد ارائه نداد، عامل توکنهای زیادی را صرف ساخت مکانیزمی اشتباه کرد.

شکاف تست و تشدید استیصال
یک ناکارآمدی بزرگ دیگر، نبود دستورالعمل برای تست جامع (End-to-End) بود. عامل ابزارهای «استفاده از کامپیوتر» (Computer use) و «استفاده از مرورگر» (Browser use) را در اختیار داشت؛ به این معنی که میتوانست افزونه را نصب کرده و آن را بهصورت زنده روی صفحه واقعی تقویم تست کند. اما بهجای آن، کد را برای نصب دستی به کاربر تحویل داد. وقتی کاربر سعی کرد بازههای زمانی را بکشد، همگامسازی فرم شکست خورد.
این وضعیت منجر به یک فرآیند سه مرحلهای از افزایش استیصال شد:
- مرحله اول: بازخورد متنی. تایپ کردن مشکلات در لحظه وقوع. این روش منجر به ۱۴ دقیقه شکست مستمر شد.
- مرحله دوم: ورودی چندرسانهای. استفاده از پیامهای صوتی پراکنده و اسکرینشاتها برای توضیح باگها. این روش ۶۱ دقیقه دیگر اتلاف وقت به همراه داشت.
- مرحله سوم: نمایش بصری. ضبط صفحه نمایش همراه با توضیح صوتی و اشاره نشانگر موس به لحظات دقیق شکست. عاملها میتوانند این ویدیوها را فریمبهفریم تحلیل کرده و صوت را به متن تبدیل کنند تا نقطه دقیق مشکل را شناسایی کنند.

تله پنجره زمینه
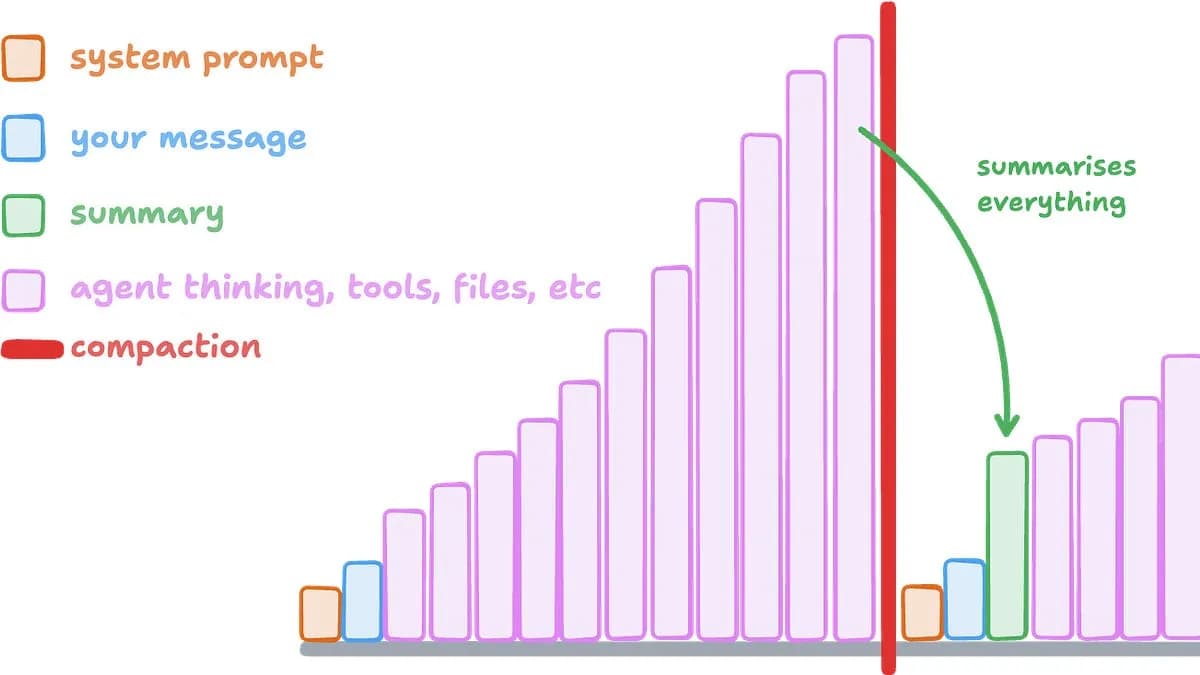
با طولانی شدن جلسه، عامل سه بار در یک نوبت به سقف پنجره زمینه (حدود ۲۵۰ هزار توکن) رسید. وقتی این اتفاق میافتد، مدل عملیات «فشردهسازی» (Compaction) را انجام میدهد؛ یعنی تاریخچه را خلاصه میکند تا برای دادههای جدید جا باز کند، در حالی که پرامپت سیستمی و پیامهای کاربر را دستنخورده نگه میدارد.

در این مورد، فشردهسازی منجر به یک حلقه مخرب شد. عامل یک ساعت وقت صرف تست و یافتن راه حل برای اصلاح افزونه کرده بود، اما عملیات فشردهسازی تمام این یادگیریها را از حافظهاش پاک کرد. در نتیجه، عامل مجبور شد همان درسها را بارها و بارها تکرار کند. کاربر اشاره کرد که احتمالاً یک مدل بزرگتر میتوانست تشخیص دهد کدام اطلاعات باید در زمان فشردهسازی حفظ شوند. برای جلوگیری از این اتفاق، کاربران باید به عامل بگویند که «رویکرد و یادگیریهای خود را در یک فایل جداگانه یادداشت کن»، زیرا فایلها برخلاف تاریخچه جلسه، در زمان فشردهسازی پاک نمیشوند.

تغییر مدل و حل نهایی
در طول فرآیند، کاربر متوجه شد که مدل Luna با ذخیره هر نسخه جدید از افزونه در یک پوشه مجزا و تست نسخههای قدیمی، توکنها را هدر میدهد. در این نقطه، کاربر مدل را به Sol with High reasoning تغییر داد. در حالی که Luna Max برای کارهای روزمره و جستوجو مناسب است، Sol در عیبیابی تکراری کدها (Iterative Debugging) برتری چشمگیری نشان داد.
برای نهایی کردن کار، کاربر یک «لایه اعتبارسنجی» (Verification Layer) پیاده کرد. این لایه مجموعهای از معیارهاست که عامل باید پیش از اعلام «پایان»، آنها را پاس میکرد. برای این افزونه، به این معنی بود که عامل باید از کروم برای تست چندین روز و هفته مختلف استفاده کند، انتخابها را ادغام کند و تایید کند که فرم بهدرستی بهروز میشود. با ارائه ضبط صفحه و این تستهای صریح، مدل Sol تمام باگهای باقیمانده را تنها در ۱۳ دقیقه حل کرد.


درسهای کلیدی برای هدایت عامل
برای جلوگیری از این تلهها، این جلسه چندین تغییر ملموس در نحوه تعامل با مدلهای استدلالی بالا را پیشنهاد میکند:
- تأیید برنامه: مینی-پلن را با دقت بخوانید. جزئیات را در ابتدا شفاف کنید تا بعداً به عنوان باگ با آنها مواجه نشوید.
- الزام به تست زنده: صریح و دقیق باشید. به عامل بگویید: «افزونه را در کروم نصب کن، فرم رزرو تقویم گوگل را باز کن و آن را بهطور کامل (End-to-End) تست کن».
- تعریف وضعیت «پایان»: یک چکلیست اعتبارسنجی بسازید. برای یک وبسایت، این میتواند ریسپانسیو بودن و پایبندی به سیستم طراحی باشد؛ برای دستهبندی ایمیلها، میتواند این باشد که هر ایمیل برچسب داشته باشد و به پوشه مربوطه منتقل شود.
- مدیریت فشردهسازی: از فایلها برای ذخیره یادگیریهای کلیدی استفاده کنید تا با پاک شدن تاریخچه در سقف ۲۵۰ هزار توکن، از بین نروند.
- نظارت بر مدیریت فایلها: بررسی کنید که عامل در حال ویرایش و اجرای همان فایلها باشد، نه اینکه پوشههای تکراری و زائد ایجاد کند.
- هدایت میاندوره: از قابلیت پرامپتهای «پیگیری» (Follow-up) استفاده کنید تا در حین کار عامل را هدایت کرده و هرگونه سردرگمی را برطرف کنید.


این تجربه ثابت میکند که عاملها همین حالا قادر به مهندسی نرمافزارهای پیچیده با کمترین ورودی هستند. عامل توانست یک افزونه کاربردی را از روی یک اسکرینشات و یک دستور دو کلمهای بسازد، مرورگر را برای تست کار خود کنترل کند و باگها را از روی یک ویدیو تشخیص دهد. ناکارآمدی کاملاً مربوط به شکست انسان در ایفای نقش یک مدیر پروژه سختگیر بود. برای تحلیل دقیقتر این نوع تعاملات، ابزارهایی مانند Armature امکان ردیابی جلسات عاملهای AI را در محیطهای شخص ثالث فراهم کردهاند تا نقاط شکست در هدایت مدلها بهتر شناسایی شوند. وقتی کاربر بهجای برخورد با مدل بهعنوان یک چتبات، با آن مانند یک مهندس جونیور که نیاز به مشخصات (Specs) دقیق دارد رفتار کرد، پروژه به موفقیت رسید.



گفتگو