
تصور کنید سرعت پردازش پرسوجوهای دیتابیس شما ناگهان صدها برابر بیشتر شود، بدون آنکه حتی یک خط کد را بهصورت دستی بازنویسی کرده باشید. این اتفاق برای PostHog رخ داده است: جایگزینی یک سیستم قدیمی و کند با کدی که توسط هوش مصنوعی تولید شده و در محیط عملیاتی تا ۴۵۴ برابر سریعتر عمل میکند. در حالی که تولیدکنندگان تجزیهکننده (Parser Generators) سنتی برای مدتها استاندارد صنعت بودهاند، PostHog به سمت کدهای «دستنویس» سنتز شده توسط هوش مصنوعی تغییر مسیر داده است تا سرعت اجرای خام را در اولویت قرار دهد. نتیجه این تغییر، یک تجزیهکننده SQL سفارشی است که توسط Claude نوشته شده و اکنون پرسوجوها را با سرعتی خیرهکننده پردازش میکند.
برای سالها، توسعهدهندگان برای ساخت تجزیهکنندهها به ابزارهایی مثل ANTLR تکیه میکردند. این ابزارها به مهندسان اجازه میدهند تا دستور زبان یا گرامر را بهصورت اعلامی (Declarative) در یک فایل با پسوند .g4 تعریف کنند و پیادهسازی عملیاتی را به ماشین بسپارند. اما این انتزاع، یک «مالیات عملکرد» ایجاد میکند؛ زیرا کد خروجی بهجای مجموعهای از توابع بهینه و مستقیم، مانند یک مفسر عمومی عمل میکند که روی یک گراف حرکت میکند. بهطور مشخص، ANTLR گرامرها را به یک ATN (که در واقع یک NFA با یک پشته است) کامپایل میکند و در زمان اجرا از یک مفسر عمومی برای پیمایش این گراف استفاده میکند. همچنین این ابزار از Lookahead دینامیک و دلخواه پشتیبانی میکند، به این معنی که باید هر تفسیر ممکن را بهصورت همزمان شبیهسازی کند تا زمانی که تنها یک مسیر معتبر باقی بماند. هرچقدر هم که این روش بهینه شده باشد، پیمایش گراف هرگز نمیتواند با سرعت یک تجزیهکننده بازگشتی-نزولی (Recursive-descent parser) که بهصورت دستی و متناسب با نیاز نوشته شده، رقابت کند.
نوشتن دستی یک تجزیهکننده فرآیندی بهشدت خستهکننده و دشوار است که میتواند ماهها زمان ببرد. در گذشته، ریسک ایجاد باگهای ظریف در یک گرامر پیچیده باعث میشد که سرمایهگذاری زمانی برای این کار برای اکثر تیمها غیرمنطقی باشد. PostHog نیز با همین چالش مواجه بود تا اینکه در ماه مه ۲۰۲۶ تصمیم گرفت از جلسات کدنویسی طولانیمدت AI برای خودکارسازی این بازنویسی با استفاده از مدل Claude Opus 4.7 بهره ببرد.
چرا یک تجزیهکننده سفارشی حیاتی است؟
PostHog به کاربران اجازه میدهد تا مستقیماً از طریق SQL به دادهها دسترسی داشته باشند، اما آنها این دستورات را به دلایل استراتژیک به SQL خام ClickHouse تبدیل (Transpile) میکنند:
- انتزاع منطقی: این کار یک نمای منطقی از دادهها را ارائه میدهد که مستقل از ساختار فیزیکی دیتابیس است. این امر به تیم اجازه میدهد تا لایه دیتابیس را بدون شکستن پرسوجوهای موجود کاربران تغییر دهند.
- کنترل و سرعت: این ساختار امکان افزودن بهینهسازیهای عملکردی و اعمال کنترلهای دسترسی سختگیرانه را فراهم میکند.
- خط لوله یکپارچه: اکثریت ابزارهای داخلی PostHog — از جمله بازپخش جلسات (Session Replay)، ردیابی خطاها و تحلیلهای محصول — از پرسوجوهای SQL استفاده میکنند که دقیقاً از همین فرآیند تبدیل عبور میکنند.
از آنجا که تجزیهکننده اولین مؤلفهای است که با یک پرسوجو برخورد میکند، در واقع با ورودیهای نامطمئن (Untrusted Input) سر و کار دارد. تمام مراحل پاییندستی، از جمله کنترلهای دسترسی و بهینهسازیهای ذکر شده، کاملاً به درخت نحو انتزاعی (AST) که توسط تجزیهکننده تولید میشود، وابسته هستند.
تغییر معماری
طبق یک گزارش فنی در posthog.com، تیم توسعه پیادهسازی C++ مبتنی بر ANTLR را رها کرد و به سیستمی نوشت شده با زبان Rust روی آورد. برای اطمینان از موفقیت این انتقال، نویسنده دو رویکرد موازی AI را آزمایش کرد:
۱. مسیر عملکرد: تمرکز بر سریعترین طراحی ممکن؛ یعنی یک تجزیهکننده بازگشتی-نزولی با یک حلقه عبارت Pratt، که از lookahead و backtracking تنها در جاهایی که کاملاً ضروری بود استفاده میکرد.
۲. مسیر ایمنی: تلاش برای تقلید هرچه دقیقتر از رفتار ANTLR، بهطوری که انتقالها بهجای پیمایش عمومی گراف، در کدهای صریح پیادهسازی شوند.
در نهایت، هر دو رویکرد عملکرد مشابهی داشتند. معماری نهایی یک تجزیهکننده عمدتاً پیشبین (Predictive) بازگشتی-نزولی با یک هسته عبارت Pratt و یک مکاننمای (Cursor) از نوع LL(2) است. برای مدیریت موارد خاص پیچیده، AI پروبهای Look-ahead غیرمصرفکننده محدود و بازگشتهای حدسی (Speculative Backtracking) با انتخاب ترتیببندی شده را پیاده کرد. کد نهایی شامل ۱۶ هزار خط کد تجزیهکننده «دستنویس»، ۵ هزار خط ابزار جانبی و چندین هزار خط تست است.
مهندسی حلقه «اوراکل»
برای اطمینان از اینکه هوش مصنوعی باعث ایجاد رگرسیون (بازگشت به باگهای قدیمی) نشود، تیم از تجزیهکننده قدیمی C++ بهعنوان یک «اوراکل» یا مرجع حقیقت استفاده کرد. این کار اجازه داد تا یک چرخه توسعه محور-تست (TDD) بسیار سختگیرانه ایجاد شود که هدف آن تطابق کامل با اوراکل برای تمام پرسوجوهای واقعبینانه بود. فرآیند توسعه از یک حلقه دقیق پیروی میکرد:
- سیستم پرسوجوهای SQLی را شناسایی میکرد که در آنها تجزیهکننده جدید و اوراکل اختلاف نظر داشتند.
- AI یک اصلاحیه کد برای رفع این واگرایی پیشنهاد میکرد.
- تجزیه کننده جدید دوباره در برابر اوراکل تست میشد تا اطمینان حاصل شود خروجیها کاملاً یکسان هستند؛ این یکسانی شامل هر دو مورد AST و موقعیت دقیق منبع (Source Position) میشد.
- اگر همچنان اختلافی وجود داشت، خطا دوباره به AI بازگردانده میشد تا تکرار بعدی را انجام دهد.
حل مشکل «اصلاحات شکننده»
در ابتدا، AI اصلاحاتی تولید میکرد که شکننده بودند. برای مثال، ممکن بود یک مورد را با افزودن یک توکن lookahead اصلاح کند، اما بعداً مشخص شود که برای آن مورد خاص، دو توکن lookahead لازم است. نویسنده گمان میبرد که وقتی پنجره زمینه (Context Window) پر شده و فشرده میشد، AI گرامر اصلی یا منطق تجزیهکننده مرجع را «فراموش» میکرد.
این مشکل از طریق مهندسی پرامپت خاص حل شد: به AI دستور داده شد تا دقیقاً پیش از نوشتن هر کد برای رفع یک واگرایی خاص، هم فایل گرامر و هم کد منبع C++ مربوطه را مجدداً در زمینه (Context) خود بارگذاری کند.
مقیاسبندی با تستهای مبتنی بر ویژگی (PBT)
برای یافتن موارد خاص «شرورانه» — مانند یک پرسوجوی معتبر اما عجیب مثل SELECT SELECT FROM FROM WHERE WHERE AND AND — شرکت PostHog تستهای مبتنی بر ویژگی (Property-Based Testing) را با استفاده از کتابخانه Hypothesis پیاده کرد.
مکانیسمهای پیشرفته فازینگ (Fuzzing)
از آنجا که ویژگی مورد آزمایش «تطابق با اوراکل» بود، تیم به روشی برای تولید ورودیهای SQL باکیفیت و چالشبرانگیز نیاز داشت:
- تولید کد مبتنی بر گرامر: نویسنده ابزاری نوشت تا یک تولیدکننده SQL بر اساس فایل گرامر .g4 اصلی ANTLR بسازد (در واقع نوشتن یک تجزیهکننده برای تولیدکننده تجزیهکننده).
- موتور جایگشت: در مرحله بعد، جایگشتهای اضافی به SQL تولید شده اضافه شد، مانند جابهجایی توکنها یا افزودن پرانتزها برای به شدت تحت فشار قرار دادن منطق کد.
- ShrinkRay: در حالی که Hypothesis میتواند موارد تست را به یک بازتولید حداقلی «کاهش» (Reduce) دهد، تیم از ابزاری به نام ShrinkRay برای شکستهایی که از منابع دیگر مانند لاگهای عملیاتی (Production Logs) میآمدند، استفاده کرد.
- تولید هدایتشده توسط پوشش (Coverage-Guided): تیم تولید موارد تست را بر اساس پوشش کد (Code Coverage) اضافه کرد. این کار باعث شد تولیدکننده به سمت ساختارهای SQL و مسیرهایی سوق یابد که تجزیهکننده هنوز آنها را تجربه نکرده بود و به یافتن باگهای بسیار ظریف کمک کرد.
حلقه اجرای خودکار
برای به حداکثر رساندن کارایی، نویسنده CPU را با تمام ظرفیت روی PBT قرار داد و در عین حال استنتاج Claude را روی نوشتن کد به حداکثر رساند. این حلقه خودکار به شرح زیر عمل میکرد:
۱. تولید شکستهای جدید از PBT، کورپوس واقعی عملیاتی، تستهای رگرسیون و یک عامل پسزمینه که دستور گرفته بود «خیلی سخت روی موارد خاص فکر کند».
۲. افزودن نسخه کوچکشده (Shrunk) این شکستها به لیست در حال گسترش تستهای رگرسیون.
۳. خواندن گرامر و کد منبع C++ برای تعیین اینکه تجزیهکننده مرجع چگونه با آن مورد برخورد میکند.
۴. پیادهسازی اصلاحیه و چاپ یک خلاصه یکپاراگرافی برای اپراتور انسانی.
۵. اجرای کامل مجموعه رگرسیون برای اطمینان از اینکه هیچ رگرسیون جدیدی ایجاد نشده است.
۶. اجرای مجدد حلقه بهصورت خودکار.
اعتبارسنجی نتایج
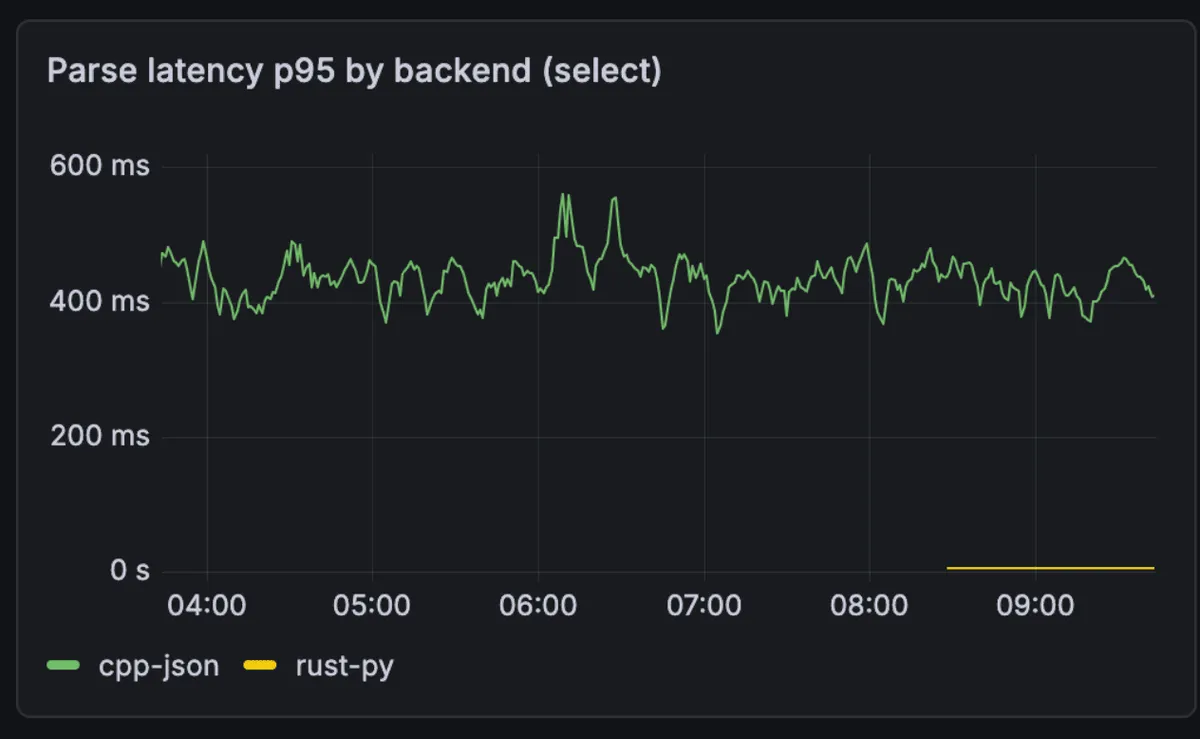
پیش از سوئیچ کامل، تیم تجزیهکننده جدید را در «حالت سایه» (Shadow Mode) اجرا کرد. در حالی که لاگهای اولیه پرسوجوهای عملیاتی حدود ۵۰ هزار مورد را فراهم میکرد، حالت سایه به آنها اجازه داد تا میلیونها تجزیه را در لحظه در برابر تجزیهکننده C++ آزمایش کنند. پس از چندین ساعت عدم مشاهده هرگونه واگرایی، ترافیک را با یک «سایه معکوس» ۰.۱ درصدی برای ایمنی نهایی منتقل کردند.
در بنچمارکهای یک لپتاپ محلی، تجزیهکننده جدید ۷۰ برابر سریعتر بود. اما در محیط عملیاتی، جایی که پرسوجوها معمولاً طولانیترند و احتمال برخورد با کش (Cache) تجزیهکننده کمتر است، میانگین افزایش سرعت به ۴۵۴ برابر رسید. این موضوع تأیید میکند که سربار یک مفسر عمومی مانند ANTLR یک گلوگاه (Bottleneck) قابل توجه برای پلتفرمهای داده با حجم تراکنش بالا است. این رویکرد به حذف وابستگی به لایههای واسطه پیچیده منجر میشود، مشابه آنچه در تغییر رویکرد به سمت حذف Orchestratorهای خارجی برای مدیریت دادههای حجیم دیدیم که کارایی سیستم را افزایش میدهد.
این آزمایش نشاندهنده یک تغییر بنیادین در نحوه ساخت کامپایلرها و تجزیهکنندهها است. آینده احتمالاً ترکیبی خواهد بود که در آن یک تولیدکننده-تجزیهکننده، مشخصات اولیه «صحیح» (اوراکل) را ارائه میدهد و یک مدل زبانی بزرگ (LLM)، یک نسخه با عملکرد بالا را برای تطبیق با آن از طریق فازینگ خودکار مینویسد. برای توسعهدهنده متوسط، این بدان معناست که «سد ورود» برای نوشتن کدهای سیستمی سطح پایین و با عملکرد بالا فروپاشیده است. شما دیگر نیازی نیست که متخصص نظریه زبان باشید تا یک تجزیهکننده بازگشتی-نزولی در Rust منتشر کنید؛ فقط به یک چارچوب تست سختگیرانه نیاز دارید تا صحت کار AI را تأیید کنید.
گام بعدی شما
- اگر سیستمهای قدیمی مبتنی بر ANTLR یا JavaCC دارید، بررسی کنید که آیا میتوان خروجی آنها را بهعنوان اوراکل برای بازنویسی با Rust استفاده کرد.
- برای پروژههای حساس، بهجای اعتماد به کد AI، یک «حلقه تأیید» (Verification Loop) با دادههای واقعی تولید کنید.
- کتابخانه Hypothesis را برای تستهای تصادفی و یافتن لبههای تیز (Edge Cases) در کدهای خود به کار ببرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو