تصور کنید در محیط کاری هستید که در آن حتی یک کلمه از متون قرآن توسط یک مدل زبانی بزرگ (LLM) تولید نمیشود. این هدف اصلی عامل Quran Sanity (Quran Sanity Agent) است؛ ابزاری که به عنوان بخشی از «چالش Sanity» (مسیر اول: عرضه عاملی که محتوای واقعی را استعلام میکند) عرضه شده است. این پروژه ثابت میکند که راهکار واقعی برای حذف توهم (Hallucination) — شبیه دوستی که خاطرهای را اشتباه تعریف میکند — در حوزههای حساس، نه در پرامپتهای بهتر، بلکه در معماری دادهها نهفته است.
بیشتر چتباتهای هوش مصنوعی با متون مذهبی مانند رشتههای متنی بدون ساختار برخورد میکنند. این رویکرد منجر به خطاهای خطرناکی میشود که در آن مدلها کلماتی را از آیات حذف کرده یا گرامر عربی را بهصورت تصادفی و در لحظه ابداع میکنند. زمانی که مفسران کلاسیک با یکدیگر اختلاف نظر دارند، مدلهای استاندارد اغلب یک اجماع جعلی ابداع میکنند یا نظرات متضاد را در یک آشفتگی متناقض با هم ترکیب میکنند و با اعتماد به نفس کامل به کتابهای مشهوری استناد میکنند که حتی ممکن است آن نقلقول هرگز در آنها وجود نداشته باشد. همانطور که در تحلیل قبلی ما دربارهی عاملهای پرتفولیو که قادر به توهم نبودند اشاره کردیم، این پروژه تمرکز را از تولید احتمالی (Probabilistic Generation) به بازیابی قطعی (Deterministic Retrieval) تغییر میدهد. این رویکرد یادآور استراتژیهای سختگیرانه در حوزههای مالی است که برای حذف توهمات در سیستمهای بیمهای به کار گرفته شدهاند.
در این سامانه، هوش مصنوعی بهطور فیزیکی قادر نیست آیهای را از حافظه بخواند. در عوض، این ابزار مانند یک رابط دقیق برای یک پایگاه داده تأییدشده عمل میکند تا خروجی همیشه یک تطبیق دقیق با استانداردهای معتبر باشد. اصل راهبردی این پروژه ساده است: «هر چیزی را بساز که پاسخ آن نباید اشتباه باشد».
معماری اعتماد صفر
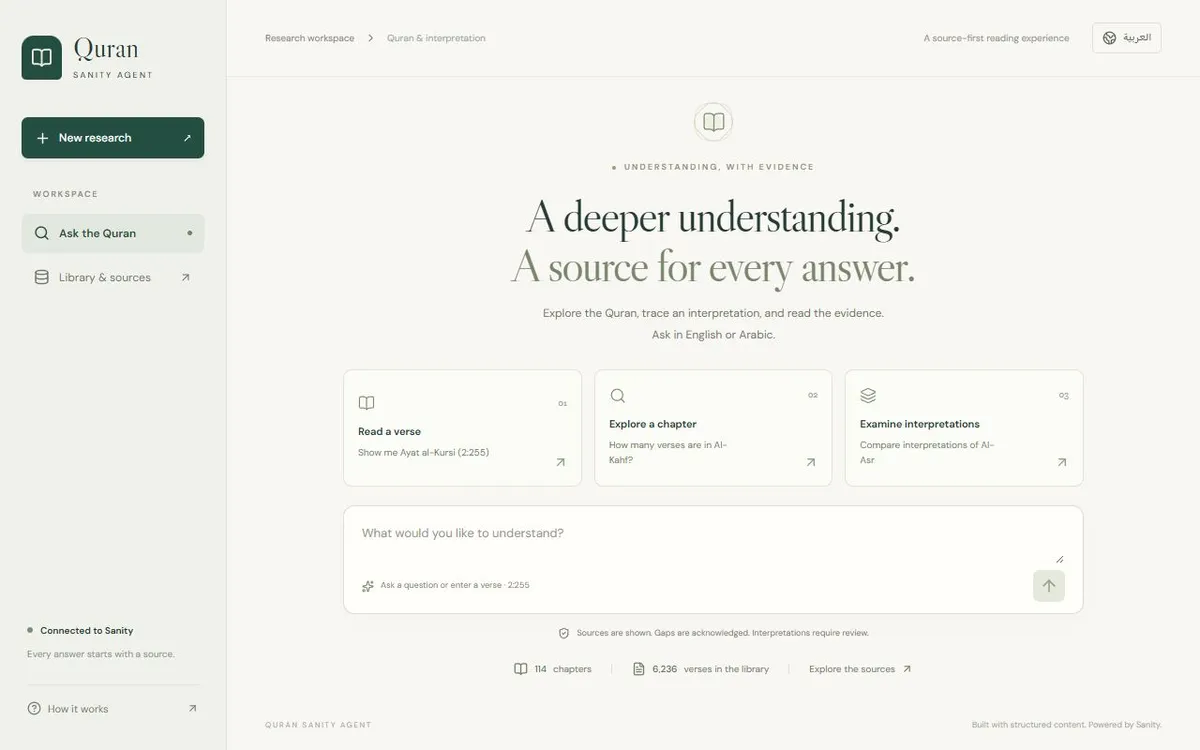
این عامل به صورت یک monorepo با زبان TypeScript ساخته شده است و از Next.js 15 (App Router) با پشتیبانی کامل از راستبهچپ (RTL) عربی و Sanity Studio v3 بهره میبرد. این سیستم بر یک «دریاچه محتوایی» (Content Lake) متکی است که ۶۳۶۹ سند اصلی، شامل ۱۱۴ سوره و ۶۲۳۶ آیه را در خود جای داده است.
برای جلوگیری از اینکه مدل تفاوتهای تاریخی را «صاف» یا سادهسازی کند، سیستم تفاوتهای دیدگاه مفسران را بهصورت دادههای ساختاریافته مدل میکند. در تفسیرهای کلاسیک اسلامی (Tafsir)، علما بیش از هزار سال است که بر سر ظرافتهای لغوی و احکام شرعی بحث میکنند. این اپلیکیشن این اختلافات را در دو دسته متمایز ساختاردهی میکند:
- متضاد (اختلاف تضاد): مواضعی که واقعاً با هم در تضاد هستند. یک مثال بارز، بحث بر سر این است که آیا «بسمالله» در ابتدای سوره فاتحه به عنوان یک آیه شمرده میشود یا خیر.
- مکمل (اختلاف تنوع): معانی چندوجهی که میتوانند در کنار هم وجود داشته باشند. برای مثال، اینکه آیا کلمه «العصر» به خودِ زمان اشاره دارد یا به نماز عصر.
مدلسازی دقیق محتوا
به نقل از مستندات پروژه، بهجای استفاده از طرحهای کلی (Generic Blog Schemas)، از اسکیماهای اختصاصی هرمنوتیک اسلامی در مسیر studio/schemaTypes/ برای تضمین یکپارچگی دادهها استفاده شده است:
- surah: مدیریت متادیتای اصلی فصلها، شامل شماره سوره، نامهای عربی و انگلیسی، نوع نزول (مکی/مدنی) و تعداد کل آیات.
- ayah: سوابق تکتک آیات که شامل متن استاندارد Tanzil Uthmani 1.1، ترجمههای انگلیسی تأییدشده و ارجاعات به سوره مادر است.
- tafsirSource: ردیابی مراجع کلاسیک مانند طبری (متوفی ۳۱۰ هـ)، قرطبی (متوفی ۶۷۱ هـ) و ابنکثیر (متوفی ۷۷۴ هـ)، شامل متدولوژی خاص آنها (اثری، فقهی، عقلی یا لغوی).
- interpretiveClaim: یک پیوند اتمی بین یک آیه و یک منبع تفسیر. این بخش شامل گزیده متن اصلی، مکانیاب فیزیکی کتاب (جلد و صفحه)، طبقهبندی نوع اختلاف و وضعیت ویرایشی است.
- sourceEdition & libraryChunk: اسکیماهای ورود داده که ۲۱۳۹۸ تکه محتوا (Chunk) را از تفاسیر کلاسیک برای بازیابی معنایی بازنمایی میکنند.
اجرای کلمه به کلمه و کشوی شواهد
سیستم یک «قانون مبنیسازی» (Grounding Rule) سختگیرانه را اجرا میکند. وقتی کاربر سوالی مفهومی میپرسد، عامل از طریق نقطه انتهایی Sanity Context MCP (میزبانی شده در api.sanity.io/v1/context/organizations/o831wcpb9/mcp/quran-evidence-mcp) استعلام میگیرد که ۲۱۳۹۸ تکه کتابخانه را بر اساس شباهت معنایی رتبهبندی میکند.
اما مدل اجازه ندارد صرفاً این نتایج را خلاصه کند. اپلیکیشن اعتبارسنجی میکند که هر یادداشت توضیحی، متن منبع را دقیقاً کلمه به کلمه (Verbatim) نقل کرده باشد. اگر مدل در این بررسی شکست بخورد، رابط کاربری بهطور خودکار به نمایش متن خام و تأییدشده از دریاچه محتوایی بازمیگردد. این امر تضمین میکند که LLM هرگز معنای اصلی را بازنویسی (Paraphrase) نکند یا آن را مخدوش نسازد.
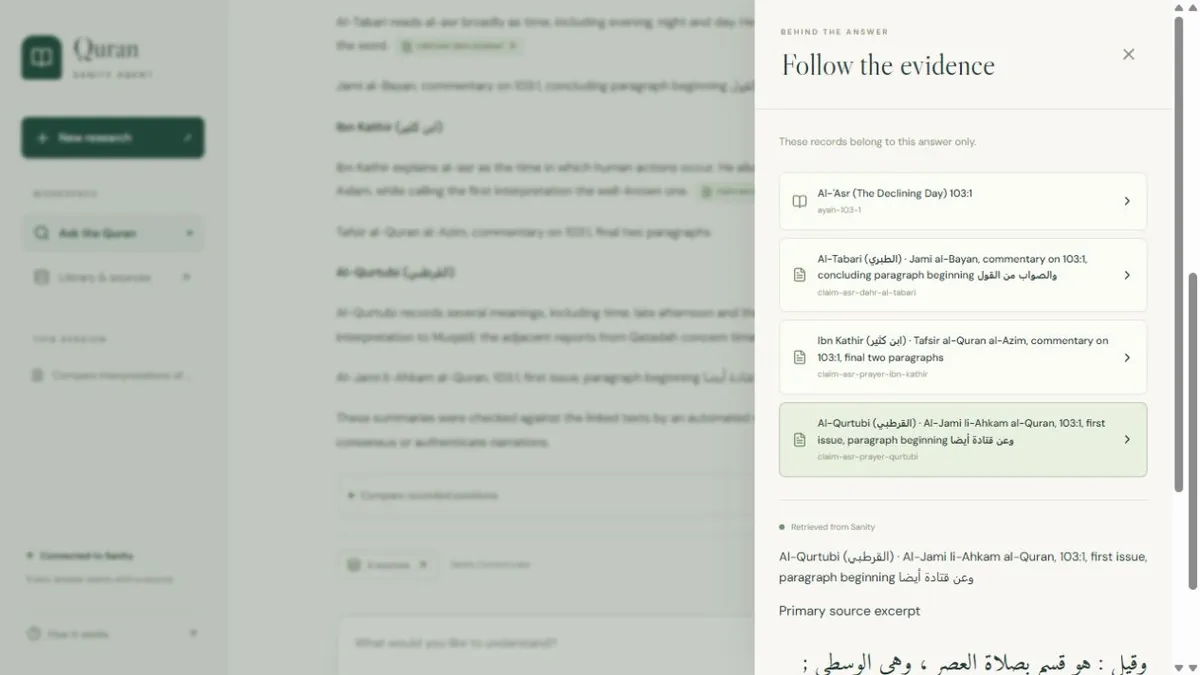
شفافیت سیستم از طریق یک «کشوی شواهد» (Evidence Drawer) تعاملی مدیریت میشود. با کلیک بر روی نشان منبع، شناسه سند Sanity، مکانیاب فیزیکی کتاب (فصل، جلد و URL اصلی) و دادههای خام JSON مستقیماً از دریاچه محتوایی نمایش داده میشود. این قابلیت به کاربران اجازه میدهد تا منبع مورد استفاده هوش مصنوعی را در لحظه بازرسی (Audit) کنند.
دروازه بازبینی تحریریه
اعتبار سیستم از طریق یک خط لوله تحریریه سفارشی در Sanity Studio بیشتر تقویت شده است. توسعهدهنده یک فیلتر «نیاز به بازبینی منبع» در studio/deskStructure.ts پیاده کرده است تا انضباط تحریریه را اجبار کند.
اگر نویسندهای ادعایی را وارد کند اما گزیده متن اصلی کتاب، URL دقیق منبع یا تاییدیه بازبین را فراموش کند، Sanity بلافاصله آن را شناسایی کرده و به صف بازبینی منتقل میکند. مهمتر از آن، کوئریهای GROQ در عامل Next.js بهگونهای سختکد (Hard-coded) شدهاند که فقط سوابقی با وضعیت reviewStatus برابر با source_checked یا reviewed را فیلتر کنند. اگر ادعایی از این دروازه عبور نکند، عامل هوش مصنوعی بهطور فیزیکی قادر به دیدن یا استفاده از آن نیست.
مدیریت شکافهای شواهدی
برخلاف مدلهای زبانی رایج که هنگام نبود داده حدس میزنند، این عامل صراحتاً یک «شکاف شواهدی» (Evidence Gap) را گزارش میکند. اگر کاربر درباره موضوعات مدرن — مانند احکام ارزهای دیجیتال — بپرسد که در مجموعه دادههای منتخب نیست، عامل بهجای ارائه نظر بدون پشتوانه، تصریح میکند که هیچ منبع معتبری در دسترس نیست. سیستم بهطور صریح نشان میدهد که پیش از گزارش این شکاف، کدام رکوردها را جستوجو کرده است. این دقت در مدیریت خروجیها پاسخی است به چالشهای عملیاتی عاملهای هوش مصنوعی که اغلب به دلیل عدم مدیریت صحیح شکافهای دادهای در محیطهای واقعی شکست میخورند.
تست خط لوله
کاربران میتوانند مکانیسمهای سیستم را با پرسوجوهای خاص آزمایش کنند:
- یکپارچگی دقیق آیات: جستوجوی «۲:۲۵۵» منجر به بازیابی فوری آیه الکرسی با رسم عثمانی تأییدشده و ترجمه Saheeh International میشود که به سند
ayah-2-255متصل است. - تضادهای تفسیری: مقایسه تفاسیر بسمالله در فاتحه، مواضع متضاد بین ابنکثیر/قرطبی و فخر رازی را بهصورت در کنار هم (Side-by-side) نمایش میدهد، بدون اینکه مدل هیچ جانبداری کند.
- تنوع تفسیری: مقایسه تفاسیر سوره عصر نشان میدهد که چگونه طبری، ابنکثیر و قرطبی هر کدام ابعاد متفاوتی (زمان، اعمال انسان، نماز عصر) را برجسته میکنند.
- بازیابی معنایی: پرسش درباره «عدالت در حق خود» با استفاده از Sanity Context MCP، آیه ۴:۱۳۵ را در صدر نتایج با یادداشتهای مستند کلمه به کلمه قرار میدهد.
این رویکرد فرض بنیادی تولید بازیابیافزا (RAG) را تغییر میدهد. بهجای ریختن تکههای خام در یک پرامپت و امید به اینکه مدل آنها را درست خلاصه کند، سیستم از LLM فقط برای شناسایی ID رکورد درست استفاده میکند و تحویل محتوای واقعی را به یک بازیابی قطعی با زمان پاسخ زیر ۵۰ میلیثانیه میسپارد.
برای توسعهدهندگان، این یعنی هوش مصنوعی دیگر منبع حقیقت نیست، بلکه یک کتابدار است. با تفکیک سورهها از آیات و اجماع از اختلاف در سطح اسکیما، عامل حدس زدن را متوقف کرده و بازیابی را آغاز میکند.
این تغییر نشان میدهد که برای هر حوزهای که دقت در آن غیرقابل مذاکره است — اعم از حقوقی، پزشکی یا مذهبی — صنعت باید به سمت دریاچههای محتوایی بهشدت ساختاریافته حرکت کند، بهجای آنکه به پنجرههای متنی (Context Windows) در حال گسترش مدلهای بزرگتر تکیه کند. این پروژه از طریق گیتهاب (OmarAfifi-CSE/quran-sanity-agent) بهصورت متنباز در دسترس است و از Sanity Project ID با مقدار qkca243t و یک مجموعه داده تولیدی استفاده میکند.
برای بررسی کامل پیادهسازی و مشاهده ۲۱۳۹۸ تکه ایندکس شده، میتوانید به مخزن گیتهاب پروژه یا وباپلیکیشن زنده در quran-sanity.omar-afifi.com مراجعه کنید.
گام بعدی شما
- بررسی مخزن گیتهاب پروژه برای درک نحوه پیادهسازی اسکیماهای تخصصی در Sanity.
- تست قابلیت «کشوی شواهد» در وباپلیکیشن زنده برای مشاهده نحوه اتصال خروجی AI به JSON خام.
- مطالعه نحوه استفاده از MCP برای تبدیل مدلهای زبانی از «تولیدکننده» به «کتابدار».
اما تأثیر این معماری بر کاهش هزینههای استنتاج در مقیاس بزرگ حتی جذابتر است — به تحلیل ما درباره بهینهسازی توکنها در مدلهای استدلالی مراجعه کنید.



گفتگو