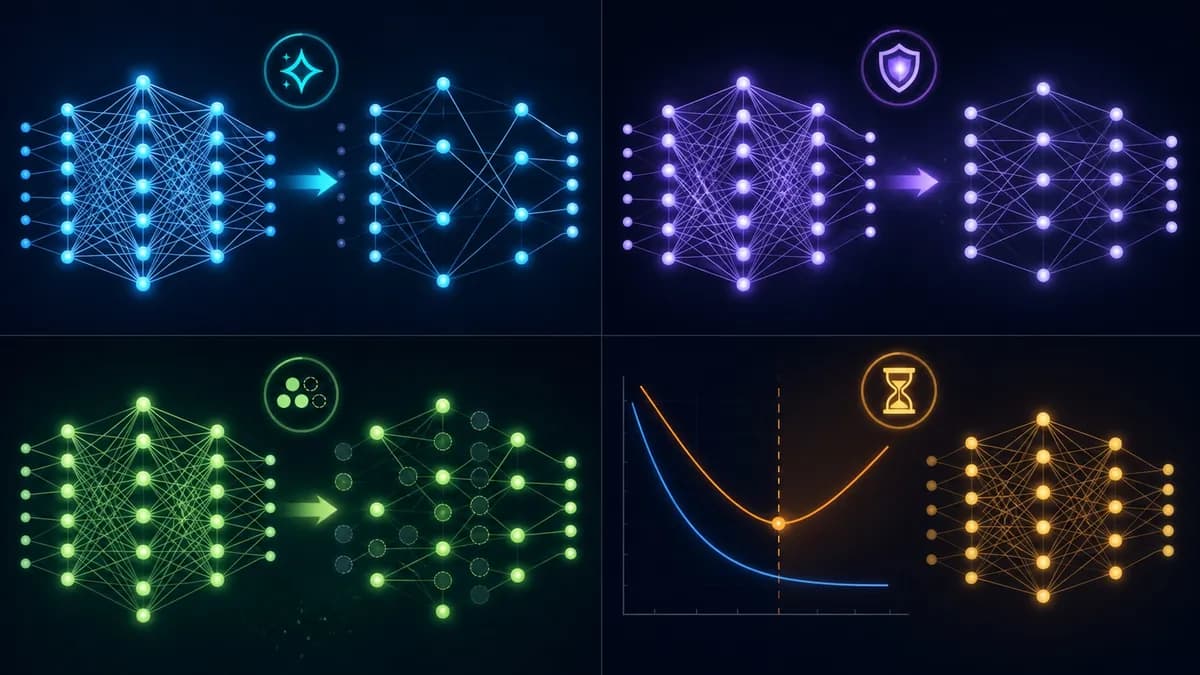
تصور کنید مدلی ساختهاید که در محیط آزمایشگاهی نمرات کامل میگیرد، اما به محض مواجهه با اولین کاربر واقعی، پاسخهایی بیربط و متناقض میدهد. این شکست دقیقاً همان جایی است که منظمسازی (Regularization) — شبیه به یک مربی سختگیر که اجازه نمیدهد دانشآموز فقط جوابها را حفظ کند و او را مجبور به یادگیری مفاهیم میکند — وارد عمل میشود.
به نقل از Unite.ai، هوش مصنوعی «شکننده» (Brittle AI) زمانی رخ میدهد که پیچیدگی بیش از حد مدل باعث میشود سیستم در لحظهٔ برخورد با دادههای خارج از مجموعهٔ آموزش، شکست بخورد. طبق این منبع، تنها راه حل این مشکل، منظمسازی است؛ فرآیندی سیستماتیک برای تغییر اهداف آموزش، معماری یا فرآیند توقف مدل تا پیچیدگیهای شکننده کاهش یابد و تعمیمپذیری (Generalization) — یعنی توانایی مدل در بهکارگیری آموختهها روی دادههای جدید — بهبود یابد.
درک دقیق این مفهوم ضروری است، زیرا منظمسازی صرفاً یک اصطلاح کلی نیست، بلکه نامی است که یک جریان اطلاعاتی خاص، یک انتخاب در زمان آموزش، یک مکانیسم زماناجرا یا یک مرز حاکمیتی را شناسایی میکند. اگر آن را مترادف با «هوش مصنوعی پیشرفته» بدانیم، ادعاهای فنی غیرقابل تست میشوند. این راهنما مفهوم منظمسازی را از ورودیها و فرضها تا نتایج قابل مشاهده دنبال میکند و سپس میانبری را که احتمالاً با آن اشتباه گرفته میشود، مورد آزمایش قرار میدهد.
بسیاری از توسعهدهندگان به اشتباه تصور میکنند جمعآوری دادههای بیشتر تنها راه حل است. اما منظمسازی یک مرز ساختاری ایجاد میکند که مدل را مجبور میکند به جای یادگیری نمونههای خاص، الگوهای کلی را استخراج کند. در واقع، در حالی که جمعآوری دادهها ممکن است به مدل کمک کند، منظمسازی ساختاری را فراهم میکند که مانع از حفظ کردن (Memorization) میشود.
تعریف و مرزهای منظمسازی
منظمسازی یک آرزو یا هدف کلی نیست، بلکه یک مکانیسم پیادهسازی شده است. برای اینکه یک فرآیند بتواند برچسب «منظمسازی» دریافت کند، باید سه تعهد عملی را در خود داشته باشد:
- یک ورودی قابل شناسایی.
- یک تغییر یا تصمیم که ویژگی خاص منظمسازی باشد.
- نتیجهای که در برابر یک هدف مشخص قابل ارزیابی باشد.
اگر هر یک از این عناصر غایب باشد، برچسب مورد نظر احتمالاً توصیفکننده یک آرزو است تا یک مکانیسم پیادهسازی شده. یادگیری آماری، نمونههای محدود را به ادعاهایی درباره دادههای آینده تبدیل میکند. بنابراین، تفکیک دادهها، بهینهسازی، منظمسازی، معیارهای ارزیابی و نظارت، همگی بخشهایی از یک مسئله واحد یعنی «مسئله تعمیمپذیری» هستند، نه تکنیکهای مجزای کتابخانهای. این رویکرد تکمیلی با روشهای اعتبارسنجی متقابل همسو است که از توهم دقت در مدلها جلوگیری میکند.
این دیدگاه سیستمی بسیار حیاتی است زیرا عملکرد مدل میتواند توسط دادههای محیطی، رابطها، سختافزار، مجوزها و حتی افراد تعیین شود، حتی زمانی که مدل زیربنایی بدون تغییر باقی مانده باشد. بنابراین، یک توضیح مفید باید رفتار یادگرفتهشدهی مدل را از «محصولی» که تصمیم میگیرد این رفتار چه زمانی، کجا و با چه اختیاراتی استفاده شود، جدا کند.
نقشه عملیاتی ۵ مرحلهای
پیادهسازی منظمسازی یک کلید ساده یا یک تنظیم تکمرحلهای نیست، بلکه یک نقشه علی ۵ مرحلهای است. طبق راهنمای Unite.ai، این فرآیند از عملیاتهای قابل مشاهده زیر پیروی میکند. این نقشه یک مدل علی فشرده برای منظمسازی است، نه ادعایی مبنی بر اینکه هر پیادهسازی لزوماً از پنج جزء نرمافزاری استفاده میکند. برخی سیستمها مراحل را ترکیب کرده و برخی دیگر آنها را در یک حلقه تکرار میکنند. این نقشه اجبار میکند که هر تغییر در اطلاعات یا اختیارات، یک مالک، یک ورودی، یک خروجی و یک تست داشته باشد.
۱. شناسایی نشانههای بیشبرازش: سیستم باید ابتدا تشخیص دهد چه زمانی مدل روی دادههای آموزش عالی عمل میکند اما روی دادههای اعتبارسنجی ضعیف است. سؤال مفید در اینجا این نیست که آیا این عملیات رخ میدهد یا خیر، بلکه این است که این مرحله چه اطلاعاتی را مصرف میکند، کدام وضعیت را تغییر میدهد و چه شواهدی ثابت میکند که این تغییر معتبر بوده است. یک بازبین باید بتواند این عملیات را از «جمعآوری دادههای بیشتر» (که مشکل را از طریق شواهد اضافی حل میکند) تشخیص دهد و نتیجه آن را تحت همان شرایط ذکر شده بازتولید کند. انتقال به این مرحله با هدف تعیینشده آغاز شده و با نتیجهای پایان مییابد که انتخاب یک محدودیت را توجیه کند. تیمها باید عدم قطعیت، جایگزینهای رد شده، منابع مصرفی و هرگونه کنترل انسانی یا نرمافزاری اعمال شده در مرز را ثبت کنند تا تشخیص دهند آیا منظمسازی بیش از حد، سیگنالهای واقعی را پیش از رسیدن به خروجی نهایی پاک میکند یا خیر.
۲. انتخاب محدودیت: توسعهدهندگان باید مکانیسمی خاص برای محدود کردن پیچیدگی انتخاب کنند. باز هم سؤال این است که این عملیات چه اطلاعاتی را مصرف میکند، چه وضعیتی را تغییر میدهد و چه شواهدی برای اعتبار تغییر وجود دارد. انتقال به این مرحله با شناسایی بیشبرازش آغاز شده و با نتیجهای پایان مییابد که تنظیم شدت روی دادههای اعتبارسنجی را ممکن سازد. گزینههای رایج عبارتند از:
- منظمسازی L1: تشویق به ایجاد وزنهای پراکنده (Sparse Weights) که در عمل ویژگیهای بیاهمیت را صفر میکند.
- منظمسازی L2: جلوگیری از بزرگ شدن بیش از حد وزنها برای اینکه هیچ ویژگی واحدی بر خروجی غالب نشود.
- دراپاوت (Dropout): ایجاد اختلال تصادفی در همساز شدن نورونها از طریق نادیده گرفتن تصادفی آنها در حین آموزش.
- توقف زودهنگام (Early Stopping): محدود کردن حفظ کردن دادهها با متوقف کردن آموزش در لحظهای که عملکرد روی دادههای اعتبارسنجی افت میکند.
این انتخابها در واقع ابزاری برای اصلاح توابع زیان هستند تا مدل به جای بهینهسازی روی نویز، بر روی الگوهای واقعی متمرکز شود. مانند مرحله قبل، تیمها باید عدم قطعیت، جایگزینهای رد شده و منابع مصرفی را ثبت کنند. این ردپای مستند به تیمها اجازه میدهد تشخیص دهند آیا منظمسازی بیش از حد باعث پاک شدن سیگنالهای واقعی و ایجاد «کمبرازش» (Underfitting) پیش از رسیدن ضعف به خروجی نهایی شده است یا خیر.
۳. تنظیم شدت روی دادههای اعتبارسنجی: «شدت» محدودیت انتخاب شده باید متوازن شود. این مرحله محدودیت انتخاب شده را مصرف کرده و نتیجهای تولید میکند که آموزش را در حالی که برازش و پایداری ردیابی میشوند، پشتیبانی کند. یک بازبین باید بتواند این عملیات را از جمعآوری دادههای بیشتر متمایز کند. انتقال به این مرحله با انتخاب محدودیت آغاز شده و با نتیجهای پایان مییابد که آموزش را با ردیابی همزمان برازش و پایداری پشتیبانی کند. اگر شدت خیلی کم باشد، مدل شکننده میماند؛ اگر خیلی زیاد باشد، باعث کمبرازش میشود. هرگونه کنترل انسانی یا نرمافزاری در مرز باید ثبت شود تا فرآیند بازتولیدپذیر باشد.
۴. ردیابی برازش و پایداری: آموزش ادامه مییابد در حالی که نظارت میشود که مدل چقدر خوب با دادهها برازش میشود و پیشبینیهای آن در برشهای مختلف اطلاعاتی چقدر پایدار میمانند. سؤال کلیدی این است که چه اطلاعاتی مصرف شده، چه وضعیتی تغییر کرده و چه شواهدی اعتبار تغییر را ثابت میکند. این مرحله با شدت تنظیم شده آغاز شده و با نتیجهای پایان مییابد که تأیید دستاوردها روی دادههای دستنخورده را ممکن سازد. ثبت عدم قطعیت، جایگزینهای رد شده و منابع مصرفی برای بازتولیدپذیری تحت شرایط یکسان ضروری است.
۵. تأیید دستاوردها روی دادههای دستنخورده: مرحله نهایی، تأیید عملکرد روی یک مجموعه آزمون کاملاً ایزوله است تا اطمینان حاصل شود که دستاوردها به دنیای واقعی قابل انتقال هستند. سؤال این است که چه اطلاعاتی مصرف شده، چه وضعیتی تغییر کرده و چه شواهدی اعتبار تغییر را ثابت میکند. این مرحله با ردیابی برازش و پایداری آغاز شده و با نتیجهای پایان مییابد که نظارت نهایی یا تصمیم نهایی را پشتیبانی کند. هرگونه کنترل انسانی یا نرمافزاری در مرز باید ثبت شود تا تشخیص داده شود آیا منظمسازی بیش از حد سیگنالهای واقعی را پاک کرده است یا خیر.
تحلیل نقشه: نگاه رو به جلو و عقب
این نقشه ۵ مرحلهای را میتوان در دو جهت برای مدیریت تولید و شکست خواند:
- تحلیل رو به جلو: میپرسد هر مرحله چگونه ورودی مرحله بعد را تأمین میکند تا جریان تولید درک شود.
- تحلیل رو به عقب: از یک نتیجه غلط، کند، گران یا ناامن شروع کرده و به عقب ردیابی میکند تا ببیند کدام فرض اولیه اجازه وقوع این خطا را داده است. این مسیر معکوس اغلب جایی است که تیمها متوجه میشوند خطای تعیینکننده، مدتها پیش از آنکه مدل خروجی تولید کند، رخ داده است.
خطر میانبر «دادههای بیشتر»
یک تمایل رایج در صنعت این است که «جمعآوری دادههای بیشتر» را مترادف با منظمسازی بدانند. اما این راهنما استدلال میکند که این یک میانبر گمراهکننده است. در حالی که شواهد بیشتر میتوانند کمک کنند، اما داستان علی را تغییر میدهند: شواهد متفاوت، موفقیت متفاوتی را تثبیت میکنند، منابع متفاوتی هزینه را تعیین میکنند و کنترلهای متفاوتی از آسیب جلوگیری میکنند. بنابراین، مرز در اینجا عملیاتی است، نه اصطلاحی.
منظمسازی واقعی، یک تبدیل (Transformation) و یک نتیجه قابل اندازهگیری را حفظ میکند. میانبر افزودن دادهها، این مرز عملیاتی را حذف میکند. این امر میتواند منجر به ریسکهای زیر شود:
- خریداران ممکن است محصولات نامتجانس را با هم مقایسه کنند.
- پژوهشگران ممکن است در مورد آنچه یک آزمایش ثابت میکند، اغراق کنند.
- اپراتورها ممکن است پس از استقرار، سیگنال اشتباهی را نظارت کنند.
برای روشن شدن تفاوت، تبدیل اصلی را در نظر بگیرید: منظمسازی هدف آموزش، معماری یا فرآیند توقف را تغییر میدهد. میانبر، این مرز اصلی را نادیده میگیرد. ریسک اصلی در روش اول این است که منظمسازی بیش از حد سیگنال واقعی را پاک کند، در حالی که میانبر صرفاً پایگاه شواهد را تغییر میدهد.
چرا این موضوع برای هوش مصنوعی مدرن حیاتی است؟
با گسترش پنجرههای متنی (Context)، افزایش مودالیتهها، افزایش محاسبات زماناجرا، دسترسی گستردهتر به ابزارها و ارتباطات عمیقتر با تصمیمات سازمانی، منظمسازی دیگر یک جزئیات پژوهشی نیست. این موضوع اکنون مستقیماً بر تأخیر (Latency)، امنیت، دسترسیپذیری، هزینه محیطزیستی، کیفیت محصول و مسئولیت قانونی اثر میگذارد.
منظمسازی مؤثر باید بر اساس تأثیر آن بر «موارد دشوار» و «توانایی بازیابی پس از مواجهه با شواهد متناقض» اندازهگیری شود، نه بر اساس یک امتیاز میانگین دقت. هدف این نیست که مدل را «باهوشتر» کنیم — زیرا باهوشتر بودن یک معیار پذیرش فنی نیست — بلکه هدف این است که تضمین کنیم رفتار مدل در شرایط نماینده، وفادار و مستند (Grounded) باشد. به جای فشرده کردن تمام نتایج در یک میانگین، باید توزیعها، دستههای شکست، تأخیرهای دم (Tail Latency)، مصرف منابع و زیرگروههای متأثر گزارش شوند.
اهداف مفید برای اندازهگیری عبارتند از:
- نرخ خطا در موارد دشوار.
- بازیابی پس از مواجهه با شواهد متناقض.
- هزینه در یک صدک خاص از ترافیک.
- زمان بازبینی انسانی و کالیبراسیون.
- درصد اقداماتی که در محدوده اختیارات تعریفشده باقی ماندهاند.
مدیریت شکست: کمبرازش
ریسک مرکزی این فرآیند، کمبرازش (Underfitting) است؛ جایی که منظمسازی بیش از حد، سیگنالهای واقعی را پاک میکند. این شکست نباید به عنوان یک موضوع ثانویه دیده شود، بلکه باید از ابتدا شکلدهنده جمعآوری دادهها، معماری، مجوزها و گیتهای انتشار باشد.
برای جلوگیری از این اتفاق، تیمها باید یک مسیر کنترلی را پیاده کنند که حرکت سیستم به سمت پیامدهای دنیای واقعی را دنبال کند:
۱. حفظ مجموعه آزمون $ \rightarrow $ ۲. آموزش مدل $ \rightarrow $ ۳. اعتبارسنجی انتخابها $ \rightarrow $ ۴. اندازهگیری برشها $ \rightarrow $ ۵. نظارت بر رانش (Drift).
بازیابی از منظمسازی بیش از حد باید پیش از وقوع یک پیامد گران یا برگشتناپذیر برنامهریزی شود. اولین پیشنشانههای قابل مشاهده شکست را شناسایی کنید، یک آستانه یا قانون تعیین کنید، یک مالک مسئول مشخص کنید و بازیابی را تست کنید. بسته به مورد مصرف، بازیابی میتواند به معنای موارد زیر باشد:
- امتناع از تصمیمگیری.
- بازگشت به یک سیستم سادهتر.
- درخواست شواهد بیشتر.
- ارجاع موضوع به یک انسان.
- بازگرداندن (Rollback) مدل.
- توقف کامل یک اقدام.
ارزیابی و استقرار
برای ارزیابی درست منظمسازی، توسعهدهندگان باید با نوشتن تصمیمی که شواهد باید از آن پشتیبانی کنند، شروع کنند. این شامل تعریف جمعیت عملیاتی، پیامد یک نتیجه غلط، اطلاعات موجود در زمان تصمیمگیری و سادهترین جایگزین معتبر است. این کار مانع از آن میشود که یک بنچمارک صرفاً به دلیل سهولت در اجرا، به هدف تبدیل شود.
ارزیابی باید از مراحل آفلاین به آنلاین حرکت کند:
- ارزیابی آفلاین: استفاده از یک مجموعه آزمون دستنخورده برای مقایسههای کنترلشده تا نسخههای مختلف قابل مقایسه باشند.
- محیط عملیاتی مرحلهبندی شده: استفاده از حالت Shadow، کاناریها (Canaries)، محدودیتهای نرخ (Rate Limits) یا گیتهای تأیید برای آشکار کردن اینکه ترافیک واقعی، حلقههای بازخورد و انسانها چگونه رفتار مدل را تغییر میدهند.
استقرار باید یک شرط توقف صریح داشته باشد، به جای اینکه فرض شود هر بهبودی لایق انتشار کامل است. بازتولیدپذیری کامل مستلزم نسخهبندی هر ورودی است: دادههای منبع، پیشپردازش، توکنساز یا انکودر، وزنهای مدل، پیکربندی، پرامپت یا پالیسی، ایندکس بازیابی، مجموعه ارزیابی، فرضهای سختافزاری و کد سرویسدهی. این ضرورتِ نسخهبندی دقیق، هسته اصلی مانیفست انتشار است تا از فروپاشی سیستمها در محیط تولید جلوگیری شود. بدون این زنجیره (Lineage)، یک تیم نمیتواند تشخیص دهد که تغییر عملکرد ناشی از تکنیک بوده، محیط تغییر کرده یا یک ویرایش متناقض در خط لوله (Pipeline) رخ داده است.
اعتبارسنجی نهایی و پذیرش
قبل از پذیرش منظمسازی، تیمها باید سؤالات حیاتی درباره گلوگاه قابل اندازهگیری که در حال حل شدن است، تبدیل متمایز در ۵ مرحله و مقایسه آن با خط مبنای «دادههای بیشتر» بپرسند. آنها باید موارد عادی، دشوار و خصمانه (Adversarial) را تست کنند. یک تست سختگیرانه، موارد عادی، دشوار و عمداً گمراهکننده را پیرامون سناریو میسازد، یک خط مبنا بدون این تکنیک را حفظ میکند و هم عملکرد میانگین و هم شدت شکستهای فردی را ثبت میکند.
یک فرض را در مثال منظمسازی تغییر دهید و تحلیل را تکرار کنید. یک ورودی مورد نیاز را حذف کنید، یک سیگنال متناقض وارد کنید، محاسبات را محدود کنید، جمعیت کاربران را تغییر دهید یا سیستم را مجبور به امتناع کنید. مکانیسمی که فقط تحت یک نمایش Carefully Arranged موفق میشود، ثابت نکرده است که به محیط عملیاتی تعمیم مییابد.
در نهایت، تیمها باید بپرسند چه یافتهای میتواند این ادعا را که «منظمسازی کمک میکند» ابطال کند. اگر هیچ نتیجهای نتواند تصمیم به پذیرش را لغو کند، آن ارزیابی صرفاً بازاریابی است. آستانههای پذیرش پیشتعیینشده و یک مجموعه تأیید حفظشده، این تمرین را به «شواهد» تبدیل میکند.
منابع اصلی و خلاصه
برای کسانی که پشته (Stack) هوش مصنوعی پیرامون منظمسازی را مطالعه میکنند، نقاط شروع معتبر عبارتند از: راهنمای انتخاب مدل scikit-learn، قوانین گوگل برای ML و NIST AI RMF. اینها باید در کنار مستندات مدل، مجموعه داده، سختافزار و حوزه قضایی مربوطه خوانده شوند. یک منبع کلی میتواند مکانیسم را تعریف کند، اما تنها شواهد خاصِ استقرار میتواند ثابت کند که یک پیادهسازی خاص مناسب است.
به طور خلاصه، منظمسازی یک مکانیسم تعریفشده در یک سیستم اجتماعی-فنی بزرگتر است. ارزش آن از بهبود یک نتیجه خاص تحت شرایط صریح میآید. با تعریف هدف، مقایسه با یک خط مبنای معتبر، تست شکستی که بیشترین اهمیت را دارد و حفظ شواهد برای نظارت بر تغییر، این مفهوم به یک انتخاب مهندسی و حاکمیتی تبدیل میشود که قابل ارزیابی است. بدون این قطعات، منظمسازی صرفاً نامی امیدوارکننده است که به یک ریسک عملیاتی ناشناخته متصل شده است.
گام بعدی شما
- در مدلهای خود، نرخ خطای دادههای آموزش را با دادههای اعتبارسنجی مقایسه کنید تا میزان بیشبرازش را بسنجید.
- اگر مدل شما در محیط عملیاتی «شکننده» است، به جای افزودن داده، تکنیک Dropout یا L2 را امتحان کنید.
- یک مجموعه داده آزمون کاملاً ایزوله ایجاد کنید که هرگز در مراحل تنظیم مدل (Tuning) استفاده نشود.
اما داستان سختافزاری این تحول و تأثیر آن بر هزینه استنتاج حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو