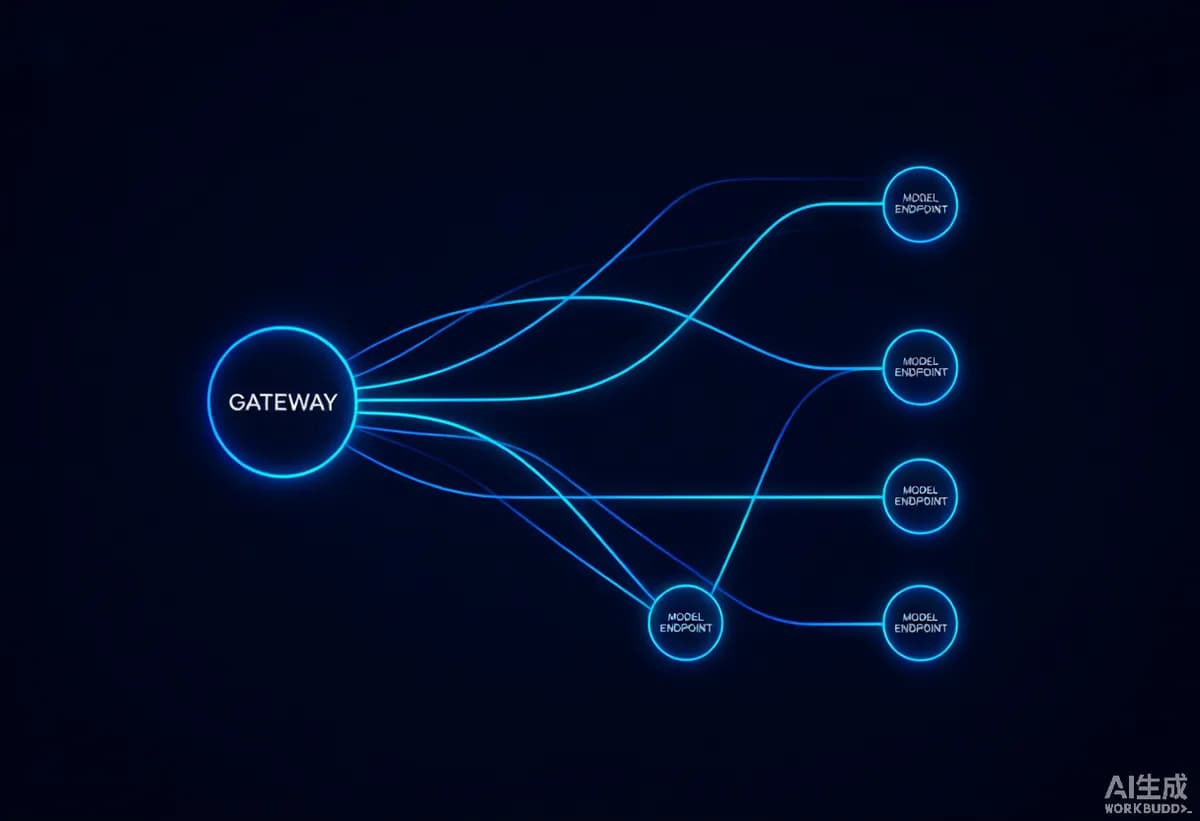
صورتحسابهای توکنی شما برای عاملهای هوش مصنوعی احتمالاً پنج برابر بیشتر از نیاز واقعی است، چون تیمها عادت کردهاند برای هر فراخوانی ساده، به طور پیشفرض از مدلهای پرچمدار استفاده کنند. طبق راهنمای کاربردی که در ۳۱ جولای ۲۰۲۶ در وبسایت dev.to منتشر شد، اجرای یک نظم سختگیرانه در مسیریابی (Routing) با مدل ۸۰/۲۰ — یعنی ارسال وظایف ساده به لایههای ارزان — میتواند هزینههای استنتاج (Inference) را بدون قربانی کردن کیفیت، ۷۰٪ یا بیشتر کاهش دهد. این رویکرد در واقع تکاملیافتهی سیستم مسیریابی لایهای است که پیشتر بهعنوان راهکاری برای توقف اتلاف بودجه در APIها معرفی شد.
بسیاری از توسعهدهندگان مسیر کممقاومت را انتخاب میکنند و هر مرحله از حلقهٔ یک عامل (Agent) را به مدلی مانند gpt-5.5 متصل میکنند. در واقعیت، اکثریت قریب به اتفاق کارهای عاملمحور شامل عملیاتهای سادهای هستند. این وظایف توسط مدلهای سریع و کمهزینه با کیفیتی indistinguishable یا غیرقابل تشخیص انجام میشوند؛ بنابراین استفاده از یک مدل پرچمدار در این موارد، تبدیل به یک «مالیات» پرهزینه بر سیستم میشود.
همانطور که در تحلیل قبلی ما دربارهی بهینهسازی هزینههای مدلهای زبانی اشاره کردیم، مدیریت منابع در مقیاس بالا، تفاوت بین یک محصول سودآور و یک پروژه شکستخورده است.
کالبدشکافی یک حلقهٔ عامل
برای درک دلیل وجود این مالیات، باید به ساختار یک حلقهٔ معمولی عامل نگاه کنیم. اکثر این حلقهها از گامهای زیر تشکیل شدهاند:
- طبقهبندی درخواست (Classifying the request)
- استخراج فیلدهای ساختاریافته (Extracting structured fields)
- انتخاب یک ابزار و فراخوانی آن (Picking a tool and calling it)
- تجزیه و تحلیل نتیجهٔ ابزار (Parsing the tool result)
- خلاصهسازی اتفاقات رخ داده (Summarizing what happened)
- تصمیمگیری برای گام بعدی (Deciding the next step)
- پیشنویس پاسخ نهایی (Drafting the final reply)
از میان این مراحل، شاید تنها یک یا دو مورد واقعاً به استدلالهای سطح پیشرو (frontier-level reasoning) نیاز داشته باشند. بقیه مسیر، صرفاً کارهای پایهٔ طبقهبندی، استخراج و فرمتبندی است.
برای حل این مشکل، این دستورالعمل یک تقسیمبندی سه سطحی بر اساس پیچیدگی وظیفه پیشنهاد میدهد:
- ساده (۸۰٪): شامل طبقهبندی، استخراج، خلاصهسازی، فرمتبندی کوتاه ابزارها و تصمیمات مسیریابی از طریق یک لایه سریع مانند TokenLat-deepseek-v4-Flash (با هزینه ¤۱۶۰ برای هر ۱ میلیون توکن ورودی).
- متوسط (۱۵٪): شامل کدنویسی، برنامهریزی و استدلالهای چندمرحلهای از طریق یک لایه استدلالی مانند TokenLat-deepseek-v4-Pro (با هزینه ¤۵۶۰ برای هر ۱ میلیون توکن ورودی).
- سخت (۵٪): موارد واقعاً پیچیده و دشوار که برای مدلهای پرچمداری مانند chatgpt-5.5 رزرو میشوند (با هزینه ¤۷۰۰۰ برای هر ۱ میلیون توکن ورودی).

ریاضیات ترکیبی هزینهها
بر اساس دادههای درگاه TokenLat، هزینه ترکیبی ورودی برای این تقسیمبندی به شرح زیر محاسبه میشود:
- ۸۰٪ × ¤۱۶۰ (لایه ارزان) = ¤۱۲۸
- ۱۵٪ × ¤۵۶۰ (لایه استدلالی) = ¤۸۴
- ۵٪ × ¤۷۰۰۰ (ورودی پرچمدار) = ¤۳۵۰
این محاسبات منجر به هزینه ترکیبی ورودی تقریباً ¤۵۶۲ برای هر ۱ میلیون توکن میشود، در حالی که در رویکرد «تماماً پرچمدار»، این عدد ¤۷۰۰۰ بود. این یک شکاف عظیم است، زیرا ورودی لایهی ارزان تقریباً ۴۴ برابر ارزانتر از قیمتهای لایهی پرچمدار است. حتی با یک تقسیمبندی محافظهکارانهتر، کفِ میزان صرفهجویی ۷۰٪ است، زیرا فراخوانیهای سخت همچنان به مدلهای پیشرو هدایت میشوند.
ریسکهای پنهان: سقوط کیفیت و مالیات حافظه پنهان
کاهش هزینههای سادهلوحانه — یعنی استفاده از یک مدل ارزان برای همه کارها — به دو دلیل خاص شکست میخورد. نخست «سقوط کیفیت» (Quality Cliffs) است. در حالی که یک مدل ¤۱۶۰/1M در استخراج داده عالی است، اما در برنامهریزی برای بازسازی (refactor) یک پروژه ۱۲ فایلی، افتضاح عمل میکند. اگر وظایف سخت را به یک مدل ارزان فشار دهید، کاربران فوراً متوجه افت کیفیت میشوند.
دومین مورد، ابطال حافظه پنهان (Cache Invalidation) است که منبع این گزارش آن را «مالیات خاموش» مینامد. این هزینهای است که تقریباً هیچکس برای آن بودجهبندی نمیکند. در گفتگوهای طولانی عاملها، پرامپت سیستمی و تعاریف ابزارها در هر نوبت دوباره ارسال میشوند. اگر در میانه گفتگو ارائهدهنده مدل را تغییر دهید، نزدیکی به حافظه پنهان (Prompt-cache affinity) ریست شده و باید هزینه کامل پیش-وند (prefix cost) را در هر نوبت دوباره بپردازید. گفتگویی که باید ارزان باشد، ناگهان گران میشود. در این زمینه، بررسی تفاوت بین الگوریتمهای بهینهساز و روترهای ساده در مدیریت حافظه نشان میدهد که اشتباه در انتخاب استراتژی مسیریابی میتواند هزینههای عامل را تا دو برابر افزایش دهد.
برای جلوگیری از این اتفاق، استراتژی پیشنهادی این است که آن ۸۰٪ ساده را به یک مدل ارزان و پایدار بچسبانید تا حافظه پنهان «گرم» بماند و فقط برای فراخوانیهایی که واقعاً استحقاق آن را دارند، به مدل پیشرو بروید.
مکانیسمهای مسیریابی و زیرساخت
TokenLat یک درگاه واحد برای مالزی و جنوب شرق آسیا ارائه میدهد که ۲۲ مدل از ۸ ارائهدهنده مختلف را از طریق یک API سازگار با OpenAI مدیریت میکند. این زیرساخت به توسعهدهندگان اجازه میدهد مسیریابی را تنها با حدود ۱۰ خط کد پیاده کنند، بدون اینکه نیاز باشد با SDKهای متعدد ارائهدهندگان دستوپنجه نرم کنند. رشد استفاده از مدلهای بهینه در این زیرساختها با این واقعیت همسو است که مدلهای وزنباز اکنون ۶۵٪ از حجم توکنهای جهانی را تصاحب کردهاند.
یک تابع مسیریابی نمونه به این شکل است:def route(task): if task.complexity == "easy": return "TokenLat-deepseek-v4-Flash" # ¤160/1M if task.needs_reasoning: return "TokenLat-deepseek-v4-Pro" # ¤560/1M return "chatgpt-5.5" # Hard 5%
به طور جایگزین، توسعهدهندگان میتوانند از پیکربندی model: "auto" استفاده کنند. این یک نسخه بدون تنظیمات (zero-config) است که در آن درگاه، سیاست مسیریابی را به طور خودکار برای هر درخواست اعمال میکند.
بنچمارکهای قیمتگذاری و خواندن از حافظه پنهان
در سامانههای عاملمحور، قیمت ورودی اغلب در مقایسه با قیمت «خواندن از حافظه پنهان» (Cache-read) یک موضوع حاشیه است، زیرا پیشوندهای استاتیک (مانند طرحواره ابزارها و بافت بازیابی شده) مکرراً ارسال میشوند. بر اساس اعتبار (¤) درگاه TokenLat، نرخهای ورودی / خواندن از حافظه شامل موارد زیر است:
- TokenLat-deepseek-v4-Flash: ¤۱۶۰ / ¤۴۰
- TokenLat-qwen3.5-plus: ¤۱۳۰ / ¤۲۰
- TokenLat-deepseek-v4-Pro: ¤۵۶۰ / ¤۱۰ (کمترین هزینه خواندن از حافظه)
- TokenLat-glm-5.1: ¤۹۵۰ / ¤۱۶۰
- TokenLat-kimi-k3: ¤۳۰۰۰ / ¤۳۰۰
- gemini-3.1-pro: ¤۲۸۰۰ / ¤۳۰۰
- chatgpt-5.5: ¤۷۰۰۰ / ¤۷۰۰
رویتپذیری و اندازهگیری
شما نمیتوانید چیزی را بهینه کنید که نمیبینید. یک درگاه مناسب باید ردپای هر فراخوانی را ارائه دهد: REQUEST → AUTH → ROUTE(auto→text-pro) → RESPONSE → METER. یک خط کد باید منطقه (مثلاً SEA)، وضعیت (۲۰۰ OK)، تأخیر (۸۴۲ میلیثانیه)، توکنها (۱۲۸۴) و هزینه دقیق (¤۰.۰۰۴۸) را فاش کند. این کار مانع از آن میشود که تیمها برای جهش صورتحساب ماهانه حدس بزنند.
برای تأیید این صرفهجوییها، این دستورالعمل توصیه میکند که نمونهای از وظایف واقعی را از هر دو لایه عبور داده و خروجیها را بر اساس معیارهای موفقیت بسنجید و سپس برای تقسیمبندی نهایی تصمیم بگیرید. اکثر تیمها متوجه میشوند که «سقوط کیفیت» بسیار کمتر از آنچه میترسیدند است.
هزینه فعلی خود را به ازای هر وظیفه در عاملهایتان بررسی کنید تا ببینید آیا هزینهها را سریعتر از آنچه میخواهید مقیاسبندی میکنید یا خیر. شما میتوانید با درگاههای یکپارچه مانند tokenlat.com برای پیادهسازی مسیریابی خودکار، حفظ حافظه پنهان و بهرهگیری از ردیابی هزینه به ازای هر درخواست آزمایش کنید.
گام بعدی شما
- بررسی هزینه هر وظیفه در عاملهای فعلی خود کنید تا بفهمید آیا هزینههایتان سریعتر از رشد کاربرانتان در حال افزایش است یا خیر.
- با درگاههای یکپارچه نظیر tokenlat.com برای پیادهسازی مسیریابی خودکار و حفظ حافظه پنهان آزمایش کنید.
- یک نمونه کوچک از دادههای واقعی خود را به مدلهای ارزانتر منتقل کرده و صحت خروجی را با مدل پرچمدار مقایسه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو