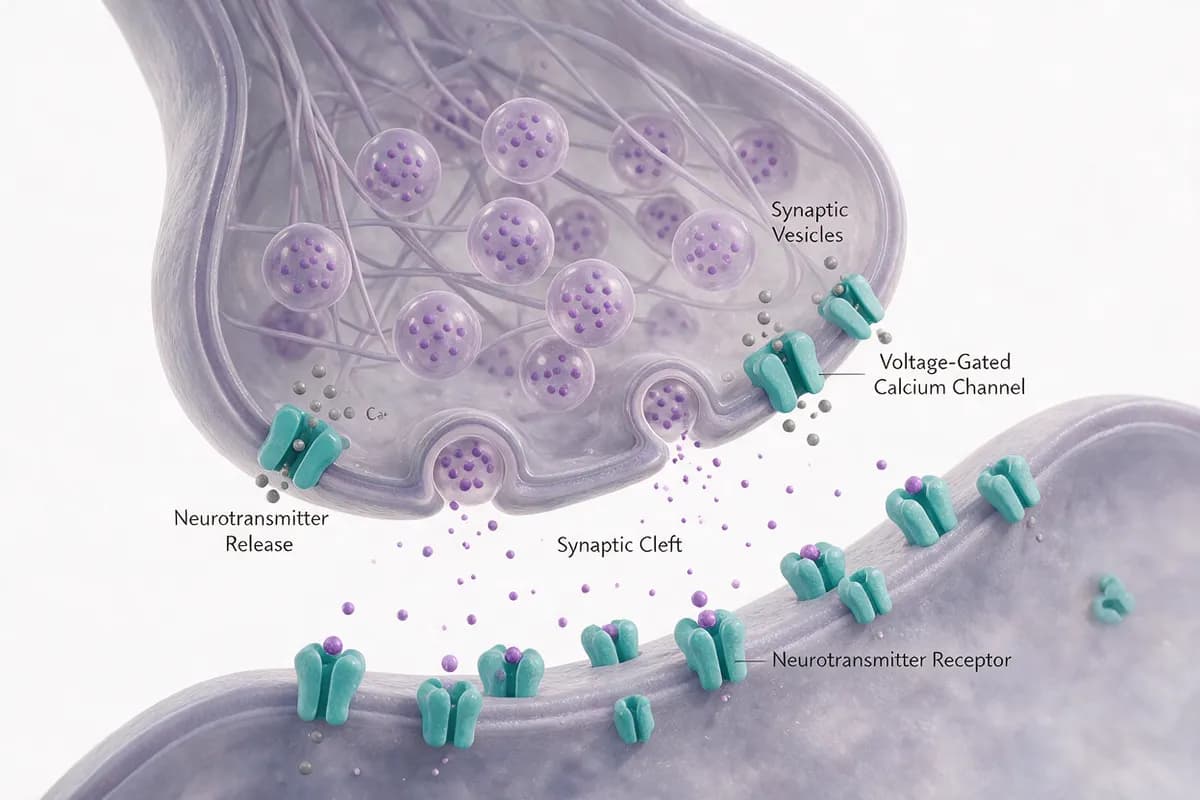
یک رندر با کیفیت بالا میتواند یک خطای علمی بنیادی را بهراحتی پنهان کند. در ۲۸ ژوئیه ۲۰۲۶، توسعهدهنده ابزار Scientific Figure Generator از یک چرخش استراتژیک در تصویرسازی با هوش مصنوعی پرده برداشت تا این ریسک را مدیریت کند: حرکت از پرامپتهای ساده تبدیل متن به تصویر (text-to-image) به سمت یک «مشخصات فنی» (specification) سختگیرانه برای شکلها. در این رویکرد، تصویر نهایی به عنوان آخرین مرحله در نظر گرفته میشود، نه هدف اولیه.
مشکل پرامپتهای ساده
بیشتر کاربران صرفاً از هوش مصنوعی میخواهند که «یک مسیر» (Pathway) — مثلاً مسیر MAPK — را رسم کند. این کار باعث میشود تصمیمات حیاتی بیان نشده باقی بمانند: کدام شاخه اهمیت دارد؟ کدام نوع سلول مورد بحث است؟ آیا یک فلش به معنای فعالسازی است، انتقال است یا صرفاً ترتیب مراحل را نشان میدهد؟
این رویکرد اغلب نتایجی «از نظر علمی بیفایده» تولید میکند که ظاهر صیقلخوردهای دارند اما فاقد دقت واقعی هستند. در واقع، مدل این تصمیمات گمشده را خودش میگیرد و آنها را زیر پیکسلهای جذاب پنهان میکند، بدون اینکه کاربر متوجه شود چه فرضیاتی در پسزمینه شکل گرفته است. این چالش با آنچه در معماریهای جایگزین برای تولید مجموعههای تصویری سازگار دیدیم همسو است، جایی که پرامپتهای متنی برای دستیابی به دقت و ثبات لازم ناکافی بودند.
از پیکسلها به مشخصات فنی
همانطور که در تحلیلهای پیشین ما دربارهی مبارزه با توهمات در مدلهای زبانی اشاره کردیم، مشکل اصلی در اینجا نبودِ لایه اعتبارسنجی پیش از خروجی است. توسعهدهنده این ابزار در ابتدا روی رندرینگ تمرکز داشت؛ یعنی کیفیت خطوط، فاصلهها، رنگها و اندازه خروجی. اما طی یک هفته، تمرکز او تغییر کرد و متوجه شد که بررسی فلشها بسیار مهمتر از بررسی پیکسلهاست.
راهکار او، ایجاد یک سند مشخصات فنی کوچک است که تصمیمات مدل را پیش از آنکه رندر شوند، فاش میکند و آنها را برای بازبینی قرار میدهد.
به نقل از گزارش وبسایت dev.to، هسته این سازوکار یک «مشخصات شکل» (Figure Specification) است. یک طرحواره (Schema) معمولی در این سیستم شامل موارد زیر میشود:
- هدف (Purpose): یک هدف در حد یک جمله واحد. اگر هدف در یک جمله جا نشود، شکل به جای کوچک کردن برچسبها، به دو بخش تقسیم میشود (مثلاً: «نشان دادن اینکه چگونه مهار MEK سیگنالدهی ERK پاییندست را تغییر میدهد»).
- موجودیتها (Entities): لیستی دقیق و عینی از پروتئینها یا اجزا (مثلاً: «MEK»، «ERK»، «فاکتور رونویسی»).
- روابط (Relations): فهرستی از یالهای تایپشده که در آن هر فلش صریحاً برچسبگذاری شده است. برای جلوگیری از ادعاهای دروغین، نوع رابطه در این سیستم شامل مبدأ (from)، مقصد (to)، نوع رابطه (kind) مانند «فعالکننده»، «بازدارنده»، «انتقالدهنده» یا «مرحله بعدی»، و در نهایت «شواهد» (evidence) است.
- شواهد (Evidence): برچسبی که نشان میدهد اتصال مذکور بر اساس دادههای اندازهگیری شده است، از ادبیات علمی استخراج شده یا یک فرضیه است.
- حذفیات (Exclusions): فهرستی صریح از مواردی که باید حذف شوند، مانند «شاخههای اندازهگیری نشده» یا «پروتئینهای لیست نشده».
بصریسازی معنایی و دسترسیپذیری
این ساختار مانع از شکستهای رایج هوش مصنوعی میشود؛ جایی که رندرر برای انتقال معنای مفهومی از قراردادهای بصری — مانند رنگ — استفاده میکند. از آنجا که رنگ در چاپ سیاه و سفید، پروژکتورهای ضعیف یا برای خوانندگانی با اختلال در بینایی رنگها (کوررنگی) ناپدید میشود، این گردشکار الزام میکند که سرِ فلشها و استایل خطوط، منطق اصلی را منتقل کنند. رنگ میتواند کمککننده باشد، اما نباید تنها حامل معنا باشد. اتکا به مختصات و ساختار دقیق بهجای توصیفات کلی، یادآور رویکرد Oxlo.ai در تبدیل زبان طبیعی به مختصات مکانی برای قطعهبندی تصویر است تا دقت خروجی تضمین شود.
تفکیک شواهد از توضیحات
مقالات علمی انواع مختلفی از تصاویر را با هم ترکیب میکنند: نمودارها برای اندازهگیریها، میکروسکوپی برای مشاهدات و دیاگرامهای مکانیسمی برای توضیحات. این سیستم اجازه نمیدهد یک تصویر تولیدشده توسط AI، «سلطه بصری» (Visual Authority) دادههای اندازهگیری شده را قرض بگیرد.
برای مثال، یک مدل مفصل از گیرندهها نباید دقت ساختاریای را القا کند که هرگز اندازهگیری نشده است، و یک برش آناتومیک کلی نباید به گونهای به نظر برسد که گویی مختص به یک بیمار خاص است.
برای مدیریت این موضوع، توسعهدهنده دستههای منبع را به هر المان متصل میکند:
- اندازهگیری شده در کار فعلی
- پشتیبانی شده توسط ادبیات علمی ذکر شده
- تفسیر یا فرضیه
- صرفاً جهتنما (Orientation)
این دستهها میتوانند ضخامت خطوط، برچسبها و ارجاعات را تغییر دهند. برای اشکال توضیحی، هنر خطی ساده (Plain line art) اغلب به رندرهای سینمایی ترجیح داده میشود تا فضای کمتری برای ادعاهای تصادفی و اشتباه باقی بماند.
حلقه اعتبارسنجی
اعتبارسنجی از طریق یک حلقه چهارمرحلهای «خستهکننده» انجام میشود که به گونهای طراحی شده تا دقت را به زیبایی ترجیح دهد:
۱. توپولوژی: آیا ساختار پایه درست است؟
۲. برچسبها: آیا با متن مقاله یا منبع تطبیق دارند؟
۳. معنای فلشها: آیا میتوان هر فلش را توضیح داد و توجیه کرد؟
۴. اندازه نهایی: آیا شکل در اندازه خروجی (Export size) خوانا است؟
توسعهدهنده اشاره میکند که یک شکل که در مرورگر راحت دیده میشود، اغلب در یک مقاله علمی دو-ستونه فرو میپاشد. در حالی که یک غلط املایی با یک ویرایش محلی درست میشود، اما یک خطای توپولوژیکی کل شکل را به مرحله مشخصات فنی بازمیگرداند تا از ابتدا بازسازی شود.
پیادهسازی و محدودیتها
ابزارهای هوش مصنوعی زاینده (Generative AI) — شبیه نقاشی سریع یک طراح که فقط کلیات را میکشد تا ایده منتقل شود — در ترسیم طرحهای مکانیسمی، جریانهای کاری آزمایشگاهی، مفاهیم تجهیزاتی و پیشنویسهای اولیه گرافیکی (Graphical Abstracts) عالی هستند. آنها هزینه رسیدن از یک بوم خالی به یک بحث تیمی را کاهش میدهند.
با این حال، این ابزارها جایگزین بدی برای نمودارهای دادهمحور، تصاویر میکروسکوپی اصلی، تصاویر تشخیصی یا ساختارهای شیمیایی دقیق هستند. این موارد حتماً باید از نرمافزارهای تخصصی یا دادههای زیربنایی استخراج شوند.
این گردشکار اکنون در Scientific Figure Generator پیاده شده است که قادر به تولید هنر خطی، تصویرسازیهای تخت (Flat) و پیشنویسهای سه-بعدی است. قانون اصلی همچنان این است: اگر رابطهای در یک دیاگرام تولیدشده، منبع قابل تأییدی نداشته باشد، آن شکل برای انتشار آماده نیست.
با ورود عاملهای AI به استدلالهای پیچیده علمی، صنعت باید تصمیم بگیرد چه مقدار از متادیتای ساختاری را نمایش دهد. متادیتای خیلی کم منجر به اختراع روابط ساختگی میشود و متادیتای خیلی زیاد، یک فرم دستی خستهکننده ایجاد میکند. در حال حاضر، اولویت با اعتبارسنجی معنایی است، نه رندرینگ سینمایی.
گام بعدی شما
- اگر پژوهشگر هستید، برای دیاگرامهای مفاهیمی که نیاز به دقت بالا دارند، ابتدا یک «لیست روابط» (Relation List) بنویسید و سپس آن را به مدل بدهید.
- در بررسی خروجیهای AI، بهجای تمرکز بر زیبایی، ابتدا «معنای هر فلش» را به چالش بکشید.
- برای دادههای کمی، همچنان از ابزارهای تخصصی مانند Python یا Prism استفاده کنید و AI را فقط برای لایه بصری به کار ببرید.
اما تأثیر این رویکرد «مشخصاتمحور» بر سرعت تولید مقالات علمی چه خواهد بود؟ پاسخ را در تحلیل ما دربارهی عاملهای اتوماسیون پژوهشی بخوانید.



گفتگو