
اگر امروز از مدلهای زبانی برای تبدیل متن به SQL استفاده میکنید، احتمالاً با نتایجی مواجه شدهاید که از نظر سینتکس درستاند اما از نظر تجاری کاملاً غلط. مشکل اینجاست که یک پرسوجوی تحلیلی ۵۰۰ خطی، به دلیل پیچیدگی کد دشوار نیست، بلکه به این دلیل است که معنای تجاری آن در میان لایههای تودرتو و پیشفرضهای پنهان پراکنده شده است. معنا در این پرسوجوهای حجیم معمولاً در سطوح تجمیع، معیارهای مشتقشده، فیلترهای تجاری، منطق تاریخها، ابعاد با تغییرات کند (Slowly Changing Dimensions)، توابع پنجرهای (Window Functions)، نامهای مستعار و نامهای فنی ستونها پراکنده شده است. اسنوفلیک (Snowflake) برای حل این بحران، مفهوم «نماهای معنایی» (Semantic Views) را ترویج میکند؛ اشیایی در سطح طرح (Schema) که موجودیتها، روابط، ابعاد، حقایق و معیارهای تجاری را مدلسازی میکنند تا به عنوان یک لایه استدلالی برای عاملهای هوش مصنوعی (AI Agents) عمل کنند.
بسیاری از سازمانها پایگاهداده خود را مستقیماً به عنوان رابط اصلی برای هوش مصنوعی در نظر میگیرند، اما طرحهای خام برای مدل زبانی بزرگ (LLM) — که شبیه کتابخانهداری است که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — بیش از حد پیچیدهاند تا بتوان به طور قابلاعتمادی در آنها پیمایش کرد. این شکاف باعث ایجاد مشکلی به نام «پیچیدگی معنایی» میشود؛ جایی که هوش مصنوعی باید منطق تجاری را در لحظه از روی پیوندهای جداول خام و نام ستونهای فنی بازسازی کند. چالش واقعی این است که پیچیدگی فیزیکی یک سیستم داده به یک نمایش معنایی فشرده تبدیل شود که انسانها، سیستمهای BI و عاملهای هوش مصنوعی بتوانند روی آن استدلال کنند.
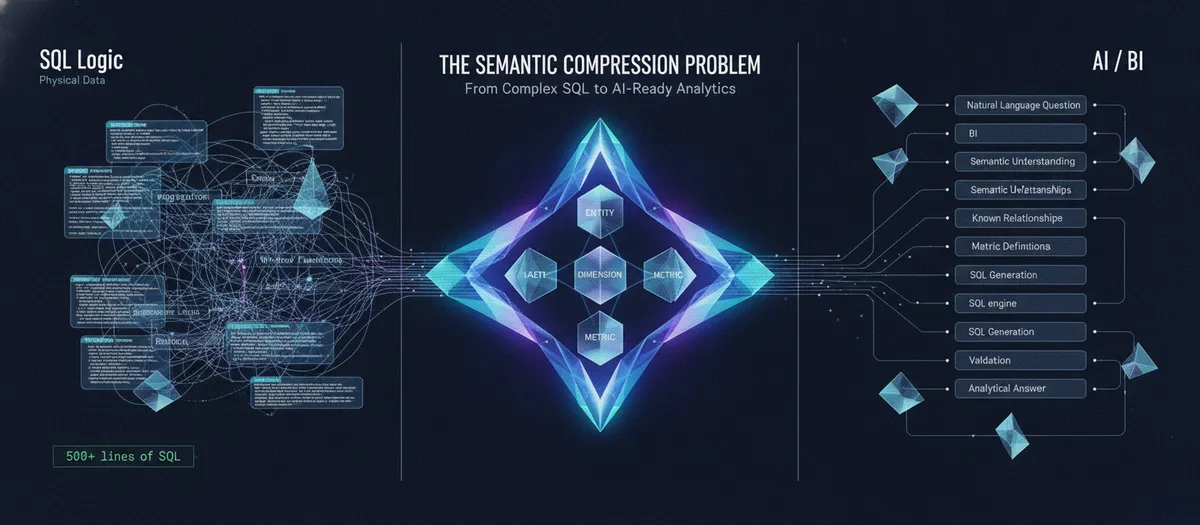
شکست رویکرد خام Text-to-SQL
به نقل از پژوهشهای حوزه تبدیل زبان طبیعی به SQL، درک جمله کاربر سادهترین بخش کار است. چالش اصلی در «پیوند طرح» (Schema Linking) و رمزگذاری است. محک (Benchmark) معروف Spider که هزاران پرسوجوی پیچیده را در ۲۰۰ پایگاهداده و ۱۳۸ دامنه مختلف بررسی کرد، نشان داد مدلها هنگام مواجهه با طرحهایی که قبلاً ندیدهاند، بهشدت دچار خطا میشوند.
همچنین طبق گزارش پژوهش RAT-SQL (منتشر شده در ACL ۲۰۲۰)، بدون نقشهبرداری صریح از روابط، سیستمهای هوش مصنوعی اغلب در شناسایی مسیرهای صحیح پیوند (Join) شکست میخورند. این پژوهش ثابت کرد که مدلها نمیتوانند به تنهایی مسیرهای ارتباطی بین جداول را در محیطهای پیچیده استخراج کنند. به همین دلیل است که تزریق ساده طرح پایگاهداده به پرامپت، در مقیاس سازمانی جواب نمیدهد. جریان معماری باید از «زبان طبیعی $\rightarrow$ قصد $\rightarrow$ مفاهیم معنایی $\rightarrow$ نقشهبرداری طرح $\rightarrow$ روابط $\rightarrow$ SQL» عبور کند. در همین راستا، برخی رویکردها بر استفاده از مدلهای وزنباز برای تحلیل معنایی در پایگاهدادههای مختلف تمرکز کردهاند تا دقت استنتاج در محیطهای متنوع افزایش یابد.
مکانیزم فشردهسازی معنایی
فشردهسازی معنایی به معنای کاهش محاسبات نیست، بلکه به معنای کاهش مقداری از «معنا» است که مصرفکننده باید بازسازی کند. SQL محاسبات را توصیف میکند، اما معناشناسی (Semantics) مفهوم را بیان میکند. برای مثال، عبارت SUM(unit_price * quantity) از نظر فنی یک تجمیع است، اما از نظر معنایی یعنی «درآمد ناخالص». اگر یک نرخ تخفیف به آن اضافه کنیم — SUM(unit_price * quantity * (1 - discount_rate)) — معنای آن به «درآمد خالص» تغییر میکند.
تصور کنید یک پرسوجوی تحلیلی با چندین CTE (عبارات جدول مشترک) داشته باشید: WITH orders AS (...), customers AS (...), products AS (...), daily_orders AS (...), customer_metrics AS (...), regional_metrics AS (...), ranked_products AS (...) SELECT .... حتی اگر این پرسوجو از نظر فنی درست باشد، کاربردپذیری ندارد. یک تحلیلگر جدید یا یک هوش مصنوعی باید بپرسد: کدام جدول نماینده مشتری است؟ دانه (Grain) سفارشات چیست؟ کدام پیوندها یک-به-چند هستند؟ کدام CTE صرفاً یک جزئیات پیادهسازی است؟ این همان هسته پیچیدگی معنایی است.
به جای قرار دادن یک تبدیل ۷۰۰ خطی در یک نمای واحد، مهندسان باید منطق را به دو دسته متمایز تقسیم کنند:
- پیادهسازی فیزیکی: این بخش شامل تبدیلهای موقت، حذف دادههای تکراری (Deduplication)، منطق Stage، CTEهای بهینهسازی، پیوندهای فنی و محاسبات میانی است که برای رسیدن به نتیجه نهایی لازم هستند اما معنای تجاری مستقیمی ندارند.
- معناشناسی تجاری: این بخش شامل موجودیتهای تعریفشده مثل «مشتری فعال» یا معیارهایی مانند «درآمد خالص»، «سود» و «نرخ تبدیل» است که مستقیماً با اهداف کسبوکار در ارتباطاند.
با نمایش تنها لایه معنایی به هوش مصنوعی، سیستم از یک جریان هرجومرجآمیز «LLM $\rightarrow$ طرح خام» به یک خط لوله ساختاریافته «قصد $\rightarrow$ مفهوم معنایی $\rightarrow$ SQL» تبدیل میشود. هدف این لایه پنهان کردن SQL نیست، بلکه قرار دادن معنای درست در بالای آن است تا مدل زبانی مجبور نباشد هر بار منطق تجاری را از صفر استنتاج کند.
مهندسی لایه معنایی و مفهوم Grain
مدلسازی معنایی موثر با تعریف دانه (Grain) شروع میشود؛ یعنی دقیقاً مشخص شود هر سطر چه چیزی را نمایندگی میکند. این موضوع بنیادیتر از سینتکس است. برای مثال:
orders$\rightarrow$ هر سطر یک سفارشorder_items$\rightarrow$ هر سطر یک قلم کالا در سفارشcustomers$\rightarrow$ هر سطر یک مشتریdaily_sales$\rightarrow$ هر سطر برای هر مشتری/محصول/روز
اگر تحلیلگر بدون رعایت Grain، جداول سفارشات، اقلام و رویدادها را پیوند دهد، یک SUM(order_amount) ساده میتواند بهطور ناخواسته چند برابر شود. اگر یک سفارش شامل ۴ قلم کالا باشد و هر قلم ۳ رویداد داشته باشد، یک پیوند بیدقت ۱۲ سطر ایجاد میکند (۱ $\times$ ۴ $\times$ ۳) و درآمد را ۱۲ برابر نشان میدهد. نتیجه، پرسوجویی است که با موفقیت اجرا میشود اما از نظر معنایی غلط است و منجر به تصمیمات تجاری اشتباه میشود.
برای جلوگیری از این فاجعه، معماری باید دادهها را به چهار مفهوم درجه اول تبدیل کند:
- موجودیتها (Entities): اشیای اصلی کسبوکار (مثل مشتری، سفارش، محصول).
- ابعاد (Dimensions): ویژگیهایی برای فیلتر یا گروهبندی (مثل کشور، بخش، دستهبندی محصول).
- حقایق (Facts): مقادیر کمی خام (مثل مبلغ سفارش).
- معیارها (Metrics): محاسبات معتبر و مرجع (مثل میانگین ارزش سفارش، کل درآمد، تعداد سفارشات).
روابط و معیارهای درجه اول
یک مدل معنایی فراتر از یک دیکشنری است؛ این مدل نمایشی از روابط است. یک مسیر معمولی در تجارت الکترونیک میتواند اینگونه باشد: مشتری (۱:N) $\rightarrow$ سفارش (۱:N) $\rightarrow$ قلم سفارش (N:۱) $\rightarrow$ محصول. بدون این مسیرهای صریح، هوش مصنوعی مجبور است پیوندها را از روی نام طرحها حدس بزند که طبق تحقیقات، نقطه شکست اصلی در Text-to-SQL است. برای مثال، پاسخ به «درآمد بر اساس دستهبندی محصول» نیازمند یک مسیر معتبر است: درآمد $\rightarrow$ سفارش $\rightarrow$ قلم سفارش $\rightarrow$ محصول $\rightarrow$ دستهبندی. راهنمای نماهای معنایی اسنوفلیک بر تعریف صریح این روابط برای پاسخ به سوالات تجاری تأکید دارد.
معیارها باید به عنوان مفاهیم درجه اول تعریف شوند تا یکپارچگی تضمین شود. به جای اینکه هر تحلیلگر عبارت SUM(revenue) / NULLIF(COUNT(DISTINCT order_id), 0) را بنویسد، لایه معنایی این را به عنوان «میانگین ارزش سفارش» تعریف میکند. مدل فعلی اسنوفلیک از این معیارهای بازاستفادهپذیر و فیلترها پشتیبانی میکند تا هوش مصنوعی مجبور نباشد برای هر پرسوجو، تعریف جدیدی از «مشتری فعال» اختراع کند و از تضاد در گزارشات جلوگیری شود.
محدود کردن فضای خروجی هوش مصنوعی
مدلهای زبانی فضای خروجی عظیمی دارند، اما SQL گرامر سختگیرانهای دارد. پژوهش PICARD (EMNLP ۲۰۲۱) نشان داد که تجزیه افزایشی (Incremental Parsing) میتواند رمزگشایی را محدود کند تا تداومهای SQL حتماً معتبر باشند و از تولید سینتکس غلط جلوگیری شود. این روش باعث میشود مدل در هر گام تولید توکن، تنها گزینههایی را انتخاب کند که با گرامر SQL سازگار هستند.
در لایه معنایی، این یعنی هوش مصنوعی دیگر منطق تجاری را «اختراع» نمیکند. معماری اسنوفلیک از «پرسوجوهای تاییدشده» (Verified Queries) پشتیبانی میکند؛ یعنی جفتهای «سوال زبان طبیعی + SQL تایید شده» که به عنوان نمونههای Few-shot عمل کرده و استدلال مدل را محدود و دقیق میکنند. این یک پل ایجاد میکند: لایه معنایی + LLM + پرسوجوهای تاییدشده $\rightarrow$ تولید SQL محدود شده.
صحت معنایی در برابر عملکرد اجرایی
تفاوت حیاتی بین صحت معنایی و عملکرد اجرایی وجود دارد. یک مدل میتواند از نظر مفهومی کامل باشد اما پرسوجویی تولید کند که ترابایتها داده غیرضروری را اسکن کند و هزینههای پردازشی را به شدت افزایش دهد.
- صحت معنایی: تمرکز بر Grain درست، پیوندهای صحیح و تعاریف معتبر تجاری.
- عملکرد اجرایی: تمرکز بر حجم اسکن، هزینه پیوند، هزینه تجمیع، هرس دادهها (Pruning) و منابع انبار داده.
برای حل این تضاد، یک حلقه بازخورد لازم است: مدل $\rightarrow$ تولید SQL $\rightarrow$ تحلیل پروفایل (EXPLAIN) $\rightarrow$ بهینهسازی $\rightarrow$ تست مجدد معنایی. اسنوفلیک اجازه میدهد ابعاد و معیارهای خاص را Materialize کنند تا شکاف بین صحت و سرعت پر شود و نماهای تجاری باعث کرش کردن انبار داده یا کندی شدید سیستم نشوند.
قرارداد معنایی و استانداردهای پیادهسازی
در نهایت، یک نمای معنایی مانند یک قرارداد بین مهندسی داده، تحلیلگران و سیستمهای هوش مصنوعی است. این لایه دانه مرجع، روابط معتبر و فیلترهای اجباری را تعریف میکند. این امر مدلسازی معنایی را از یک وظیفه مستندسازی به یک دیسیپلین مهندسی نرمافزار تبدیل میکند که در آن تغییرات باید مدیریت شوند.
برای حفظ این قرارداد، لایه باید در هفت بعد تست شود:
۱. Grain: آیا هر جدول منطقی دارای دانهای است که به وضوح درک شده باشد؟
۲. صحت پیوندها: آیا هر رابطه پشتیبانیشده قابل اعتبارسنجی است؟
۳. صحت معیارها: آیا کل درآمد با محاسبات مرجع مطابقت دارد؟
۴. ایمنی تجمیع: آیا درآمد بر اساس منطقه با کل درآمد برابر است؟
۵. پوشش زبان طبیعی: آیا سیستم میتواند برای سوالات رایج مثل «۱۰ محصول برتر» یا «میانگین ارزش سفارش ماهانه» SQL درست تولید کند؟
۶. عملکرد: آیا SQL تولید شده منجر به حجم اسکن و زمان اجرای قابل قبول میشود؟
۷. رگرسیون: آیا تغییرات معنایی باعث شکست سوالات تاییدشده قبلی میشود؟
بهترین روشهای پیادهسازی
برای جلوگیری از ایجاد یک «جهان معنایی غولپیکر» که مدیریت آن غیرممکن شود، اسنوفلیک توصیه میکند نماهای معنایی حول دامنههای تجاری (مثل تحلیل فروش، تحلیل محصول، تحلیل مشتری) سازماندهی شوند، نه اینکه صرفاً آینه دیتابیس باشند. همچنین توصیه میشود با محدوده قابل مدیریت شروع کنید و از ستونهای نامرتبط بپرهیزید تا فضای جستجوی مدل کاهش یابد.
توصیفات (Descriptions) تزئینی نیستند؛ آنها زمینه استدلال هستند. توصیفی مثل «امتیاز» بیفایده است، اما «امتیاز رضایت مشتری که در مقیاس ۱ تا ۵ اندازهگیری شده و ۵ نشاندهنده بالاترین رضایت است» به هوش مصنوعی اجازه استدلال میدهد تا بفهمد اعداد بالاتر به معنای کیفیت بهتر هستند. راهنمای اسنوفلیک صراحتاً این توصیفات را یکی از مهمترین عناصر برای دقت مدل میداند.
علاوه بر این، لایه معنایی نباید محل تخلیه اشکالزداییهای ETL/ELT یا گزارشهای یکباره باشد. خط لوله باید تمیز بماند:
ورود خام $\rightarrow$ پاکسازی $\rightarrow$ حذف تکراریها $\rightarrow$ نرمالسازی $\rightarrow$ تبدیلهای تجاری $\rightarrow$ دادههای منتخب $\rightarrow$ لایه معنایی $\rightarrow$ برنامههای AI/BI.
یک الگوی معنایی کاربردی
در یک پیادهسازی واقعی، یک نمای معنایی دادهها را به یک مشخصات ساختاریافته (شبیه YAML) تجزیه میکند. برای یک مدل sales_analytics این موارد شامل است:
- جداول: تعریف
customers(یک سطر برای هر مشتری) وorders(یک سطر برای هر سفارش) با کلیدهای اصلی برای تضمین یکتایی. - ابعاد: نقشهبرداری
countryیاsegmentبه عبارات مربوطه برای گروهبندی. - حقایق: شناسایی
order_amountبه عنوان مقدار پولی خام که پایه تمام محاسبات است. - معیارها: تعریف
total_revenueبه عنوانSUM(order_amount)وorder_countبه عنوانCOUNT(DISTINCT order_id).
با انتقال پیچیدگی به مرز معماری درست، سازمانها دیگر از هوش مصنوعی نمیخواهند که کل پایگاهداده آنها را بفهمد، بلکه به آن نقشه دقیقی از معنایی میدهند که برای پاسخ به یک دسته خاص از سوالات نیاز دارد.
گام بعدی شما
- اگر از LLM برای تولید SQL استفاده میکنید، ابتدا یک لایه Semantic View ساده برای پرکاربردترین معیارهای خود تعریف کنید.
- توصیفات ستونهای خود را از کلمات تکسروه به جملات توصیفی تبدیل کنید تا Context مدل بهبود یابد.
- یک مجموعه از «پرسوجوهای تاییدشده» (Verified Queries) بسازید و آنها را به عنوان نمونه در پرامپتهای خود قرار دهید.
اما داستان سختافزاری این تحول و نحوه مدیریت حافظه در مقیاس پتابایت حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو