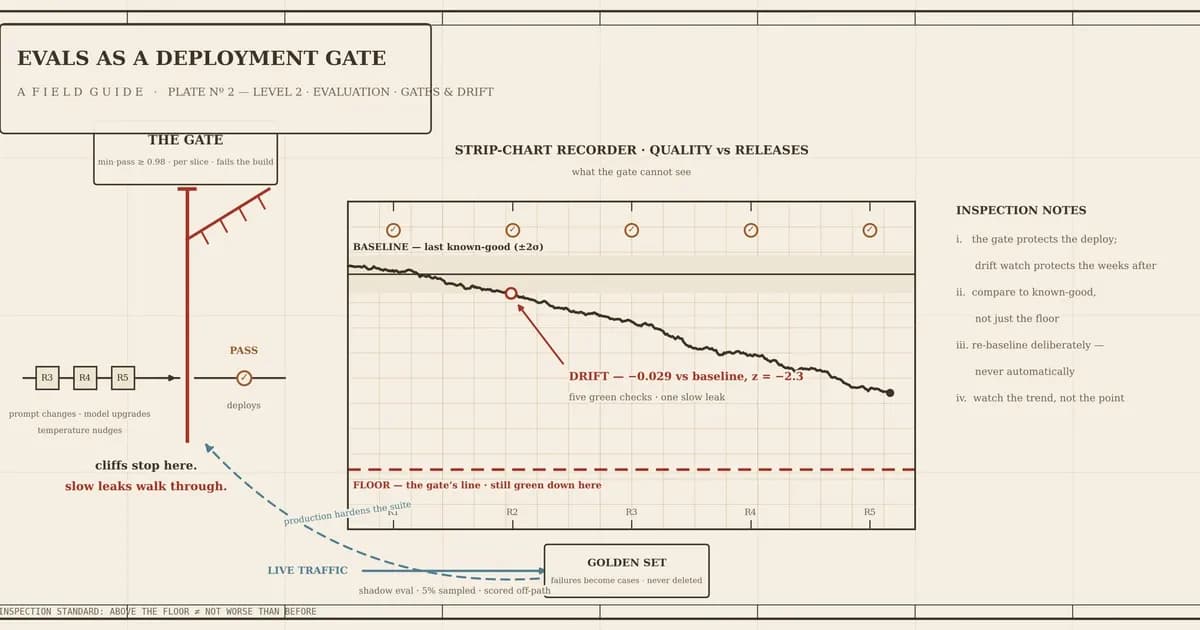
تصور کنید تغییری در پرامپت ایجاد میکنید که یک سناریو را بهبود میبخشد اما دو مورد دیگر را خراب میکند؛ اگر ارزیابی را به عنوان یک گیت در فرآیند ساخت قرار ندهید، این پسرفتها بهصورت خاموش وارد محیط عملیاتی میشوند. در ۷ اکتبر ۲۰۲۶، استک اورفلو (Stack Overflow) مدل بلوغی برای سامانههای مدل زبانی بزرگ (LLM) — شبیه کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — منتشر کرد که ارزیابی را از دفترچههای یادداشت (Notebooks) مجزا خارج کرده و مستقیماً به خط لوله یکپارچگی مداوم (CI) منتقل میکند. این رویکرد نشاندهنده سطح ۲ از مدل بلوغ است: ارزیابی. اصل موضوع ساده است: شما بر اساس امید استقرار نمیکنید، بلکه بر اساس یک گیت (دروازه) پیش میروید و سپس در جستوجوی انحراف هستید. همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تکیه بر تستهای پراکنده در محیطهای پیچیده همواره ریسک بالایی دارد.
بسیاری از تیمها در حال حاضر ارزیابیها را بهصورت دستی و اغلب پس از وقوع خطا در محیط عملیاتی انجام میدهند. این رویکرد برای سامانههای LLM ناکافی است زیرا خطرناکترین شکستها، باگهای کدنویسی نیستند، بلکه پسرفتهای خاموشی هستند که بر اثر تغییرات کوچک در پرامپت، ارتقای مدل یا تغییر دما (Temperature) رخ میدهند. طبق گزارش stackoverflow.blog، این تغییرات میتوانند بهطور نامحسوس کیفیت را در درصد کمی از ورودیها — مثلاً ۸٪ از کل درخواستها — کاهش دهند بدون اینکه هشدارهای سنتی فعال شوند. اگر میتوانید تغییری در پرامپت ایجاد کنید بدون اینکه ارزیابی باعث شکست ساخت (Build) شود، شما ارزیابی ندارید، بلکه فقط یک دفترچه یادداشت دارید. این چالش با رویکرد گوگل در چارچوب ADK همسو است که بر کاهش نرخ خطاهای عملیاتی از طریق ساختارمند کردن مجموعههای شکست تأکید دارد.
گیت استقرار
برای متوقف کردن این پسرفتها، اولین خط دفاعی یک گیت استقرار است. این گیت مجموعهای از موارد تست منتخب است — شامل سناریوهای رایج، موارد لبهای (Edge Cases) سخت و تمام شکستهای گذشته — که در کنترل نسخه به عنوان یک Diff قابل بررسی ذخیره میشوند. موارد پسرفت هرگز حذف نمیشوند؛ آنها حافظه دائمی شکستهای سامانه هستند.
هر مورد با استفاده از تأییدات صریح و تایپشده امتیازدهی میشود. برای مثال، یک مورد تست میتواند اینگونه تعریف شود:
- شناسه:
case-0412 - بخش (Slice):
tier1/en - انتظار: تصمیم «تأیید» با حداقل اطمینان ۰.۸۰
- محدودیت: شرط «نباید» برای تصمیم «حل خودکار»
- برچسبها:
edge-case,previously-broke
اگر نرخ موفقیت از یک آستانه تعریفشده (مثلاً ۹۸٪) پایینتر بیاید، خط لوله CI شکست میخورد و استقرار مسدود میشود. این فرآیند از طریق یک دستور CI اجرا میشود، مانند: eval run --suite golden --gate --min-pass 0.98 --baseline artifacts/baseline.json. اگر اجراکننده (Runner) متوجه شود که ۲۳۶ مورد از ۲۴۰ مورد موفق شدهاند (۹۸.۳٪)، گیت باز میشود؛ اما اگر نرخ به زیر ۹۸٪ سقوط کند، استقرار مسدود میگردد.
برای جلوگیری از اینکه میانگینهای کلی، شکستهای موضعی را پنهان کنند، سامانه از «بخشها» (Slices) استفاده میکند. با برچسبگذاری موارد بر اساس ویژگیهایی مثل زبان (Locale) یا نوع درخواست، گیت میتواند برای هر بخش بهطور مجزا عمل کند. این یعنی نرخ موفقیت کلی ۹۹٪ نمیتواند نرخ شکست ۷۰٪ در یک بخش حیاتی را بپوشاند. سامانه موارد را با استفاده از همان ویژگیهایی که در زمان اجرا (Runtime) به کار میروند به بخشهای مربوطه هدایت میکند تا هرگونه فاصله بین «آنچه تست میکنیم» و «آنچه اجرا میکنیم» از بین برود. این نوع تفکیک دقیق، مشابه تستهای ساختاری انویدیا است که برای جایگزینی ارزیابیهای حسی و ذهنی با معیارهای سختگیرانه در عاملهای هوش مصنوعی طراحی شده است.
شناسایی «نشتی آرام»
در حالی که گیتها «سقوطهای شدید» (Cliffs) — یعنی افتهای ناگهانی و شدید کیفیت — را میگیرند، نسبت به «نشتیهای آرام» (Slow Leaks) کور هستند. نشتی آرام زمانی رخ میدهد که کیفیت بهصورت تدریجی (مثلاً از ۰.۹۹۵ به ۰.۹۹ و سپس ۰.۹۸۵) در چندین نسخه کاهش یابد، در حالی که هر مرحله همچنان بالای کفِ حداقل باشد. در این حالت، گیت هر تغییر را عبور میدهد، اما وقتی شکست آشکار شود، سامانه پنج بار در وضعیت تضعیفشده استقرار شده است.
برای مقابله با این موضوع، استک اورفلو شناسایی انحراف را با مقایسه هر اجرا در برابر یک «خط مبنا» (Baseline) — یعنی معیارهای آخرین نسخه سالم — پیادهسازی کرده است. یک فایل خط مبنا (مانند baseline.json) میانگین، اندازه نمونه (n) و انحراف معیار را برای معیارهایی مثل تطابق دقیق (Exact Match) با مقدار ۰.۹۴۲ و نرخ بازبینی انسانی (Human Override Rate) با مقدار ۰.۰۶۰ ثبت میکند.
این فرآیند از یک رویکرد آماری سختگیرانه برای تفکیک سیگنال از نویز استفاده میکند:
- معیارهای نرخ: استفاده از z-test دو-نسبتی با یک نسبت تجمیعی (Pooled Proportion).
- معیارهای پیوسته: استفاده از خطای استاندارد (SE) تفاضل میانگینها.
- آستانههای معناداری: یک تغییر تنها زمانی علامتگذاری میشود که معنادار باشد (مثلاً تغییر ۰.۰۱ در تطابق دقیق) و بیش از ۲ سیگما (z > 2) در جهت منفی حرکت کند.
نکته کلیدی این است که سامانه از اشتباه رایج تقسیم انحراف معیار خط مبنا بر جذر n پرهیز میکند، زیرا این کار واریانس اجرای فعلی را نادیده میگیرد. در عوض، از اندازه نمونه هر دو اجرا استفاده میکند. این کار مانع از آن میشود که سامانه هنگام نمونهبرداری از ۵۰ تصمیم زنده در برابر یک خط مبنای ۲۴۰۰ ردیفی، نویزهای خالص را به عنوان خطا علامتگذاری کند. برای درک عمیقتر این تفکیک، مطالعات A/A راهکاری کلیدی برای جلوگیری از تعقیب نویزهای نمونهگیری و شناسایی بهبودهای واقعی مدلها ارائه میدهند.
حلقه ارزیابی سایه
از آنجا که مجموعههای طلایی (Golden Sets) محدود هستند، نمیتوانند هر غافلگیری محیط عملیاتی را پیشبینی کنند. لایه نهایی، یک حلقه ارزیابی سایه (Shadow Eval) است که درصد کمی از ترافیک زنده و بدون هویت (مثلاً ۵٪) را برای امتیازدهی خارج از مسیر اصلی نمونهبرداری میکند. این فرآیند از طریق یک پیکربندی به نام SHADOW_SAMPLE_RATE مدیریت میشود.
این حلقه بهجای نمونهبرداری تصادفی، از یک هش دترمینستیک (Deterministic Hash) برای شناسه تصمیم استفاده میکند تا بازتولیدپذیری تضمین شود و از تستهای ناپایدار (Flaky) جلوگیری شود. فرآیند به این ترتیب است:
۱. نمونهبرداری: انتخاب تصمیم با استفاده از یک هش دترمینستیک (مثلاً % 10000).
۲. امتیازدهی: اجرای تصمیم از طریق قوانین یا نقطه ورود امتیازدهی مدل داور بهصورت ناهمگام و خارج از مسیر اصلی پردازش (Off the hot path).
۳. ثبت: ردیابی نرخ موفقیت ارزیابی سایه (shadow_eval_pass_ratio) برای هر بخش.
۴. ضبط: اگر حکم نهایی OK نباشد، تصمیم به صف بررسی اضافه میشود.
وقتی ارزیابی سایه شکستی را شناسایی میکند، آن مورد عملیاتی بهطور خودکار به مجموعه طلایی بازگردانده میشود تا سامانه دقیقاً در نقاط سختِ واقعیت، مقاومتر شود.
نظارت بر بوی انحراف
فراتر از نرخ موفقیت، این چارچوب «بوهای انحراف» (Drift Smells) خاصی را رصد میکند که پیش از نمایش کامل در معیارها، سیگنال افت کیفیت هستند:
- نرخ بازبینی انسانی: افزایش مواردی که انسانها تصمیمات عامل (Agent) را لغو و معکوس میکنند.
- توزیع اطمینان: روند نزولی در سطح اطمینان، یا افزایش سطح اطمینان در حالی که صحت پاسخها کاهش مییابد (کالیبراسیون غلط).
- نسبت اختلاف داوران: افزایش مواردی که یک مدل «داور» دوم، تصمیم مدل اصلی را رد میکند.
- نرخ امتناع: زمانی که سامانه بیش از حد معمول از پاسخ دادن امتناع کرده یا پاسخ را به کاربر واگذار میکند (Punting).
وقتی یک «بو» شناسایی میشود، تیم آن را به یک بخش یا قابلیت خاص محدود کرده، علت را (مانند بهروزرسانی مدل یا تغییر در ورودیها) پیدا میکند و از طریق فرآیند تغییرات معمول آن را اصلاح مینماید.
تلههای رایج در ارزیابی
برای حفظ یک سامانه ارزیابی بالغ، تیمها باید از چندین تله دوری کنند:
- ارزیابی در Notebook: اگر تست در CI باعث شکست ساخت نشود، در زمان حساس اجرا نخواهد شد.
- تأییدات بر اساس اطمینان: اندازهگیری سطح اطمینان بهجای صحت؛ شما باید بسنجید که آیا مدل واقعاً درست گفته است یا خیر.
- حذف موارد باگ: حذف تستهای مربوط به باگهای رفعشده، مجموعه پسرفت شما را نابود میکند.
- نرخ موفقیت کلی: تکیه بر یک عدد واحد که شکستهای بخشهای کوچک را میپوشاند.
- گیتهای مبتنی بر کف: تکیه صرف به حداقلِ مجاز، که اجازه عبور نشتیهای آرام را میدهد.
- نمونهبرداری تصادفی (RNG): استفاده از اعداد تصادفی در مسیر ارزیابی که باعث ناپایداری تستها میشود.
- بازتنظیم خودکار خط مبنا: بهروزرسانی خودکار Baseline که باعث میشود انحراف بهطور خاموش به «وضعیت نرمال» تبدیل شود.
- تماشای نقاط تک: نظارت بر ساعات بدِ تکگیر (نویز) بهجای نظارت بر لغزشهای دو هفتهای (انحراف).
این رویکرد ساختاریافته، مهندسی پرامپت (Prompt Engineering) — هنر سؤال درست پرسیدن، مثل کسی که میداند چطور از یک مشاور باتجربه بهترین جواب را بگیرد — را از یک قمار به یک فرآیند مهندسی پیشبینیپذیر تبدیل میکند. با ترکیب گیتهای CI برای شکستهای فوری، مقایسههای خط مبنا برای انحرافهای آرام و ارزیابیهای سایه برای غافلگیریهای عملیاتی، تیمها میتوانند سریع حرکت کنند بدون اینکه سامانههایشان بهطور خاموش خراب شود. برای کسانی که این سیستم را پیاده میکنند، حیاتیترین قانون این است که بازتنظیم خط مبنا (Re-baseline) را آگاهانه انجام دهند — تنها زمانی که نسخه جدید به عنوان یک نسخه «سالم» تأیید شده باشد.
گام بعدی شما
- تستهای ارزیابی خود را از محیطهای ایزوله به خط لوله CI منتقل کنید تا هیچ تغییری بدون تایید متقاطع استقرار نشود.
- برای هر قابلیت حساس، یک «بخش» (Slice) مجزا تعریف کنید تا افت کیفیت در گروههای کوچک کاربران توسط میانگین کلی پنهان نشود.
- یک سیستم ارزیابی سایه (Shadow Eval) برای نمونهبرداری از ترافیک زنده پیاده کنید تا موارد لبهای واقعی را به مجموعه تستهای خود اضافه کنید.
اما مدیریت هزینههای این حجم از ارزیابیها چالش بعدی است — به تحلیل ما دربارهی بهینهسازی هزینه استنتاج در مدلهای استدلالی مراجعه کنید.



گفتگو