تصور کنید بهجای اینکه ساعتها با تغییر کلمات در یک پرامپت بگردید تا رنگ یک گلبرگ عوض شود، مستقیماً خط کدی را که آن رنگ را تعیین میکند تغییر دهید. این دقیقاً همان تغییری است که سوریا ناردی (Surya Narreddi) در فرآیند تولید هنر با هوش مصنوعی ایجاد کرده است.
به نقل از گزارش منتشر شده در ۲۳ اوت ۲۰۲۶، این پروژه چرخهٔ «پرامپت بنویس و دعا کن» (prompt-and-pray) را با آموزش مدل برای نقاشی از طریق کدهای قابل ویرایش جایگزین میکند. در این روش، تولید استاتیک پیکسلها کنار گذاشته شده و خروجی نهایی یک طرح جاوااسکریپتی است که کاربر میتواند آن را به صورت دستی اصلاح کند. این رویکرد در واقع پاسخی به چالشهای مشابهی است که در مدلهای دیگر دیده شده؛ برای مثال، مدل Mio.2 نیز با تفکیک مراحل ایدهپردازی و اجرا سعی کرد بنبستهای رایج در پرامپتنویسی هنر انیمه را برطرف کند.
بسیاری از ابزارهای فعلی هنر AI را مانند یک جعبهٔ بسته میبینند؛ یعنی تصویر به عنوان یک خروجی نهایی و قفلشده در نظر گرفته میشود و تنها راه تغییر یک جزئیات کوچک، بازنویسی پرامپت و امید به دریافت نتیجهای متفاوت است. اما در رویکرد ناردی، کد همان اثر هنری (artifact) واقعی است. این یعنی شما میتوانید یک خط منطقی خاص را تغییر دهید تا ضربهٔ قلممو جابهجا شود، بدون اینکه نیاز باشد کل اثر از نو تولید شود.
این پروژه به بررسی یک پرسش عمیقتر میپردازد: چگونه میتوان یادگیری تقویتی (Reinforcement Learning یا RL) را در وظایف خلاقانه و طراحی به کار گرفت؟ یادگیری تقویتی زمانی به خوبی عمل میکند که پاداشها قابل تایید باشند؛ مثلاً در یک مسئله ریاضی، جواب یا درست است یا غلط، و در یک بازی، یا برنده میشوید یا بازنده. اما کیفیت زیباییشناختی هیچکدام از اینها نیست. در اینجا چالش به «تابع پاداش» منتقل میشود: اگر این تابع بیش از حد سختگیرانه باشد، مدل به یک نقطه تکراری همگرا میشود و اگر بیش از حد آزاد باشد، مدل دچار انحراف شده و مسیر خود را گم میکند.
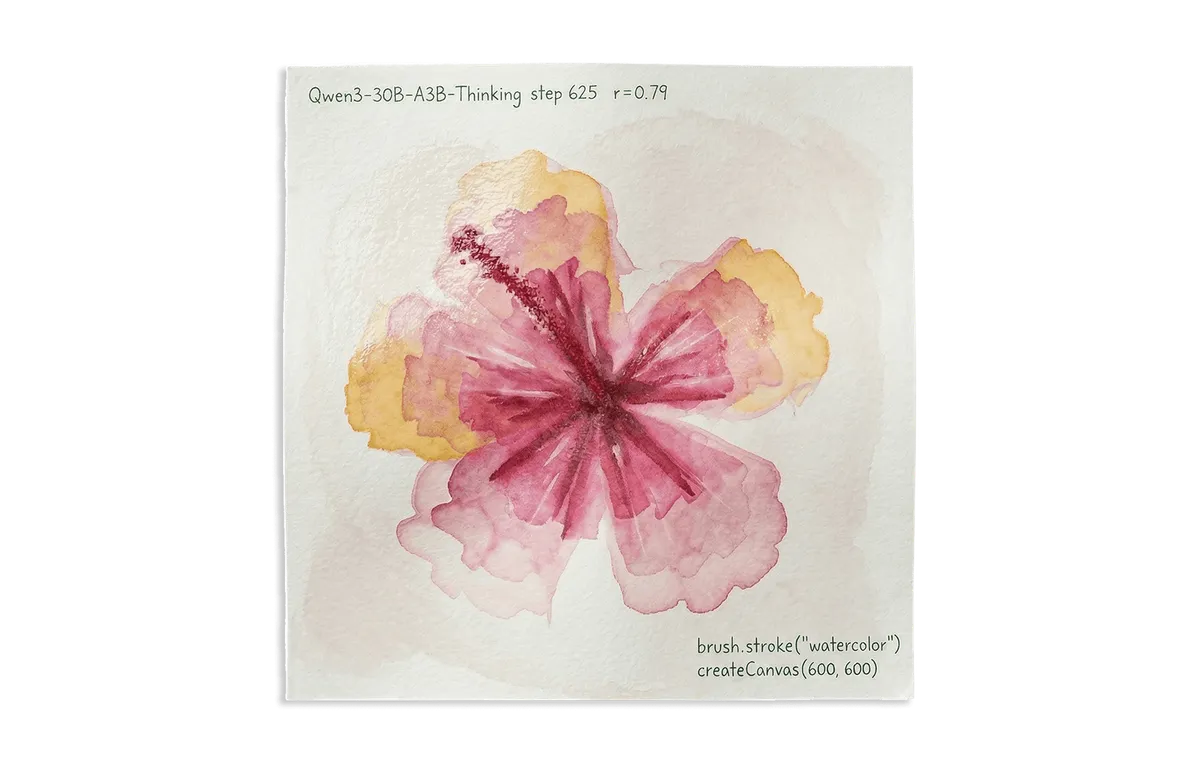
بر اساس مستندات surya.website، این سامانه از یک حلقهٔ آموزشی چهارمرحلهای استفاده میکند که هزاران بار تکرار شده است. مدل Qwen 3.5 35B یک پرامپت (مثلاً «یک گل ختمی هلویی با آبرنگ بکش») را دریافت کرده و یک طرح کامل به زبان p5.brush مینویسد. سپس این کد در محیط ایزولهی Puppeteer رندر شده و به یک تصویر PNG تبدیل میشود.
برای بهبود کیفیت خروجی، این سیستم از یک مکانیزم پاداش بسیار خاص استفاده میکند:
- قضاوت جفتی (Pairwise Judgment): یک مدل داور، تصویر PNG تولید شده را با دو نقاشی تصادفی از یک مجموعهی مرجع که قبلاً رتبهبندی شدهاند، مقایسه میکند. سپس یک مدل داور مجزا، بهترین اثر آبرنگ را انتخاب میکند.
- مجموعه مرجع (Reference Pool): این بانک داده شامل ۵۸۱ نقاشی مرجع است. این آثار از میان ۱۶۶۴ تولید اولیه استخراج و به صورت دستی رتبهبندی شدهاند؛ به طوری که ۱۱۷ اثر در دسته «عالی» (love-tier)، ۲۶۶ اثر در دسته «متوسط» (okay) و ۱۹۸ اثر به عنوان مکمل قرار گرفتند تا مجموعه مقایسهای در رنگهایی که نمونههای رتبهبندی شده کمی داشتند، گسترش یابد.
- خط لولههای تولید (Generation Pipelines): بهدلیل اینکه کتابخانه مورد استفاده یک ابزار تخصصی و نیچ (niche) است، مجموعه مرجع از خروجیهای مدل تشکیل شده است. این آثار از طریق دو خط لوله ایجاد شدند: اول AutoResearch (با استفاده از Opus 4.6، GPT-5.4 و Gemini 3.1 Pro که در برابر عکسها و تحت نظارت یک داور VLM تکرار شدند) و دوم یک اجرای دستهای بزرگتر روی Gemini 3.1 Pro.
- بهروزرسانیهای GRPO: نتایج این قضاوتها به یک سیگنال پاداش تبدیل میشود که از طریق روش بهینهسازی سیاست نسبی گروهی (Group Relative Policy Optimization یا GRPO) مدل را بهروز میکند.
ناردی متوجه شد که ارائه مستندات گسترده به مدل، در واقع مانع عملکرد آن میشود. نسخههای اولیه شامل یک مرجع API با ۴۰۰ خط بودند که باعث میشد مدل با اعتمادبهنفس زیاد، کدهایی بنویسد که از توابع و APIهای خیالی استفاده میکنند که اصلاً وجود نداشتند — یا همان توهم (Hallucination) — شبیه به دوستی که با اطمینان خاطرهای را تعریف میکند که هرگز اتفاق نیفتاده است.
راه حل این مشکل استفاده از GEPA بود؛ یک کتابخانه بهینهسازی پرامپت که دستورات را در برابر یک تابع امتیازدهی تکامل میدهد. تیم ناردی ۲۰۰ تکرار را در برابر یک داور ۷-شات (7-shot) که بر اساس سلیقه تنظیم شده بود، اجرا کردند. این فرآیند در نهایت به پرامپتی ختم شد که فقط یک «لیست مجاز» (allowlist) سختگیرانه شامل ۸ متد قلممو داشت و هیچ مستندات API یا مثالی را شامل نمیشد. نتیجه این بود که نرخ توهم بهشدت کاهش یافت؛ برای نخستین بار، سه بار متوالی از سه تلاش، مدل توانست لکههای قابل تشخیص گل ختمی تولید کند، آن هم درست بعد از اینکه مرجع ۴۰۰ خطی کاملاً حذف شد.
تغییر در تابع پاداش نیز حیاتی بود. روب ریک (Rubric) یا معیار ارزیابی اولیه از ۹ سیگنال مختلف استفاده میکرد: کامپایل (۵٪)، استفاده از قلممو (۵٪)، افزایش طول (۳۲٪)، HPSv3 (۱۰٪)، شورای داوران (۸٪)، تشخیص (۱۰٪)، زیباییشناسی (۱۵٪)، تکنیک (۸٪) و عمق (۷٪)، با ۵ داور در بازه ρ = 0.85–0.95. این معیار قدیمی سقف کیفیتی معادل ۰.۶۵ داشت.
اما روب ریک جدید این فرآیند را به چهار سیگنال ساده کرد: در این نسخه، مقایسهی جفتی با ۶۰٪ وزن غالب است، سپس HPSv3 با ۳۰٪ قرار دارد و در نهایت گیتهای کامپایل و طول کد هر کدام ۵٪ وزن دارند. این رویکرد سادهشده منجر به افزایش سقف کیفیت خروجیها شد.
برای یک خالق اثر، این یعنی هنر AI از یک «لاتاری» به یک «فرآیند طراحی» تبدیل شده است. اگرچه این روش کندتر از مدلهای انتشار (Diffusion Models) — مدلهایی که تصویر را از دل نویز بیرون میکشند — است، اما عاملیت انسان را بازمیگرداند. شما دیگر فقط یک مهندس پرامپت نیستید، بلکه ویراستار منطق زیربنایی اثر هستید. این تمرکز بر ساختار و منطق، یادآور اهمیت سیستمهای طراحی به عنوان لایهی حافظه برای حفظ انسجام در خروجیهای هوش مصنوعی است تا از هرجومرج بصری جلوگیری شود.
در سطح کلان یادگیری ماشین، این پروژه دشواری اعمال یادگیری تقویتی روی وظایف ذهنی و سوبژکتیو را برجسته میکند. چون ترجیحات زیباییشناختی قابل تایید ریاضی نیستند، «پاداش» باید به صورت دستی نوشته شود و با دقت طراحی شود تا بتواند تعمیم یابد. اگر پاداش بیش از حد خاص باشد، مدل فقط یاد میگیرد که نمونهها را کپی کند؛ و اگر بیش از حد آزاد باشد، مدل هیچ چیز یاد نمیگیرد.
ناردی قصد دارد گزارش فنی کامل این پروژه را در ژوئن ۲۰۲۶، پس از آخرین دورهی آموزش برای رفع ایرادات باقیمانده، منتشر کند.
گام بعدی شما
- اگر برنامهنویس هستید، کتابخانه p5.js را بررسی کنید تا با منطق نقاشی با کد آشنا شوید.
- در پروژههای AI خود، بهجای دادن مستندات حجیم، سعی کنید لیست محدودی از توابع مجاز (Allowlist) را به مدل معرفی کنید.
- تفاوت خروجیهای مبتنی بر پیکسل و مبتنی بر کد را در پروژههای بصری خود بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو