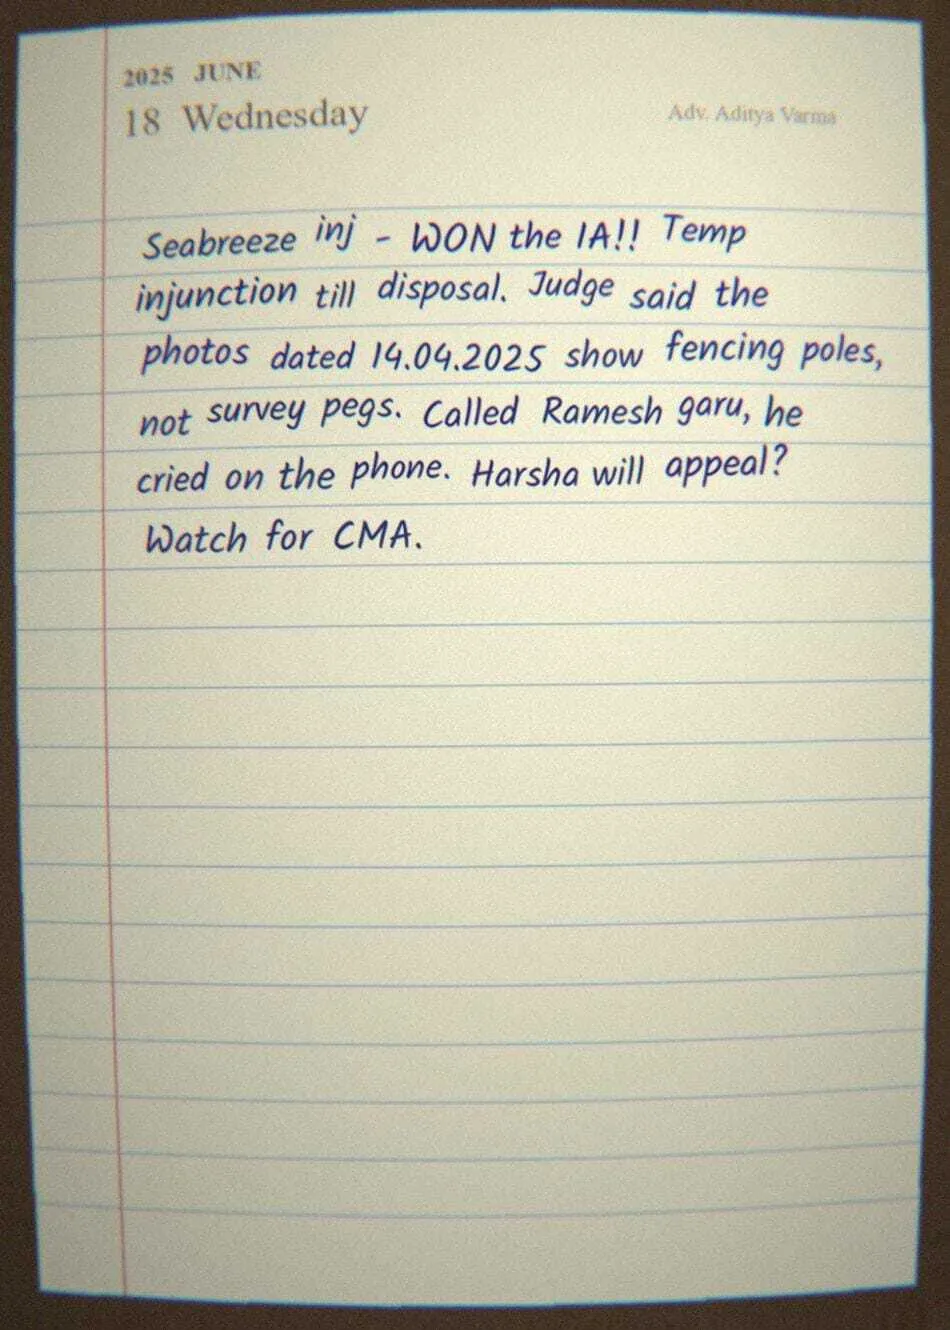
یک عدد لکهدار در دفترچه یادداشت یک وکیل میتواند یک غلط تایپی ساده را به دروغی دائمی و مستند تبدیل کند، اگر توسط یک عامل هوش مصنوعی پردازش شود. تصور کنید یک مدل بینایی، عدد ۸ در تاریخ «۱۸ ژوئن» را به اشتباه ۳ بخواند. در حالت عادی، این فقط یک غلط تایپی است. اما وقتی این داده در حافظه بلندمدت یک عامل ذخیره شود، به حقیقتی تبدیل میشود که عامل با اطمینان کامل، با ارجاع به یک تراشه منبع و با لحنی آرام، در برابر قاضی بیان میکند.
Tareekh، سامانهای تخصصی برای وکالای دادگاههای بدوی، این مشکل را با تغییر نگاه به مسیر تبدیل عکس به حافظه حل کرده است. در این سیستم، ثبت دادهها بهجای یک بهروزرسانی ساده در حافظه موقت (Cache Write)، مانند یک عملیات حساس ثبت در پایگاهداده (Database Commit) مدیریت میشود.
بسیاری از عاملهای هوش مصنوعی با حافظه بلندمدت مانند یک سطل ذخیرهسازی انعطافپذیر برخورد میکنند. اما در دنیای حقوق، یک تاریخ اشتباه صرفاً یک خطا نیست، بلکه یک نقص استنادی است که عامل آن را با اعتمادبهنفس مطلق به قاضی ارائه میدهد. این خطر زمانی تشدید میشود که وکلا پس از دیجیتالی شدن یادداشتهایشان، دیگر آنها را بازخوانی نمیکنند؛ به این معنا که انحراف حافظه (Memory Drift) اغلب نادیده گرفته میشود تا زمانی که منجر به یک فاجعه حرفهای گردد. این چالش با مسئلهی زوال حافظه در محیطهای صنعتی مشابه است، جایی که سیستم Validrift برای جلوگیری از اجرای دستورالعملهای قدیمی راهکارهایی را پیاده کرده است.
زمینه: واقعیت دادههای دادگاههای بدوی
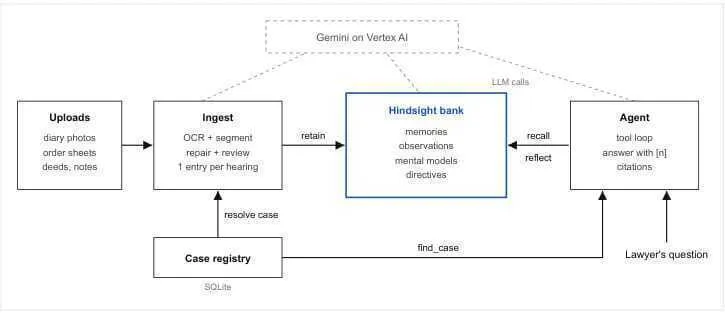
سامانه Tareekh در راستای حرکت صنعت به سمت حافظههای عاملمحور (Agentic Memory) قابلاعتمادتر، یک خط لوله چهارمرحلهای سختگیرانه شامل استخراج، قطعهبندی، ترمیم و بازبینی معرفی کرده است. این سیستم بهطور خاص برای مواجهه با واقعیتهای «ناهموار» دادگاههای بدوی هند طراحی شده است. ورودیهای سیستم هر چیزی است که وکیل در حال حاضر تولید میکند، که اغلب به معنای حجم عظیمی از کاغذها و قطعات دیجیتال پراکنده است:
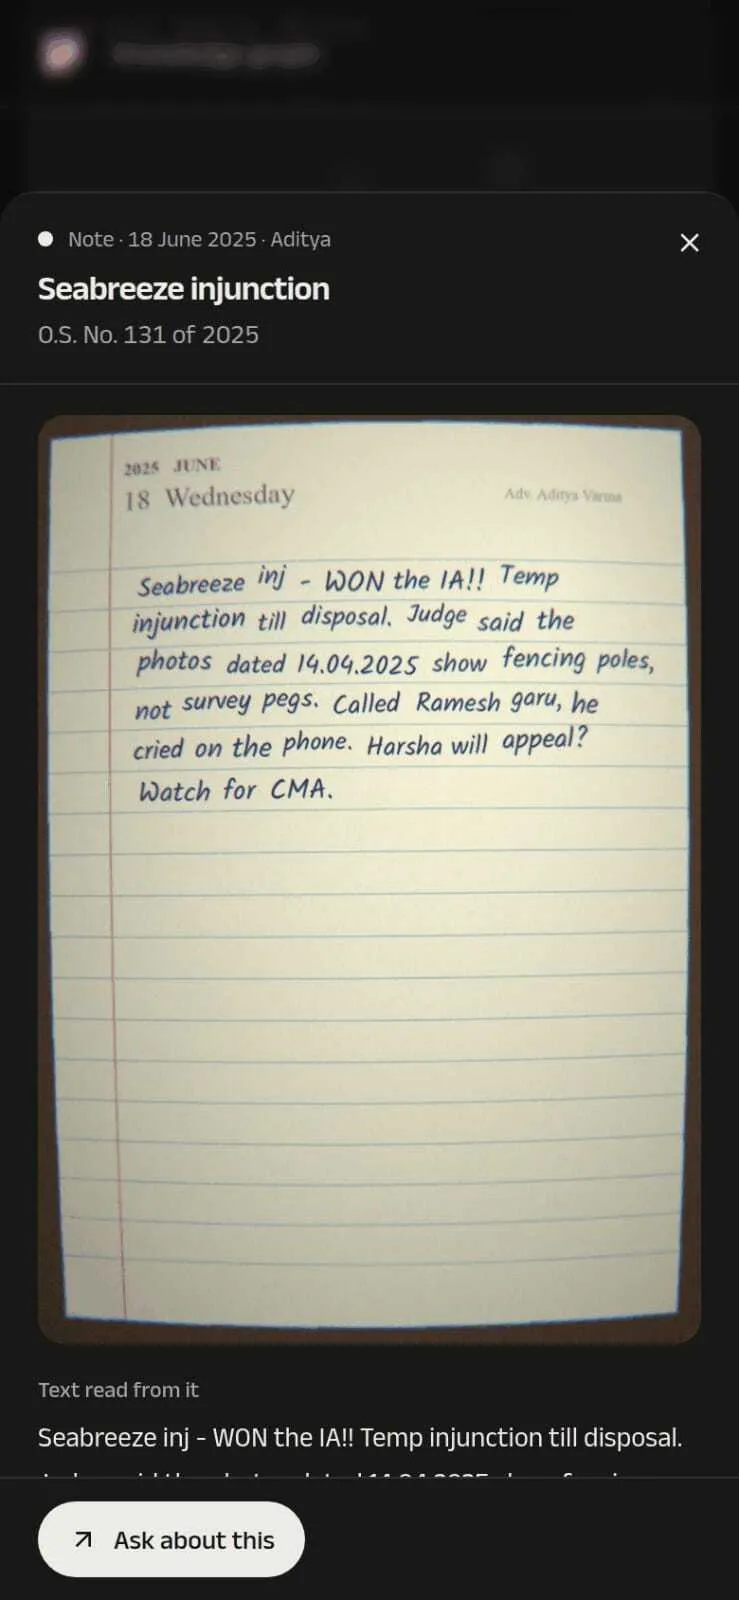
- عکسهای گوشی از صفحات دفترچههای یادداشت دستنویس، که اغلب با زاویه بد و زیر نور لامپهای مهتابی گرفته شدهاند.
- نسخههای تأییدشده از برگههای دستورات دادگاه (Order Sheets) که شامل چندین ردیف تاریخ در هر صفحه هستند.
- سوابق زمینهای 1-B، اسناد مالکیت و گواهیهای عدم تصرف (Encumbrance Certificates).
- ابلاغیههای قانونی، رسیدهای درخواستهای پلیس و خروجیهای چت واتساپ.
- یادداشتهای تایپی و متون کپیشده.
برای تست این سازوکار، از یک دفتر کار با ۷۹ فایل آپلودشده در ۵ پرونده مختلف استفاده شد. عکسهای دفترچه را عمداً با نقصهای بصری شدید انتخاب کردند؛ مواردی مانند اعوجاج بشکهای (Barrel Distortion)، ابیراسی رنگی (Chromatic Aberration)، وینیتینگ (Vignetting)، گوشههای تار، نویز سنسور در سایهها و تاریهای گاهبهگاه ناشی از لرزش دست. منطق طراحان این بود که اگر خط لوله فقط روی اسکنهای تمیز کار کند، در محیط واقعی میدان نبرد حقوقی کارایی نخواهد داشت.
فرآیند استخراج و قطعهبندی
اولین مرحله با یک مدل بینایی آغاز میشود که وظیفه دارد متن را دقیقاً همانطور که نوشته شده است، بازنویسی کند. برای جلوگیری از توهم (Hallucination) و اصلاحات خودسرانه مدل، در پرامپت صراحتاً هرگونه تفسیر یا توضیح اضافه ممنوع شده و به هوش مصنوعی دستور داده شده که کلمات خطخورده را نادیده بگیرد. دستور OCR_PROMPT بهطور مشخص تقاضا میکند که مدل ترتیب خطوط اصلی، اختصارات و اعداد (مانند شماره پرونده، تاریخها، مبالغ و شمارههای دفترچه) را دقیقاً همانگونه که ظاهر شدهاند حفظ کند. این کار مانع از آن میشود که اصلاح دستی یک وکیل — مثلاً خط زدن «سهشنبه» و نوشتن «پنجشنبه» — به اشتباه به عنوان دو تاریخ جلسه مجزا برای یک جلسه واحد ثبت شود.
در مرحله بعد، یک فراخوانی دوم از مدل زبانی بزرگ (LLM) دادههای خام را به ورودیهای ساختاریافته قطعهبندی میکند. مدل متن خام و فهرستی فشرده از ثبت پروندهها را دریافت کرده و ورودیهایی را در قالب {case_id, hearing_date, author, doc_type, text, confidence, reason} برمیگرداند. به این ترتیب، یک صفحه دفترچه که سه موضوع مختلف را پوشش میدهد، به سه ورودی مجزا تبدیل میشود. مدل باید بتواند اصطلاحات کوتاه و مبهم — مانند «beach land» یا «Gorle» یا «OS 214/24» — را به یک شناسه پرونده (Case ID) خاص متصل کند، بدون اینکه شناسههای جدیدی از خودش اختراع کند.
ترمیم قطعی و گیت بازبینی
برای مقابله با تمایل مدلهای زبانی به اعتمادبهنفس بیش از حد، Tareekh از یک تابع ترمیم قطعی (Deterministic Repair) استفاده میکند. این تابع خالص (Pure Function) نتایج مدل را با حقایق شناختهشده میسنجد. نکته حیاتی این است که کد هرگز امتیاز اطمینان (Confidence Score) را بالا نمیبرد، بلکه فقط آن را کاهش میدهد؛ زیرا امتیازهای گزارششده توسط LLM کالیبره نیستند و قابل اعتماد نیستند.
- اعتبارسنجی ثبت: اگر یک شناسه پرونده در فهرست شناختهشده یافت نشود، مقدار آن به None تغییر میکند. اگر یک تطبیق تقریبی (Fuzzy Match) از طریق
registry.find_casesپیدا شود، امتیاز اطمینان توسط نمره تطبیق محدود (Cap) میشود. - جایگزینهای تاریخ: تاریخهایی که از نام فایلها استخراج میشوند (مثلاً
IMG_20250618...) حداکثر امتیاز اطمینان ۰.۷۵ میگیرند. - شکستهای بحرانی: هر ورودی که فاقد شناسه پرونده یا تاریخ باشد، بهطور خودکار به امتیاز اطمینان ۰.۳ سقوط میکند.
- بازنویسی نوع فایل: اگر فایل آپلودشده یک تصویر باشد، سیستم دستور مدل را نادیده گرفته و ورودی را به عنوان «یادداشت دستنویس» علامتگذاری میکند؛ در واقع سیستم «دستنویس بودن» را به عنوان یک حقیقت درباره فایل در نظر میگیرد، نه قضاوتی درباره محتوا.
این فرآیند به «گیت بازبینی» (Review Gate) ختم میشود که حیاتیترین بخش معماری است. هر ورودی ابتدا در وضعیت بازبینی قرار میگیرد. بهطور پیشفرض، هر آپلودی که حاوی حتی یک ورودی با امتیاز اطمینان زیر ۰.۸ باشد، برای دخالت انسانی متوقف میشود. این یک رویکرد «همه یا هیچ» برای هر آپلود است: اگر یک ورودی در یک صفحه دفترچه مشکوک باشد، دو ورودی دیگر آن صفحه نیز نگه داشته میشوند. دلیل این سختگیری آن است که صفحهای که یک بار مدل را گیج کرده، احتمالاً در نقاط دیگر نیز باعث خطا شده است.
جلوگیری از «زبالههای با اعتمادبهنفس»
بدون این گیت، سیستم مستعد یک شکست خاص است: اشتباه گرفتن «تاریخ بعدی» (یک قرار ملاقات در آینده) با «تاریخ جلسه فعلی». از آنجا که عبارت «next date 5 Oct» اغلب با حروف بزرگ و برجستهترین متن صفحه است، یک LLM استاندارد معمولاً با اطمینان زیاد آن را به عنوان تاریخ رویداد برچسب میزند. در Tareekh، این اتفاق باعث فعال شدن پرچم بازبینی میشود. در فیلد دلیل (Reason) عبارت «تاریخ از نام فایل/راهنما» درج شده، امتیاز اطمینان روی ۰.۷۵ قرار میگیرد و وکیل میتواند آن را با یک ضربه اصلاح کند.
برای کاهش بیشتر این خطا، در پرامپت قطعهبندی اکنون صراحتاً ذکر شده است: «تاریخهایی مانند 'next date 5 Oct' تاریخ جلسه نیستند». گیت بازبینی دقیقاً برای آپلودهایی طراحی شده که نیاز به چشم انسان دارند: سربرگهای تار، صفحاتی که به دو پرونده با نام طرفین مشابه اشاره دارند، یا اسنادی که همزمان سه دعوای مختلف را پوشش میدهند.
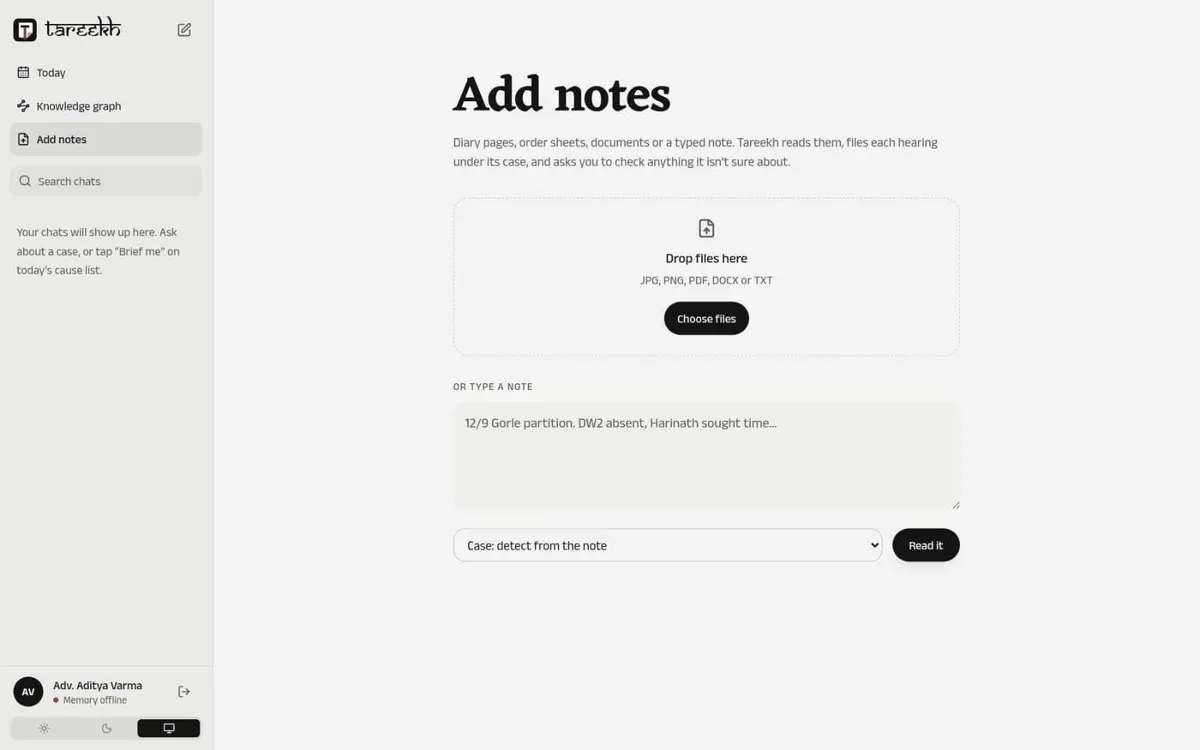
پس از تأیید، دادهها در Hindsight ذخیره میشوند؛ سیستمی که حقایق را در قالب مشاهدات و مدلهای ذهنی یکپارچه میکند. این رویکرد در مدیریت تضادهای دادهای مشابه است با آنچه معماری DealMind AI برای شناسایی تناقضات رفتاری مشتریان به کار گرفته است. از آنجا که Hindsight این حقایق را خلاصه و پیوند میزند، یک خطای OCR ساده در غیر این صورت در تمام خلاصههایی که عامل ایجاد میکند پخش میشد. برای تضمین پایداری، فرآیند تأیید (confirm) ورودیها را بر اساس (case_id, hearing_date) ادغام میکند تا از رد شدن شناسههای سند تکراری جلوگیری شود و با تنظیم retain_async=True برای مدیریت محدودیتهای نرخ ارائهدهنده (Rate Limits) از طریق یک صف اجرا میشود.
شبکه ایمنی پیوند به منبع
برای تضمین شفافیت کامل، هر حافظه یک لینک دائمی به منبع خود از طریق metadata.source_file و upload_id حفظ میکند. رابط کاربری خواننده یادداشتها، عکس اصلی را دقیقاً بالای متن استخراجشده نمایش میدهد. این به کاربر اجازه میدهد هر حقیقت مشکوکی را فوراً با نگاه به جوهر اصلی روی کاغذ تأیید کند و لایهای نهایی از ایمنی ایجاد کند که از هر آستانه عددی اطمینانی فراتر میرود.
علاوه بر این، سیستم آپلودهای مجدد را ایمن کرده است. با تعریف document_id = upload:case:date، اصلاح یک اشتباه و تأیید مجدد، حافظه موجود را جایگزین میکند، بهجای اینکه یک حافظه متناقض دوم در کنار آن اضافه کند.
این معماری تمرکز را از بهینهسازی بازیابی (Retrieval Optimization) به یکپارچگی استخراج (Extraction Integrity) منتقل میکند. فرض بر این است که لایه حافظه هر چه به آن داده شود را با وفاداری خلاصه میکند، به این معنی که «ورودی زباله» بهناچار به «خروجی زباله با اعتمادبهنفس بالا» تبدیل میشود. برای توسعهدهندگانی که سیستمهای عاملمحور میسازند، این بدان معناست که مرحله استخراج شایسته همان مقدار تلاش طراحی است که مرحله بازیابی دریافت میکند. اعتبارسنجی دادهها پیش از ثبت، تنها راه جلوگیری از تبدیل شدن یک عامل به منبعی از اطلاعات نادرست اما صیقلخورده و روان است.
برای مشاهده اینکه این رویکرد چگونه با ایندکسهای برداری استاندارد مقایسه میشود، میتوانید تعاریف گستردهتر حافظه عاملها را که توسط Vectorize ارائه شده است، بررسی کنید.



گفتگو