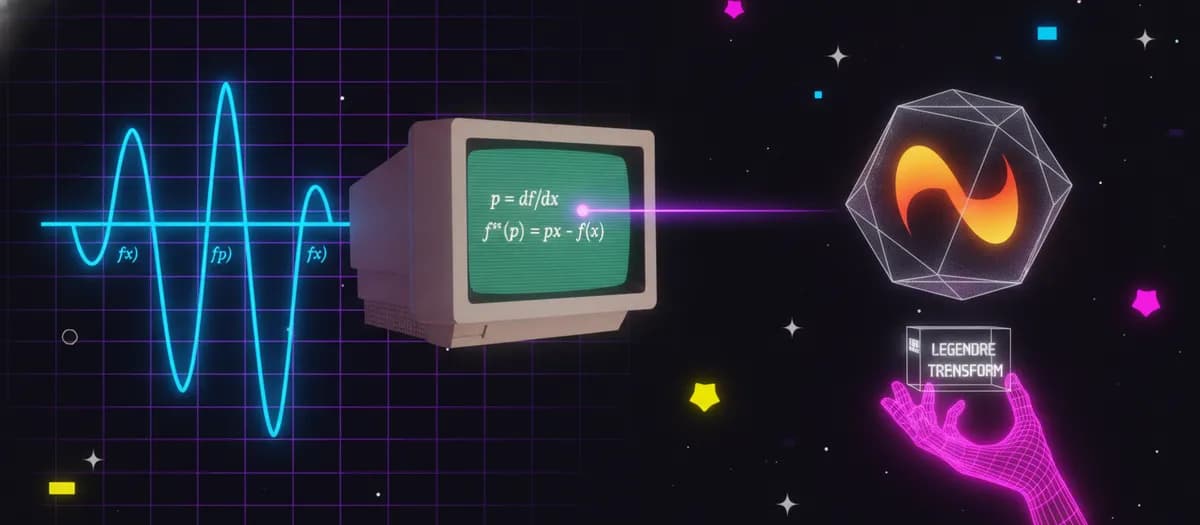
هر توکنی که ChatGPT تولید میکند، حاصل عملیاتی ریاضی است که ریشه در سال ۱۷۸۷ میلادی دارد. انتخاب کلمه بعدی توسط مدل، یک اتفاق مهندسی نیست، بلکه کاربرد مستقیم «تبدیل لژاندر-فنچل» (Legendre-Fenchel transform) است؛ ابزاری برای جابجایی بین دو توصیف متفاوت از یک ساختار محدب.
بسیاری از توسعهدهندگان به لایه سافتمکس (Softmax) — شبیه به یک فیلتر که اعداد خام را به درصدهای قابلفهم تبدیل میکند — بهعنوان یک ترفند ساده برای جمع احتمالات به عدد ۱ نگاه میکنند. اما بر اساس تحلیل فنی منتشر شده در ۲ جولای ۲۰۲۶، این لایه در واقع دوگانهی «آنتروپی منفی» است. همین رابطه هندسی است که به مدل اجازه میدهد میان دقت و خلاقیت، تنها با یک لغزنده دمای ساده تعادل ایجاد کند.
درک این سازوکار، پلی میان ترمودینامیک کلاسیک، آمار و هوش مصنوعی مدرن میزند. این نگاه، «جعبه سیاه» لایهی خروجی مدل را به ماشینی پیشبینیپذیر تبدیل میکند که توزیعی را میجوید که بیشترین مقدار «لاجیت» مورد انتظار بهعلاوه آنتروپی را داشته باشد.
هندسه دوگانگی
همانطور که در تحلیلهای پیشین ما دربارهی معماری ترنسفورمرها اشاره کردیم، هر جزئیاتی در خروجی مدل، ریشه در بهینهسازیهای ریاضی دارد. در اینجا، قلب تپنده این فرآیند، تبدیل لژاندر است. در دنیای ریاضیات، یک ایده ممکن است با نامهای مختلف شناخته شود: در مکانیک به آن تبدیل لژاندر میگویند، در ترمودینامیک «انرژی آزاد» است و در شبکههای عصبی (Neural Network) — شبکهای از سلولهای کوچک، شبیه نقشهٔ مترو، که سیگنال را از ورودی به جواب میرساند — به نام سافتمکس شناخته میشود. در واقع، اینها تنها یک عملیات واحد هستند که لباسهای متفاوتی به تن کردهاند.
در کتابهای درسی، این تبدیل اغلب به شکلی معرفی میشود که برای دانشجویان دشوار است. به شما تابعی مانند $F(x)$ و فرمولی مثل $G(s) = s,x(s) - F\big(x(s)\big)$ داده میشود، که در آن $s = dF/dx$ شیب خط است. سپس معمولاً جملهای میآید که میگوید «به راحتی میتوان بررسی کرد که» $dG/ds = x$. آن علامت منفی «عجیب» و عبارت اضافی $sx$ برای این وجود دارند که معادله متقارن شود: $F(x) + G(s) = s,x$.
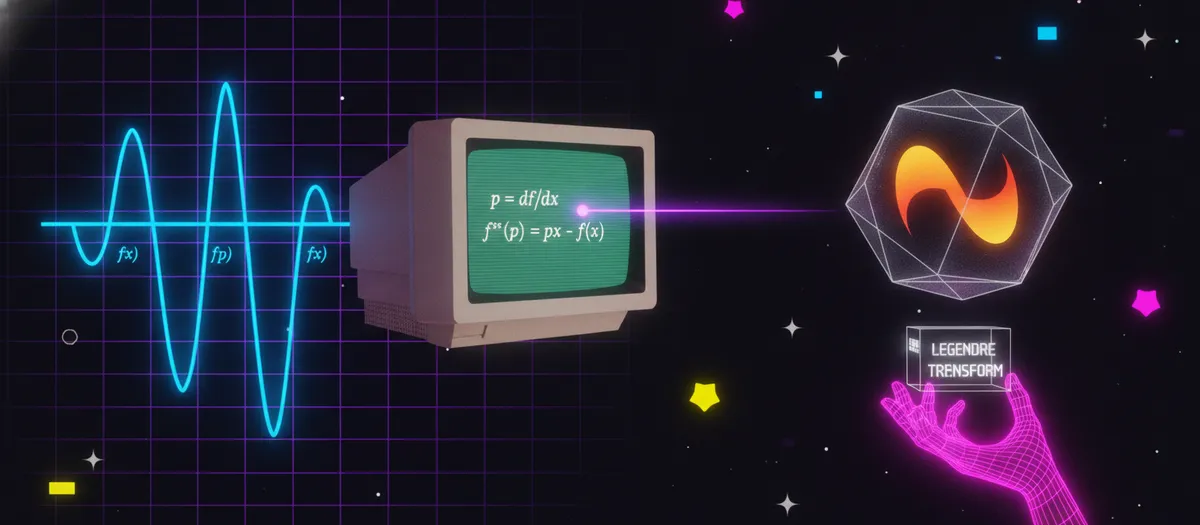
از نظر هندسی، اگر یک منحنی محدب $F(x)$ داشته باشید و خط مماسی با شیب $s$ رسم کنید، نقطهی تلاقی این خط با محور عمودی برابر با $-G$ خواهد بود. این همان هندسهی کلاسیک دوره راهنمایی است: ضرب شیب در ضلع افقی برابر با ضلع عمودی است، جایی که ضلع عمودی از ترکیب $F$ و $G$ تشکیل شده است.
این عملیات یک «خودمعکوس» (Involution) است؛ یعنی اگر تبدیل را روی تابع $F$ اجرا کنید $G$ میگیرید و اگر دوباره روی $G$ اجرا کنید به $F$ بازمیگردید. در مکانیک این دوگانگی، سرعت را با تکانه عوض میکند و در ترمودینامیک، انرژی را با دما. از آنجا که ترموستاتها در فروشگاهها فروخته میشوند اما «انرژوستاتها» وجود ندارند، کنترل دما ($\beta$) بسیار راحتتر از کنترل انرژی ($E$) است.
یک ویژگی حیاتی این دوگانگی این است که انحنای توابع دوگان، عکس یکدیگرند: $\frac{d^2F}{dx^2}\cdot\frac{d^2G}{ds^2} = 1$. این دقیقاً مشابه رابطه عدم قطعیت $\Delta x,\Delta k \approx 1$ در فیزیک است. در سادهترین حالت، یک سهمی مانند $F(x) = \tfrac{1}{2}\alpha x^2$ به سهمی دیگری مانند $G(s) = \tfrac{1}{2\alpha}s^2$ تبدیل میشود و به همین دلیل است که توزیع گاوسی در آمار تا این حد مرکزی و کلیدی است.
همیوغی فنچل و تابآوری
توابع دنیای واقعی در بهینهسازی و آمار بهندرت نرم هستند؛ آنها اغلب پر از شکستگیها و بخشهای مسطحاند. ورنر فنچل برای حل این مشکل، راهکاری جامعتر پیشنهاد داد: «تبدیل لژاندر-فنچل» یا «همیوغی محدب» (Convex Conjugation). در این روش بهجای اتکا به مشتقات، از «سوپرمم» (Supremum) استفاده میشود: $f^{*}(s) = \sup_{x}\big(\langle s, x\rangle - f(x)\big)$.
این رویکرد به ما اجازه میدهد با قرار دادن هر خط ممکن با شیب $s$ در برابر نمودار، بهترین عرض از مبدأ را بیابیم. این کار تضمین میکند که $f^{*}$ بهطور خودکار محدب باشد، حتی اگر تابع اصلی $f$ محدب نبوده باشد. برای توابع غیرمحدب، این فرآیند مانند «بتن ریختن» روی گودالهاست و یک «پوسته محدب» (Convex Hull) ایجاد میکند.
در ترمودینامیک، این «بتن ریختن» یک مفهوم انتزاعی نیست، بلکه همان «ساختار ماکسول» (Maxwell construction) است. این پدیده همزیستی مایع و بخار را هنگام جوشیدن آب در کتری توصیف میکند؛ در واقع طبیعت در حال محدبسازی یک انرژی آزاد غیرمحدب است. این امر منجر به «نابرابری فنچل-یانگ» میشود: $f(x) + f^{*}(s) \ge \langle s, x\rangle$. تساوی تنها زمانی رخ میدهد که $x$ و $s$ جفتهای دوگان باشند (جایی که $s$ یک زیرمشتق از $f$ در نقطه $x$ باشد).
سافتمکس بهعنوان یک ماشین فیزیکی
در مدلهای زبانی بزرگ، سیستم لاجیتها (Logits) را تولید میکند ($z$) که بهعنوان پارامترهای طبیعی عمل میکنند. برای تبدیل اینها به یک توزیع احتمالی، مدل از فرمول زیر استفاده میکند: $\text{softmax}(z)i = \frac{e^{z_i}}{\sum{j} e^{z_j}}$. این فرآیند با تابع LogSumExp (LSE) همراه است: $\operatorname{LSE}(z) = \ln \sum_i e^{z_i}$.
این صرفاً یک ترفند نرمالسازی نیست، بلکه تغییری در مختصات در یک «خانواده نمایی» است. در آمار، توزیعهایی مانند گاوسی، برنولی و پوآسون از فرم $p(x;\theta) = h(x),\exp\big(\langle \theta, T(x)\rangle - A(\theta)\big)$ پیروی میکنند. در اینجا، $\theta$ پارامترهای طبیعی و $A(\theta)$ تابع لگاریتم پارتیشن است.
- LogSumExp (LSE) دقیقاً بهعنوان تابع لگاریتم پارتیشن $A(\theta)$ عمل میکند.
- گرادیان LSE دقیقاً همان تابع سافتمکس است: $\nabla \operatorname{LSE}(z) = \text{softmax}(z)$.
- LogSumExp در واقع تبدیل لژاندر-فنچلِ «آنتروپی منفی» $\Omega(p) = \sum_i p_i \ln p_i$ روی سیمپلکس احتمال است.
در واقع، سافتمکس یک «argmax» است که توسط آنتروپی رشوه داده شده است. از نظر ریاضی: $\text{softmax}(z) = \arg\max_{p \in \Delta}\big(\langle z, p\rangle + H(p)\big)$. بدون ترم آنتروپی $H(p)$، مدل تمام جرم احتمالی را روی یک توکن واحد میریخت و یک argmax سخت و غیرقابلمشتق ایجاد میکرد. آنتروپی باعث میشود جواب به فضای داخلی سیمپلکس سوق یابد و فرآیند برای «گرادیان کاهشی» (Gradient Descent) — روشی برای یافتن کمترین نقطهٔ خطا در مدل — نرم و قابلتمایز شود.
لغزنده دما و گیبس
وقتی کاربر دمای (Temperature) مدل را در API تغییر میدهد ($\tau$)، در واقع دارد «بتای معکوس» ($\beta = 1/k_B T$) یک توزیع بولتزمن-گیبس را دستکاری میکند. فرمول نمونهبرداری به این صورت است: $p_i = \frac{e^{z_i/\tau}}{\sum_j e^{z_j/\tau}}$. در اینجا، لاجیتهای $z$ نقش انرژیهای منفی را ایفا میکنند.
- دمای پایین ($\tau \to 0$): توزیع «منجمد» شده و به یک argmax سخت تبدیل میشود. مدل خستهکننده میشود و همیشه محتملترین توکن را انتخاب میکند.
- دمای بالا ($\tau \to \infty$): توزیع «ذوب» شده و به نویز یکنواخت تبدیل میگردد.
- همگرایی: با سرد شدن، $\tau\operatorname{LSE}(z/\tau) \to \max_i z_i$ میشود، که دقیقاً مشابه همگرایی انرژی آزاد به انرژی حالت پایه در مکانیک آماری است.
در هر بار حرکت این لغزنده، کاربر در حال تنظیم $\beta$ در یک مجموعه گیبس است. لایه آخر یک LLM در واقع یک ماشین لژاندر-فنچل است که مدام مسئلهی بیشینه کردن مقدار لاجیت مورد انتظار بهعلاوه آنتروپی را حل میکند.
بازتعریف زیان آنتروپی متقاطع
این دوگانگی حتی در نحوه آموزش مدلها نیز جاری است. تابع زیان «آنتروپی متقاطع» (Cross-Entropy Loss) که در همه مدلها استفاده میشود، در واقع همان شکافت در نابرابری فنچل-یانگ است: $f(x) + f^{*}(s) \ge \langle s, x\rangle$.
با تعریف تابع زیان $L_{\Omega}(z, y) = \Omega^{*}(z) + \Omega(y) - \langle z, y\rangle$ و جایگذاری آنتروپی منفی ($\Omega$) و یک بردار one-hot برای توکن هدف ($y=e_k$)، زیان به این شکل ساده میشود:
$$L(z, e_k) = \operatorname{LSE}(z) - z_k = -\ln \text{softmax}(z)_k$$
این دقیقاً همان زیان آنتروپی متقاطعی است که توسط هر LLM استفاده میشود. آموزش مدلهای میلیارد دلاری، در حقیقت تمرینی برای کوچک کردن این شکافت فنچل-یانگ است تا لاجیتها و اهداف به یک «جفت دوگان» تبدیل شوند. این چهارچوب کاملاً ماژولار است:
- آنتروپی $\to$ سافتمکس: توزیع احتمالی استاندارد و نرم.
- جریمه درجه دوم $\to$ اسپارسمکس (Sparsemax): خویشاوند سافتمکس که میتواند احتمال توکنهای غیرمحتمل را دقیقاً صفر کند.
- سایر توابع $\Omega$: تولید توابع زیان ساختارمند برای میدانهای تصادفی شرطی (CRFs) و تجزیه نحوی (Parsing).
تحلیل: همگرایی حوزهها
برای متخصصان هوش مصنوعی، این کشف نگاه به لایه خروجی LLM را از یک «ترفند مهندسی» به یک قانون بنیادین فیزیکی تغییر میدهد. این ثابت میکند که معماری فعلی ترنسفورمرها بهطور عمیقی با روشی که طبیعت اطلاعات و انرژی را مدیریت میکند، همسو است.
این دوگانگی بر بهینهسازی نیز حاکم است. روشهای Mirror Descent و گرادیان طبیعی بهطور همزمان در هر دو سیستم مختصاتی عمل میکنند. آنها یک نقطه را از طریق گرادیان یک تابع محدب به فضای دوگان میبرند، گام برمیدارند و دوباره بازمیگردانند. فاصلهها در این هندسه با «واگرایی بریگمن» (Bregman divergence) اندازهگیری میشوند که خود بر پایه همان تابع محدب ساخته شده است.
این موضوع نشان میدهد که پیشرفتهای آینده در نمونهبرداری یا توابع زیان، نه از طریق آزمون و خطای مهندسی، بلکه از طریق کاوش در سایر همیوگهای محدب به دست خواهد آمد. انتقال از سافتمکس به اسپارسمکس تنها شروع کار است؛ هر تابع محدب $\Omega$ میتواند یک جفت فعالساز و زیان ساختارمند و معتبر ایجاد کند.
گام بعدی شما
- برای درک عمیقتر، مفهوم «واگرایی بریگمن» (Bregman divergence) را مطالعه کنید تا بفهمید فاصله در فضای ویژگیها چگونه اندازهگیری میشود.
- در APIهای مدلها، دمای $0.1$ را با $0.8$ مقایسه کنید تا اثر «منجمد شدن» در برابر «ذوب شدن» توزیع احتمالی را مستقیماً مشاهده کنید.
- بررسی کنید که چگونه جایگزینی سافتمکس با Sparsemax میتواند توکنهای کماحتمال را کاملاً حذف کند.
این پیوند میان فیزیک و کد تنها آغاز ماجراست؛ بررسی اینکه چگونه این ریاضیات در تراشههای سختافزاری بهینه میشوند، در گزارش بعدی ما دربارهی معماری GPUها منتشر خواهد شد.



گفتگو