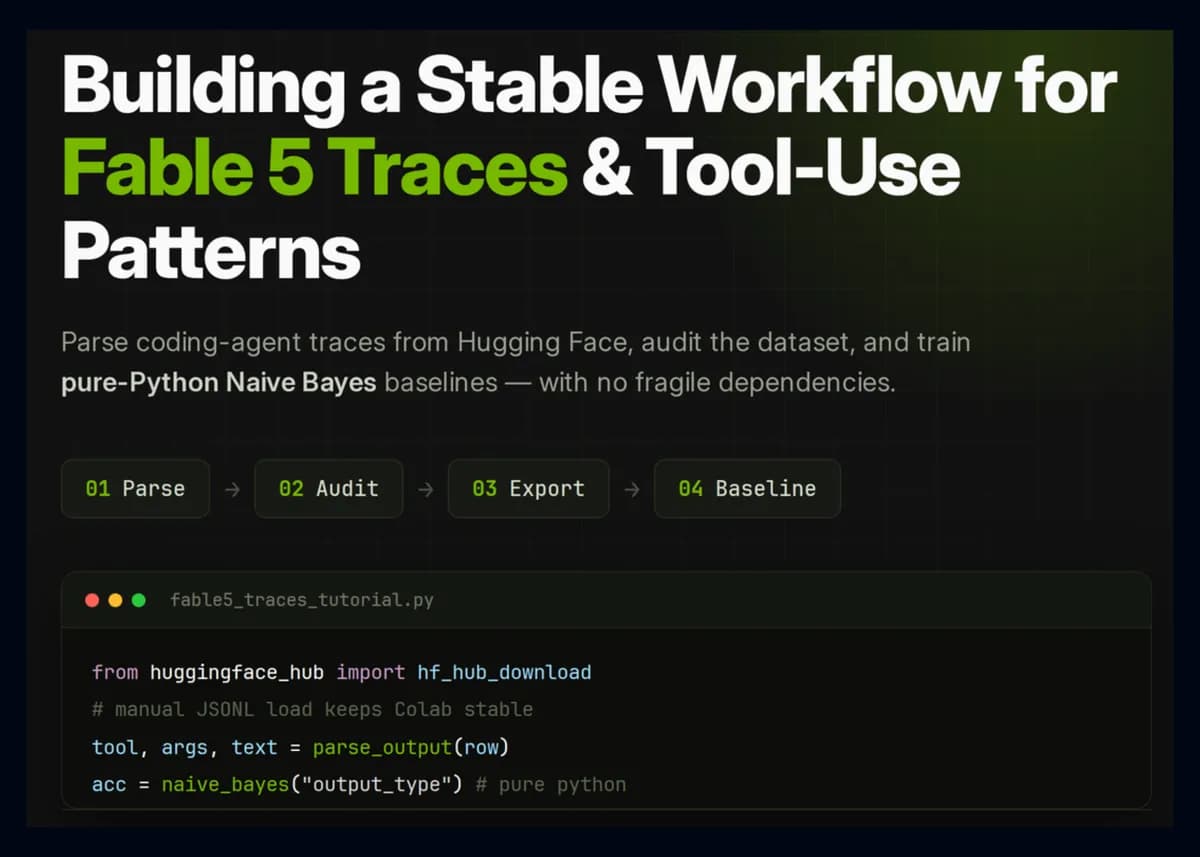
تصور کنید میخواهید یک عامل هوشمند کدنویسی بسازید که دقیقاً بداند در هر لحظه چه ابزاری را صدا بزند، اما دادههای آموزشی شما آشفته و پر از خطاست. اگر از گوگل کولب برای پردازش داده استفاده میکنید، احتمالاً با کرشهای مداوم کتابخانهها دستوپنجه نرم کردهاید. چرا بسیاری از محیطهای گوگل کولب با کرشهای مداوم وابستگیها (Dependency Crashes) مواجه میشوند؟
بر اساس مستندات فنی این پروژه، دلیل اصلی این ناپایداری، تکیه به کتابخانههای سطحبالای شکننده است. راهکار جایگزین، انتقال به تجزیه دستی فایلهای JSONL و استفاده از ابزارهای خالص پایتون (Pure-Python) است تا یک توسعهدهنده بتواند یک خط لوله (Pipeline) کامل برای پردازش مجموعه داده Fable 5 Traces بدون توقفهای ناگهانی ایجاد کند.
این رویکرد با دادههای عاملها نه به عنوان متن ساده، بلکه به عنوان تلهمتری — یعنی ثبت دقیق هر حرکت و سیگنال سیستم — برخورد میکند. در فضای فعلی هوش مصنوعی، گذار به سمت جریانهای کاری عاملمحور (Agentic Workflows) نیازمند درک عمیق از نحوه تعامل مدل با ابزارهاست؛ نیازی که Glint-Research با ارائه مجموعه داده Fable 5 به آن پاسخ میدهد. این تمرکز بر تحلیل ردپای مدلها با رویکردهای پیشرفتهای مانند سازوکار Trace2Policy برای ارتقای دقت تصمیمات تطبیقی همراستا است که نشان میدهد چگونه تحلیل دقیق ردهها میتواند منجر به بهبود عملکرد مدلها شود. برای کسانی که با مفاهیم پایه تنظیم نظارتشده (SFT) — شبیه وقتی به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — آشنا هستند، این گردشکار گام حیاتی ایزولهسازی اقدامات (Actions) عامل از استدلالهای درونی (Reasoning) او را معرفی میکند.
تنظیمات محیطی و تجزیه امن
برای حفظ پایداری در کولب، این خط لوله بهطور عمدی از نصب کتابخانههای سنگینی مثل scikit-learn و scipy دوری میکند. در عوض، محیطی سبک را انتخاب میکند که بر روی huggingface_hub>=0.23.0 ،rich>=13.0.0 و tqdm>=4.66.0 متمرکز است. طبق گزارش توسعهدهندگان، نصب این پیشنیازها از طریق یک فراخوانی subprocess.run با استفاده از اجرایی (Executable) فعلی سیستم انجام میشود تا سازگاری نسخهها و ثبات محیط تضمین شود.
در این ساختار، مکانیسم بارگذاری دستی JSONL (تابع load_jsonl_manual) جایگزین کتابخانه استاندارد datasets شده است، زیرا این کتابخانه اغلب تداخلات نسخهای پیچیدهای را ایجاد میکند. این تابع با استفاده از یک شمارنده خطوط، فایل را پیمایش کرده، فضای خالی (Whitespace) را حذف میکند و تلاش میکند هر خط را به عنوان یک شیء JSON بارگذاری کند. این سیستم شامل یک مدیریت خطای قدرتمند برای ثبت «خطوط خراب» (Bad Lines) است که شماره خط، خطای دقیق و یک پیشنمایش ۵۰۰ کاراکتری از خط مشکلدار را ثبت کرده و در نهایت آنها را برای عیبیابی در فایل bad_jsonl_lines.json ذخیره میکند.
ثابتهای سیستم برای جلوگیری از آشفتگی کنسول و تضمین یکسانی نتایج تعریف شدهاند. بذر تصادفی (Seed) روی عدد ۴۲ تنظیم شده و دایرکتوری خروجی بر روی /content/fable5_traces_tutorial_outputs قرار گرفته است که با پارامتر parents=True ساخته میشود. برای مدیریت نمایش در کنسول، MAX_PREVIEW_CHARS روی ۹۰۰ کاراکتر و N_AGENT_TRACE_PREVIEWS روی ۲ مورد تنظیم شده است. همچنین N_SAFE_DATASET_PREVIEWS روی ۳ قرار گرفته و پرچم SAVE_COT_RESEARCH_EXPORT بهطور پیشفرض روی False تنظیم شده است.
یکی از دغدغههای اصلی در مدیریت تلهمتری عاملها، امنیت است، زیرا این دادهها اغلب حاوی اطلاعات حساس سیستم هستند. این راهنما از یک الگوی منظم (Regex) با نام SECRET_RE برای شناسایی و حذف (Redact) کلیدهای API و توکنهای حساس پیش از هرگونه نمایش یا خروجی دادهها استفاده میکند. همچنین یک تابع کمکی به نام safe_json_dumps پیاده شده است که کاراکترهای غیر ASCII را حفظ کرده، برای خوانایی بیشتر تورفتگی (Indent) ایجاد میکند و رشتههای بیش از حد طولانی را برای جلوگیری از سرریز شدن کنسول، کوتاه میکند.
شناسایی و حذف اسرار (Redaction)
- تطبیق الگو (Pattern Matching): سیستم بهطور خاص به دنبال الگوهای شناسهدار میگردد، از جمله کلیدهای
sk-مربوط به OpenAI، کلیدهایhf_مربوط به Hugging Face، توکنهایgithub_pat_یاghp_مربوط به گیتهاب، کلیدهایxoxbaprs-مربوط به Slack و کلیدهایAKIAمربوط به AWS. این الگوها معمولاً رشتههایی با طول ۲۰ کاراکتر یا بیشتر را هدف قرار میدهند. - شناسایی عمومی (Generic Detection): سیستم همچنین به دنبال تطابقهای غیرحساس به حروف بزرگ و کوچک برای عباراتی مانند
api_key،secret،tokenیاpasswordمیگردد که پس از آنها عملگرهای انتساب (:یا=) و رشتههایی با طول ۸ کاراکتر یا بیشتر آمده باشد. - اعمال و پاکسازی: تابع
redact_possible_secretsتمام این موارد یافت شده را با عبارت[REDACTED_POSSIBLE_SECRET]جایگزین میکند. تابع کمکیcontains_possible_secretنیز کل ردیفها را برای حسابرسی امنیتی علامتگذاری میکند. علاوه بر این، تابعclean_for_jsonبهصورت بازگشتی دیکشنریها، لیستها و تاپلها را پیمایش کرده و بهطور خاص اعداد صحیح و اعشاری NumPy را به انواع استاندارد پایتون تبدیل میکند تا قابلیت سریالسازی JSON تضمین شود.
نرمالسازی فراخوانی ابزارها
هسته اصلی این خط لوله، مجموعهای از ابزارهای تجزیه (Parsing) قدرتمند است که برای مدیریت ماهیت نامنظم خروجیهای عاملها طراحی شدهاند. از آنجایی که فراخوانی ابزارها ممکن است بهصورت رشتههای متنی یا دیکشنریهای تودرتو ذخیره شده باشند، این گردشکار از توابع maybe_parse_json_string و normalize_output_obj استفاده میکند تا ورودیها را پیش از استخراج استاندارد کند. تابع maybe_parse_json_string بهطور خاص بررسی میکند که آیا رشته با کروشه یا آکولاد {} یا [] شروع و پایان یافته است یا خیر و سپس اقدام به اجرای json.loads میکند.
جزئیات منطق استخراج ابزار
- استخراج نام ابزار: منطق سیستم کلیدهای مستقیم مانند
name،tool_name،tool،function،command_name،recipient_name،toolNameوcalleeرا جستوجو میکند. همچنین بهطور بازگشتی کلیدهای تودرتو مانندtool_call،toolCall،function_call،callوactionرا بررسی میکند. اگر یکoutput_typeوجود داشته باشد و با مقادیر "tool_use" ،"text" یا "message" مطابقت نداشته باشد، همان مقدار به عنوان نام ابزار بازگردانده میشود. - تجزیه آرگومانها: برای ایزوله کردن ورودیها، سیستم به دنبال کلیدهایی نظیر
input،args،arguments،parameters،kwargs،jsonوpayloadمیگردد. اگر شیء موردنظر یک دیکشنری باشد اما هیچکدام از این کلیدهای خاص را نداشته باشد، سیستم تمام کلیدها بهجز موارد رزرو شده برای نام و نوع ابزار (مانندname،typeوcallee) را به عنوان آرگومان باز میگرداند. - نرمالسازی متن: تابع
extract_text_payloadبه دنبال کلیدهایtext،content،message،output،valueوresultمیگردد. اگر مقداری بهصورت لیست یا دیکشنری پیدا شود، از طریقsafe_json_dumpsبه رشته تبدیل میشود تا در خروجی نهایی به عنوان یک مقدار متنی (Payload) باقی بماند.
بازرسی مخزن و بارگذاری
پیش از بارگذاری دادههای اصلی، خط لوله با استفاده از HfApi تمام فایلهای موجود در مخزن Glint-Research/Fable-5-traces را فهرست میکند. سیستم بهطور خاص فایلهای JSONL در مسیر pi-traces/ و فایلهایی که با claude/ شروع میشوند را دستهبندی میکند. این کار به کاربر اجازه میدهد تا جدول خلاصهای شامل تعداد کل فایلهای مخزن، تعداد فایلهای JSONL و یک بررسی بلف (Boolean) برای وجود فایل ادغامشده کلی یعنی fable5_cot_merged.jsonl را مشاهده کند.
پس از دانلود فایل تخت (Flat file) توسط hf_hub_download ،دادهها به یک DataFrame پانداز تبدیل میشوند. خط لوله تضمین میکند که DataFrame شامل ستونهای مورد انتظار باشد: uid ،source_file ،session ،model ،context ،cot ،output_type ،output ،completion و origin. در صورت نبود هر یک از این ستونها، مقدار آنها به صورت None مقداردهی اولیه میشود تا از کرشهای احتمالی در مراحل بعدی جلوگیری شود.
سپس ستونهای مشتقشده (Derived Columns) برای تحلیلهای عمیقتر به DataFrame اضافه میشوند:
output_norm: شیء خروجی نرمالسازی شده.tool_nameوtool_args: استخراج شده توسط ابزارهای تجزیه.text_payload: خروجی متنی پاکسازی شده.context_chars،cot_chars،completion_charsوtext_payload_chars: طول رشتهها که توسط تابع کمکیrobust_lenاندازهگیری شدهاند.source_root: استخراج شده توسط تابعsource_root()که نشانگرهایی مثلprojects،AIArchives،archivesیاclaudeرا در مسیر فایل بررسی میکند.possible_secret_anywhere: یک پرچم بلف که نتیجه ترکیب بررسیهای امنیتی در هر دو بخش زمینه (Context) و تکمیل (Completion) است.
حسابرسی ساختار مجموعه داده
پس از بارگذاری دادهها، یک حسابرسی کامل (Full Audit) با استفاده از یک جدول پایه انجام میشود. خط لوله معیارهای زیر را ردیابی میکند:
- یکپارچگی ردیفها: تعداد کل ردیفها، تعداد
uidهای یکتا و تعداد ردیفهای تکراریuid. - دادههای جلسه: تعداد کل جلسات (Sessions) منحصربهفرد و مدلهای یکتا بهکاررفته در ردها.
- کامل بودن دادهها: شمارش دقیق مقادیر گمشده (Missing Values) در فیلدهای
context،cotوoutput. - حسابرسی ایمنی: تعداد کل ردیفهایی که دارای پرچم
possible_secret_anywhereهستند. - معیارهای طول: میانه (Median) تعداد کاراکترها برای
context_chars،cot_charsوcompletion_charsو همچنین مقدار حداکثر برایmax_completion_chars.
برای تصویرسازی شکل دادهها، هیستوگرامهای طول زمینه ایجاد میشوند که در صدک ۹۹ (P99) برش میخورند تا دادههای پرت (Outliers) حذف شوند. همچنین نمودارهای میلهای برای نمایش توزیع انواع خروجیها رسم میشوند. خط لوله پرتکرارترین «ریشههای منبع» (Source Roots) را شناسایی میکند — با اولویت دادن به نام پوشههایی که بعد از نشانگرهایی مثل projects یا AIArchives میآیند — تا زمینه پروژه عامل را درک کند. ۲۰ ابزار پرتکرار نیز در یک نمودار میلهای افقی ترسیم میشوند.
تصویرسازی و خروجیهای چت
برای مشاهده بصری زمینههای ردیفها، این راهنما یک تصویرسازی به سبک TF-IDF را تنها با استفاده از NumPy پیاده میکند تا نیاز به TfidfVectorizer کتابخانه scikit-learn نباشد. این فرآیند شامل مراحل زیر است:
۱. توکنسازی: استفاده از TOKEN_RE (که کلمات الفبایی یا توالیهای نمادین خاص مانند := یا [] را تطبیق میدهد) برای تکه تکه کردن متن. ورودیها به ۱۲,۰۰۰ کاراکتر محدود شدهاند.
۲. ساخت واژگان: انتخاب ۱۰۰۰ توکن پرتکرار که حداقل در ۲ سند ظاهر شده باشند و طول آنها بیشتر از ۱ کاراکتر باشد.
۳. وزندهی: اعمال فرمول IDF به صورت: log((1.0 + len(doc_tokens)) / (1.0 + df_counts)) + 1.0. ماتریس نهایی X ردیف-نرمال شده و با تفریق میانگین، مرکزیت مییابد.
۴. کاهش ابعاد: استفاده از تجزیه مقادیر تکین (SVD) برای تولید مختصات svd_x و svd_y. نتایج در فایلهای tfidf_svd_projection_points.csv و projection_vocabulary.csv ذخیره میشوند.
برای کسانی که قصد تنظیم دقیق (Fine-tune) مدلها را دارند، خط لوله خروجیهای «چت امن بدون زنجیره تفکر» (Safe No-CoT Chat) را ایجاد میکند. این فایلها استدلالهای درونی (cot) را حذف میکنند تا مدلها صرفاً مراحل استدلال را حفظ نکنند:
- پرامپت سیستمی: "شما یک عامل کدنویسی هستید. با توجه به زمینه کاربر و رونوشت قبلی، اقدام بعدی دستیار را تولید کنید. اگر نیاز به فراخوانی ابزار است، یک JSON ساختاریافته برگردانید. استدلالهای پنهان را افشا نکنید."
- پیام کاربر: شامل زمینه حذفشده از اسرار و رونوشت قبلی است.
- پیام دستیار: برای انواع
tool_use،یک JSON ساختاریافته حاویtype: tool_call،tool_nameوargumentsتولید میکند. برای انواع متنی، ازtext_payloadیاcompletionبه عنوان جایگزین استفاده میکند.
این خروجیها با بذر ۴۲ بُر زده شده (Shuffle) و به سه دسته تقسیم میشوند: آموزش (۹۰٪)، اعتبارسنجی (۵٪) و آزمون (۵٪). یک ایندکس تحلیلی نیز برای دسترسی سریع به صورت CSV و فایل pickle ذخیره میشود.
مدلسازی پایه با پایتون خالص
برای تست اینکه آیا زمینه (Context) میتواند حرکت بعدی عامل را پیشبینی کند، این آموزش یک طبقهبندیکننده PureMultinomialNB را از صفر پیاده میکند. این مدل log-priors کلاسها و log-probabilities ویژگیها را با استفاده از صافسازی لاپلاس (alpha=1.0) محاسبه میکند.
دو طبقهبندیکننده با استفاده از تقسیمبندی لایهبندی شده (Stratified Split) ۸۰/۲۰ آموزش داده میشوند:
- طبقهبندی نوع خروجی: پیشبینی میکند که گام بعدی
tool_useاست یا پاسخ متنی. این مدل تا ۲۰,۰۰۰ ویژگی را مدیریت کرده و ردیفهای با نوع خروجی خالی را فیلتر میکند. معیارهای ارزیابی شامل Accuracy، Macro-F1 و Weighted-F1 است. - طبقهبندی نام ابزار: ردیفهای مربوط به
tool_useرا فیلتر میکند. برای حفظ سیگنال، ۱۲ ابزار پرتکرار را ایزوله کرده و بقیه را در گروه__OTHER__قرار میدهد. این مدل برای اجرا به حداقل ۵۰ ردیف نیاز دارد.
ارزیابیها از طریق Precision، Recall و F1-score انجام میشود. تابع evaluate_predictions یک DataFrame گزارش و یک ماتریس اغتشاش (Confusion Matrix) تولید میکند. سیستم همچنین ۲۵ توکن برتر برای هر کلاس را با محاسبه حاشیه امتیاز (Score Margin) بین کلاس هدف و میانگین سایر کلاسها استخراج میکند. تمام معیارها به صورت JSON ذخیره و ماتریسهای اغتشاش به صورت CSV صادر میشوند.
جستوجو و گزارشدهی نهایی
در نهایت، خط لوله شامل یک تابع کمکی جستوجوی کلیدواژهای (search_rows) است که context ،cot ،completion و text_payload را اسکن میکند. کوئریهای نمونهای مانند "Bash" ،"Write" ،"browser" ،"test" و "README" برای نمایش کاربرد این ابزار استفاده شدهاند که uid ،session ،output_type و tool_name موارد یافت شده را برمیگردانند.
فرآیند با یک فایل جامع REPORT.md و یک فایل analysis_summary.json به پایان میرسد. این گزارشها جزئیات تعداد کل ردیفهای بارگذاری شده، جلسات یکتا، مدلهای یکتا و تعداد الگوهای امنیتی شناسایی شده را شرح میدهند. در این گزارش تأکید شده است که این آموزش با دادههای ردها به عنوان تلهمتری برخورد کرده و هرگز هیچ دستور داخلی را اجرا نمیکند.
این رویکرد سیستماتیک، تلهمتری خام را به یک مجموعه داده در سطح حرفهای تبدیل میکند. با دوری از «جعبه سیاه» کتابخانههای سطحبالا، شما کنترل کامل روی نحوه پاکسازی و حسابرسی دادههای آموزشی خود خواهید داشت.
اگر در حال ساخت یک دستیار کدنویسی سفارشی هستید، گام بعدی شما بررسی خروجی fable5_no_cot_chat_train.jsonl است تا مطمئن شوید JSON فراخوانی ابزار با اسکیمای مورد انتظار مدل هدف شما پیش از شروع هرگونه تنظیم دقیق (Fine-tuning) مطابقت دارد.



گفتگو