تصور کنید وبسایت شما در داشبورد تحلیلها بهعنوان پنج منبع مختلف ثبت شده باشد، صرفاً چون ارجاعات هوش مصنوعی یکسانسازی نشدهاند. دلیل این اتفاق آن است که OpenAI، Perplexity، Gemini و Claude هر کدام از ساختارهای دادهای کاملاً متفاوتی برای گزارش منابع اطلاعاتی خود استفاده میکنند. بدون یک نرمالساز (Normalizer) سفارشی، ردیابی میزان دیده شدن برند تقریباً غیرممکن است.
این چالش درست زمانی رخ میدهد که کسبوکارها از تستهای سادهی پرامپت به سمت ردیابی «سهم صدای هوش مصنوعی» (AI Share of Voice) حرکت میکنند. همانطور که پیشتر پوشش دادیم، عاملهای Gemini در گوگل کلاد میتوانند زمان بررسی اسناد را از یک ساعت به پنج دقیقه کاهش دهند، اما چالش فعلی این است که بدانیم مدل دقیقاً به کدام اسناد ارجاع داده تا به آن نتایج برسد. برای یک مدیر دیجیتال مارکتینگ یا متخصص سئو، یک ارجاع در پاسخهای هوش مصنوعی، همان بکلینکهای دوران وب است.
مشکل تکهتکگی دادهها
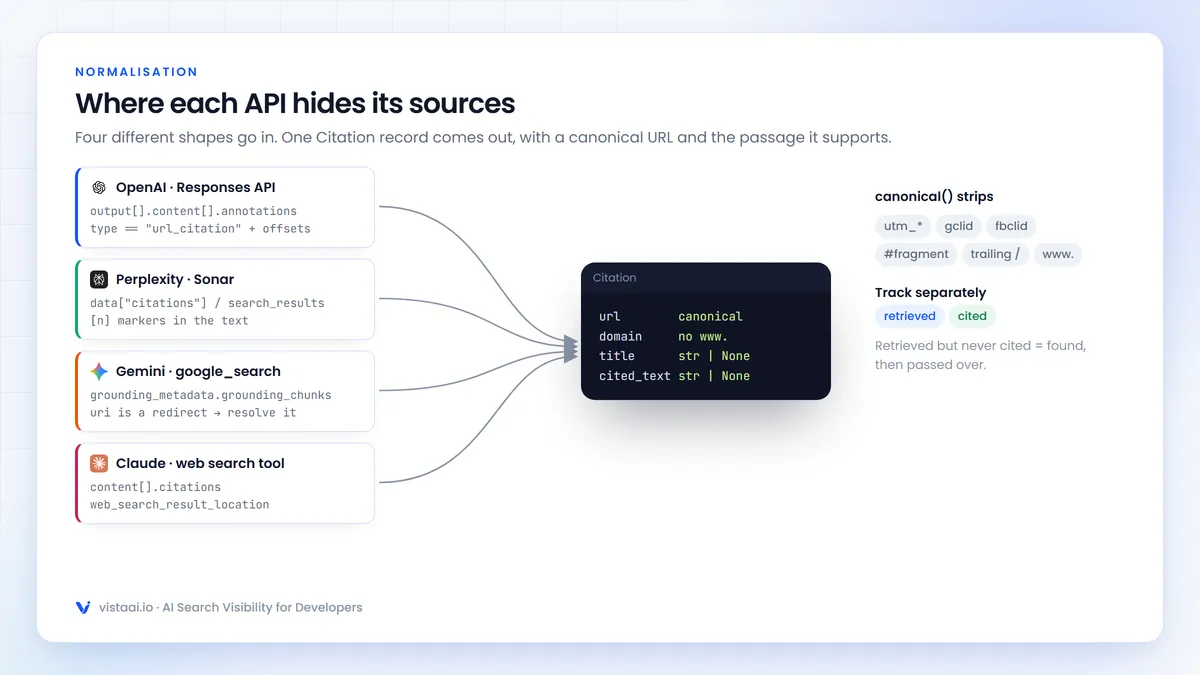
طبق یک راهنمای فنی که در ۸ اکتبر ۲۰۲۶ منتشر شد، چهار موتور اصلی هوش مصنوعی ارجاعات را به شکلهای متفاوتی مدیریت میکنند:
- OpenAI (در Responses API): از حاشیهنویسی روی متن خروجی با آفستهای کاراکتری استفاده میکند تا دقیقاً بازهی متنی که به منبع ارجاع دارد را مشخص کند. این رویکرد در کنار بهبودهای اخیر OpenAI در حذف خطاهای تجزیه JSON، دقت استخراج دادههای ساختاریافته را افزایش داده است.
- Perplexity (در Sonar API): یک آرایه از URLها را در سطح بالا ارائه میدهد و در متن از نشانگرهای [n] برای ایندکس کردن آنها استفاده میکند.
- Gemini (در Google Search grounding): تکههای مبنیسازی (Grounding) را برمیگرداند، اما اغلب بهجای لینکهای مستقیم، از URLهای بازهدایت (Redirect) از طریق vertexaisearch.cloud.google.com استفاده میکند.
- Claude (در ابزار جستوجوی وب): اشیاء ارجاع را مستقیماً به بلوکهای متنی مجزا در محتوای پاسخ متصل میکند.
جزئیات پیادهسازی فنی
برای حل این تضاد، توسعهدهندگان باید این اشکال متفاوت را به یک کلاس دادهای واحد به نام Citation تبدیل کنند. این ساختار هدف باید شامل URL، دامنه یکسانسازی شده (میزبان قابل ثبت بدون پیشوند "www.")، عنوان صفحه و متن دقیق ارجاع داده شده (cited_text) باشد. این نیاز به دقت در استخراج دادهها، یادآور چالشهای مشابهی است که در پروژههایی مانند OmniExtractBench برای ارتقای حسابرسی استخراج داده از PDF دنبال شده است.
- مکانیزم OpenAI: ارجاعات در بخشهای محتوای
output_textبهعنوان حاشیهنویسیهایی از نوعurl_citationقرار دارند. با استفاده از آفستهایstart_indexوend_indexمیتوان دقیقاً بازهی متنی را که به هر منبع اشاره کرده است، بازیابی کرد. - مکانیزم Perplexity: این سادهترین حالت در بین چهار مدل است. پاسخ شامل یک آرایه
citationsدر سطح بالا است. در پاسخهای جدیدتر، بخشsearch_resultsشامل عنوان و تاریخ نیز هست. چون نشانگرهایی مثل [1] بر پایه عدد ۱ هستند، منطق کد باید آنها را به ایندکس آرایه مپ کند. - مکانیزم Gemini: منابع در
grounding_metadataبازگردانده میشوند. فیلدgrounding_supportsقطعات متن را به ایندکسهای تکه (Chunk) متصل میکند که از این طریقcited_textبه دست میآید. - مکانیزم Claude: وقتی ابزار سرور جستوجوی وب فعال است، محتوای پاسخ لیستی از بلوکهاست. بلوکهای متنی لیستی از
citationsدارند که در آنها اشیاءweb_search_result_locationاطلاعات URL، عنوان و متن ارجاع داده شده را فراهم میکنند.
شکاف بازهدایت و بازیابی
به نقل از مستندات فنی، در مورد Gemini یک گام اضافی لازم است: حل کردن بازهدایتها. چون گوگل اغلب لینکهای بازهدایت داخلی روی vertexaisearch.cloud.google.com برمیگرداند، یک فراخوانی requests.head با تنظیم allow_redirects=True ضروری است تا URL مقصد نهایی پیدا شود. راهنما توصیه میکند این بازهدایتهای حلشده کش شوند تا سرعت خط لوله (Pipeline) کاهش نیابد، زیرا همان بازهدایتها بهطور مکرر ظاهر میشوند.
همچنین تفکیک بین «آنچه بازیابی شده» و «آنچه ارجاع داده شده» حیاتی است. در Claude، بلوکهای web_search_tool_result هر چیزی را که هوش مصنوعی بازیابی کرده است لیست میکنند. اگر صفحهای بازیابی شده اما در پاسخ نهایی ارجاع داده نشده، به این معناست که موتور جستوجوی مدل صفحه شما را یافته اما تصمیم گرفته منبع دیگری مناسبتر است.
مانع پاکسازی URLها
آدرسهای خام بهندرت تمیز هستند. پارامترهای ردیابی مانند fbclid ،gclid ،mc_cid ،mc_eid ،ref و ref_src باعث ایجاد ورودیهای تکراری برای یک صفحه واحد میشوند. یک سیستم قدرتمند باید این پارامترها را حذف کرده و پیشوندهای "www." را پاک کند تا هر صفحه تنها یک بار شمرده شود.
نکته قابل توجه این است که ChatGPT به بسیاری از لینکهای خروجی خود utm_source=chatgpt.com را اضافه میکند. برای اهداف شمارش و جلوگیری از تکرار، این پارامتر باید حذف شود، اما برای تحلیلهای آماری باید در نظر گرفته شود، زیرا ترافیک در GA4 به همین شکل ظاهر میشود.
برای کسانی که به ردیابی دقیق دامنه نیاز دارند (مثلاً تفکیک blog.example.co.uk از example.co.uk)، راهنما پیشنهاد میکند از بسته tldextract برای مدیریت صحیح لیست پسوندهای عمومی (Public Suffix List) استفاده کنند، بهجای اینکه به میانبر سادهی removeprefix("www.") تکیه کنند.
اندازهگیری میزان دیده شدن
پس از یکسانسازی، دادهها اجازه میدهند دو سیگنال متمایز استخراج شود: «ذکر شده» در برابر «ارجاع داده شده».
- ذکر شده (Mentioned): نام برند شما در متن پاسخ میآید اما هیچ URLی ارائه نمیشود. این یعنی مدل شما را میشناسد اما ادعا را از منبع دیگری استخراج کرده است.
- ارجاع داده شده (Cited): یک URL به دامنه شما اشاره میکند، حتی اگر نام برند ذکر نشده باشد. این اتفاق زمانی میافتد که یک پست وبلاگی از یک ادعای کلی پشتیبانی کند.
ترکیب این دو در یک معیار واحد، ارزشمندترین دادهها را از بین میبرد چون هر کدام نیاز به استراتژیهای اصلاحی متفاوتی دارند.
با تجمیع این ارجاعات یکسانسازی شده با استفاده از یک Counter ،کاربران میتوانند ۱۵ دامنه برتری را که هوش مصنوعی در دستهبندی خاص آنها به آنها تکیه میکند، شناسایی کنند. این کار فاش میکند کدام پلتفرمهای شخص ثالث — مانند سایتهای نقد و بررسی، انجمنها یا ناشران خاص — محرک اصلی پاسخهای تولید شده توسط هوش مصنوعی هستند.
در این تغییر رویکرد، «متن ارجاع داده شده» اکنون مهمتر از «تعداد ارجاعات» است. دانستن اینکه ارجاع دادهاید یک معیار ظاهری (Vanity Metric) است؛ اما دانستن جملهی دقیقی که هوش مصنوعی برای پشتیبانی از یک ادعا استفاده کرده، یک بینش استراتژیک است.
اگر ترجیح میدهید این خط لوله سفارشی را مدیریت نکنید، ابزارهایی مانند Citation Tracking در Vista AI ثبت خودکار پرامپتها، پاسخها و امتیازدهی به احساسات (Sentiment Scoring) برای ذکر برند را ارائه میدهند. این ابزار میتواند عدم دقتها را علامتگذاری کند و به شما اجازه دهد یک اظهارنظر غلط را تا صفحه دقیقی که هوش مصنوعی بهعنوان منبع استفاده کرده، ردیابی کنید.
برای شروع ردیابی دیده شدن خود، ابتدا ترافیک GA4 خود را برای پارامتر utm_source=chatgpt.com بررسی کنید تا ببینید چه مقدار ترافیک ارجاعی در حال حاضر از دستیارهای هوش مصنوعی جریان دارد.
گام بعدی شما
- ترافیک GA4 خود را برای پارامتر
utm_source=chatgpt.comبررسی کنید تا حجم ترافیک ارجاعی از دستیارهای هوش مصنوعی را بسنجید. - اگر توسعهدهنده هستید، از کتابخانه
tldextractبرای پاکسازی دامنهها در سیستمهای ردیابی خود استفاده کنید. - تفاوت بین Mention و Citation را در گزارشهای مارکتینگ خود تفکیک کنید تا استراتژی تولید محتوا را بهینه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو