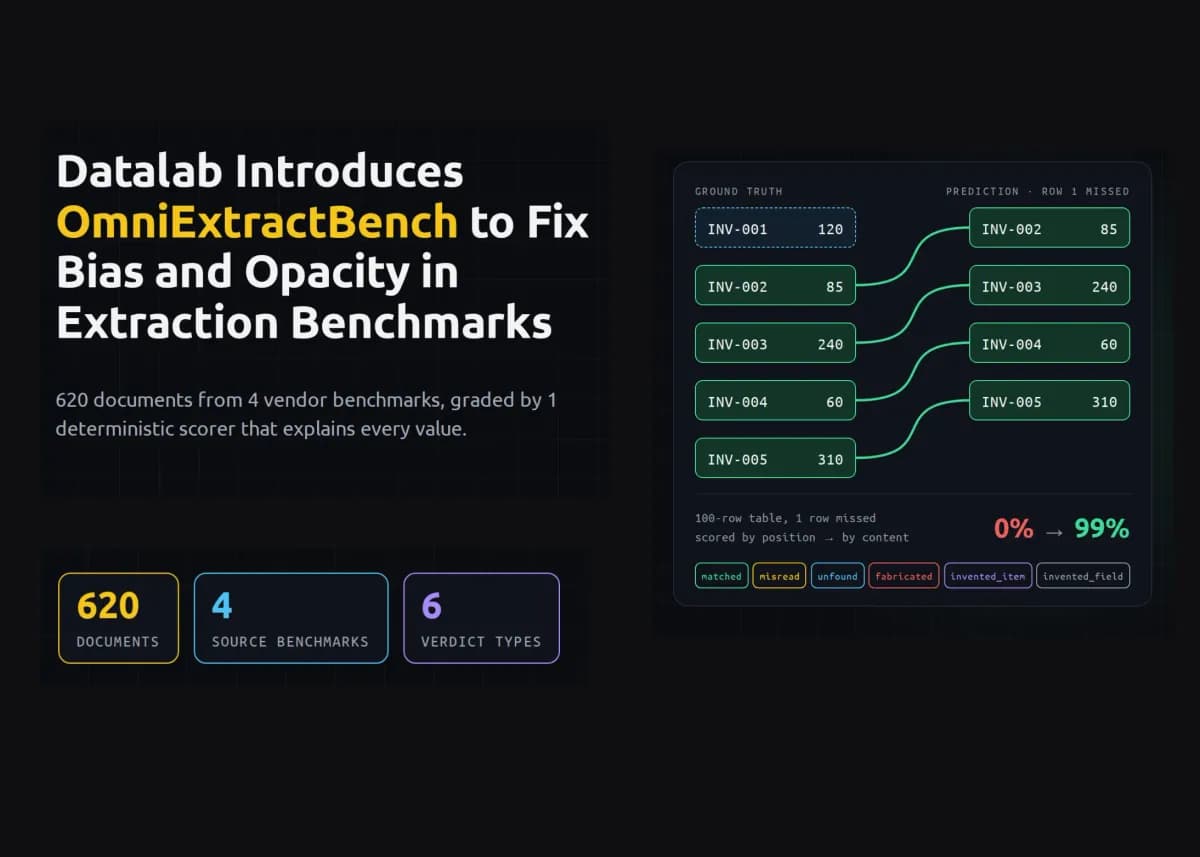
تصور کنید نمرات استخراج دادههای شما از فایلهای PDF بهدلیل خطاهای سادهای در جابهجایی ردیفها یا دستکاری در ساختار دادهها (Schema Padding)، بهطور مصنوعی بالا برده شده یا بهشدت کاهش یافته باشد. برای حل این مشکل، Datalab ابزار OmniExtractBench را منتشر کرد؛ یک محک متنباز که جایگزین جدولهای ردهبندی مبهم شرکتهای ارائهدهنده میشود تا معیاری قطعی، شفاف و قابل حسابرسی برای استخراج ساختاریافته اسناد فراهم کند.
بسیاری از ارائهدهندگان خدمات استخراج داده، جدولهای ردهبندی خودشان را منتشر میکنند، اما حسابرسی یا مقایسه این نتایج تقریباً غیرممکن است. Datalab استدلال میکند که محکهای فعلی از چهار نقص حیاتی رنج میبرند: نخست، سوگیری ارائهدهنده (جایی که روش امتیازدهی بهگونهای طراحی شده که به نفع سازنده است)؛ دوم، سازوکارهای امتیازدهی مبهم که ممکن است بازتابدهنده کدهای معیوب باشند نه مدلهای ضعیف؛ سوم، عدم شفافیت در امتیازدهی که پنهان میکند چرا یک سند خاص با شکست مواجه شده است؛ و چهارم، تنوع کم اسناد (مثلاً استفاده از مجموعههایی که فقط شامل فایلهای تمیز و اسکننشده یا فقط جداول متراکم هستند).
همانطور که در تحلیلهای پیشین ما دربارهی چالشهای استخراج دادههای ساختاریافته اشاره کردیم، نبود یک استاندارد واحد همواره مانع از انتخاب بهینه مدلها بوده است. برای رفع این خلأ، OmniExtractBench مجموعهای از ۶۲۰ سند را از چهار منبع مختلف، از جمله LlamaIndex و micro1، تجمیع کرده تا یک استاندارد مشترک و جامع ایجاد کند.
به نقل از گزارش Marktechpost در ۲۷ سپتامبر ۲۰۲۶، این محک بررسی میکند که یک سامانه با چه دقتی یک طرحواره (Schema) از نوع JSON را از یک PDF پر میکند. سیستم بر اساس یک فایل مرجع (Gold File) و مقدار به مقدار (Value-by-Value) امتیاز میگیرد. این ابزار که از طریق PyPI با نام omni-extract-bench (نسخه ۰.۱.۷) در دسترس است، به پایتون ۳.۱۱ به بالا و کتابخانه SciPy نیاز دارد و تحت مجوز Apache 2.0 منتشر شده است.
ترکیب اسناد و زمینه
مجموعه ۶۲۰ سندی که در این ابزار استفاده شده، از چندین بسته تخصصی برای تضمین تنوع جمعآوری شده است تا هیچ جنبهای از پیچیدگی اسناد نادیده گرفته نشود:
- ExtractBench (LlamaIndex): شامل ۳۲۹ سند که از فرمها، پروندههای اداری (Filings) و اسلایدهای ارائه (Decks) تشکیل شده است.
- Datalab (داخلی): شامل ۲۰۲ سند مصنوعی که ویژگیهایی چون اسناد کوچک و طرحوارههای اسکالر متراکم را پوشش میدهند.
- LongExtractBench (micro1): شامل ۴۷ سند که توسط Reducto سفارش داده شده و تمرکز ویژهای بر جداول بسیار بزرگ دارند.
- LongArray-Extract (Extend): شامل ۴۲ سند که دارای جداول بزرگ با مقادیر اسکالر تکراری هستند.
بر اساس مستندات این پروژه، فرمهای گزارشهای نظارتی (Regulatory filing forms) با ۸۸ سند، بزرگترین دستهبندی تکموردی را تشکیل میدهند. مقیاس دادهها در این مجموعه بسیار متغیر است؛ ۱۲۸ سند تنها یک صفحه دارند، در حالی که ۳۳ سند بیش از ۱۰۰ صفحه هستند که در مجموع ۴۰٪ از کل صفحات موجود در این محک را شامل میشوند. این دادهها تحت مجوز CC BY 4.0 در پلتفرم Hugging Face میزبانی میشوند.
سازوکار فنی و امتیازدهی
این امتیازدهنده، پیشبینیها و دادههای مرجع JSON را به «آدرسها» تبدیل میکند؛ آدرسها در واقع مسیرهایی هستند که به مقادیر تک (Single Values) ختم میشوند. پیش از نمرهدهی، مقادیر نرمالسازی میشوند تا تفاوتهای ظاهری باعث خطا نشوند؛ برای مثال، تاریخ «۰۳/۳۱/۲۰۲۴» بهطور خودکار با «۲۰۲۴-۰۳-۳۱» یکسان در نظر گرفته میشود.
- جفتسازی مبتنی بر محتوا: برخلاف مقایسههای موقعیتی (Positional Comparison) — که در آن حذف تنها یک ردیف باعث جابهجایی تمام ردیفهای بعدی و در نتیجه صفر شدن امتیاز کل یک جدول میشود — OmniExtractBench از الگوریتم مجارستانی (Hungarian algorithm) برای جفت کردن ردیفها بر اساس محتوای آنها استفاده میکند. در یک تست روی جدولی با ۱۰۰ ردیف که ردیف اول آن حذف شده بود، مقایسه موقعیتی امتیاز ۰٪ گرفت، اما این ابزار با شناسایی محتوا، امتیاز ۹۹٪ ثبت کرد.
- قانون مقادیر تهی (Null Rule): رشتههای خالی،
Noneو فضای خالی (Whitespace) بهعنوان حذفشده در نظر گرفته شده و از محاسبات کنار گذاشته میشوند. این کار مانع از ترفندی میشود که در آن ارائهدهندگان، فیلدهای خالی اختیاری را به طرحواره اضافه میکنند تا تطابقهای رایگان به دست آورند و نمره خود را بالا ببرند. در آزمایشها، فیلدهای تهیِ اضافه شده (Padded null fields) هیچ امتیازی (۰ حکم) اضافه نکردند. - سیستم ششگانه احکام: هر مقدار یکی از شش وضعیت قابل حسابرسی میگیرد تا علت دقیق خطا مشخص شود:
- paired: مقادیر کاملاً مطابقت دارند.
- misread: ردیف جفت شده است، اما مقادیر متفاوت هستند.
- unfound: در فایل مرجع مقداری وجود دارد، اما در پیشبینی یافت نشد.
- fabricated: مدل فیلدی را پر کرده است که در فایل مرجع خالی یا ساکت بوده است.
- invented_item: یک ردیف پیشبینی شده که با هیچ ردیفی در مرجع جفت نمیشود.
- invented_field: آدرسی که در طرحواره اولیه هرگز تعریف نشده بود.
رویارویی عملکرد مدلها
Datalab ده پیکربندی سیستمی مختلف را روی کل مجموعه آزمایش کرد. مدل Datalab accurate با صحت (Accuracy) ۹۳.۸۵٪ پیشتاز این گروه بود و پس از آن Datalab balanced (۹۳.۴۸٪) و Reducto deep_extract v2 (۹۳.۴۷٪) قرار گرفتند.
نتایج الگوهای شکست متفاوتی را میان مدلهای برتر نشان میدهد. مدل GPT دقت (Precision) بالایی (۹۵.۱۱٪) داشت اما بازخوانی (Recall) آن پایینتر بود (۸۴.۹۹٪) و ۱۱.۸۸٪ از مقادیر را بهدلیل خطای «نیافته» (unfound) از دست داد. مدلهای Gemini و Claude نیز الگوهای مشابهی داشتند، هرچند شدت آن کمتر بود. در مقابل، LlamaExtract بازخوانی بالایی (۹۳.۱۳٪) ثبت کرد اما دقت آن پایینتر بود (۸۶.۵۷٪) و ۹.۰۳٪ از مقادیر را بهصورت «ساختگی» (fabricated) تولید کرد. مدل Extend نیز ۴.۰۱٪ از دادهها را بهصورت «آیتمهای ابداعی» (invented items) از دست داد.
مدلهای Mistral OCR 4.1 و Azure Content Understanding در هر دو معیار در انتهای گروه قرار گرفتند و نقطه ضعف اصلی آنها بازخوانی (Recall) بود.
این چرخش به سمت امتیازدهی قطعی در سطح مقدار، فرضیات این حوزه درباره «صحت» را تغییر میدهد. با تفکیک دقت (مقادیر ساختگی) از بازخوانی (مقادیر از دست رفته)، توسعهدهندگان اکنون میتوانند تشخیص دهند که آیا مدل آنها در حال تولید توهم (Hallucination) است یا صرفاً در یافتن دادهها ناتوان است. این موضوع یادآور چالشهای مشابه در سیستمهای بازیابی است که در آن درک زمینهای جایگزین تکهبندی ساده شده است تا دقت استخراج اطلاعات افزایش یابد.
برای مهندسان، این به معنای باز شدن «جعبه سیاه» جدولهای ردهبندی است. امکان نصب امتیازدهنده از طریق پایتون ۳.۱۱ به بالا و اجرای آن با کلیدهای API شخصی، امکان تأیید مستقل و واقعی ادعاهای ارائهدهندگان را فراهم میکند. لازم به ذکر است که اجرای مجدد تستهای ارائهدهندگان مستلزم داشتن کلیدهای API و اعتبار پرداخت شده (Paid Credits) است. در واقع، شناسایی دقیق این خطاها از تکرار اشتباهات خاموشی که پیشتر در چارچوبهایی مانند OGX مشاهده شد و نتایج را مخدوش میکرد، جلوگیری میکند.
اکنون میتوانید این معیارها را شخصاً آزمایش کنید؛ با نصب افزونههای محک و اجرای دستور oeb benchmark میتوانید تستهای ارائهدهندگان را بازتولید کنید یا در محیط Playground شرکت Datalab با اسناد خودتان آزمایش کنید. برای امتیازدهی به فایلهای خاص، از دستور زیر استفاده کنید:oeb score --pred pred.json --gt gold.json --schema schema.json --verdicts
گام بعدی شما
- نصب ابزار از طریق دستور
pip install omni-extract-benchبرای ارزیابی مدلهای داخلی خود. - اجرای دستور
oeb benchmarkبرای بازتولید نتایج ارائهدهندگان و مقایسه آنها با دادههای واقعی. - استفاده از دستور
oeb scoreبرای تحلیل دقیق فایلهای JSON پیشبینیشده در برابر دادههای مرجع.
اما تأثیر این دقت در استخراج دادهها بر روی توسعه عاملهای هوش مصنوعی بسیار عمیقتر است — به تحلیل ما دربارهی پروتکل MCP و مدیریت دانش مراجعه کنید. این تکامل در دقت استخراج، در کنار بهبود توانایی مدلهای کوچک در استفاده از ابزارها، مسیر ساخت عاملهای خودکارتر را هموار میکند.



گفتگو