
یک منوی زیبا که توسط هوش مصنوعی طراحی شده، اگر حتی یک قیمت در آن اشتباه باشد یا یک حرف جابهجا شده باشد، یک شکست کامل است. برای تیمهای نرمافزاری، بازبینی بصری بیش از حد متغیر است و نمیتوان آن را به عنوان یک گیت کیفیت (Quality Gate) تکرارپذیر به کار برد.
به نقل از یک راهنمای فنی که در ۱ سپتامبر ۲۰۲۶ در dev.to منتشر شد، تنها راهکار قابلاعتماد این است که تولید تصاویر حاوی متن را به عنوان یک خط لوله (Pipeline) قابلآزمون در نظر بگیرید. تصور کنید در حال استقرار یک تابلوی منوی دیجیتال هستید؛ اگر هوش مصنوعی عبارت "OAT LATTE" را به صورت "OAT LATT3" رندر کند، احتمالاً چشم انسان متوجه آن نمیشود، اما مشتری قطعاً متوجه خواهد شد. این شکاف، یک بحران قابلیتاعتماد برای برندهایی ایجاد میکند که از هوش مصنوعی زاینده (Generative AI) — شبیه به هنرمندی که سریع طراحی میکند اما گاهی در جزئیات املایی اشتباه میکند — برای داراییهای تولیدی استفاده میکنند. توسعهدهندگان باید از حالت «امیدوار بودن به درست بودن ظاهر» به یک سامانه اعتبارسنجی مبتنی بر قرارداد (Contract-based) حرکت کنند که قرارداد پذیرش آن برای ماشین قابلخوان باشد.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت و دقت مدلهای مولد اشاره کردیم، تکیه بر خروجیهای بصری بدون لایه تأیید، ریسک تجاری بالایی دارد. این چالش مشابه خطراتی است که در تولید کدهای برنامهنویسی توسط هوش مصنوعی مشاهده میشود، جایی که خروجی در ظاهر کاربردی است اما از نظر فنی دارای نقصهای پنهان است. فرآیند اعتبارسنجی با این شروع میشود که پرامپت و تأکید آزمون (Test Assertion) از یک منبع واحد حقیقت (Single Source of Truth) تغذیه شوند. به جای تایپ دوباره متنها، توسعهدهندگان باید یک مشخصات ساختاریافته — مانند یک شیء JSON شامل عناوین، اقلام و قیمتها — ذخیره کنند و هم پرامپت و هم خروجی مورد انتظار را از آن استخراج کنند. برای مثال، یک شیء EXPECTED میتواند منوی صبحانه را با اقلامی مثل "OAT LATTE" به قیمت ۴.۵۰ دلار تعریف کند.
این رویکرد باعث میشود خطاهای کاذب (False Failures) حذف شوند؛ یعنی حالتی که پرامپت یک چیز میگوید اما سیستم تست چیز دیگری را انتظار دارد. همچنین باعث میشود هر تغییر عمدی در متن در طول بررسی کد (Code Review) کاملاً مشهود باشد.
برای تولید تصاویر، این راهنما استفاده از فضای کاری GPT Image 2 را توصیه میکند. بررسیهای انجامشده در ۱ سپتامبر ۲۰۲۶ نشان داد که این محیط مسیرهای تبدیل متن به تصویر و ویرایش تصویر، نسبتهای ابعادی مختلف و سیستم اعتباردهی را ارائه میدهد. برای حداکثر خوانایی، پرامپتها باید روی تابلوی منوی رو به جلو، کنتراست بالا، یک خانواده تایپی واحد و عدم استفاده از حروف تزئینی تأکید کنند. همچنین درخواست حاشیه خالی در اطراف هر ناحیه برای تسهیل برشهای مستقل ضروری است. تصویر تولیدشده باید به عنوان یک اثر غیرقابلاعتماد تلقی شود تا زمانی که یک اعتبارسنج (Validator) آن را تأیید کند.
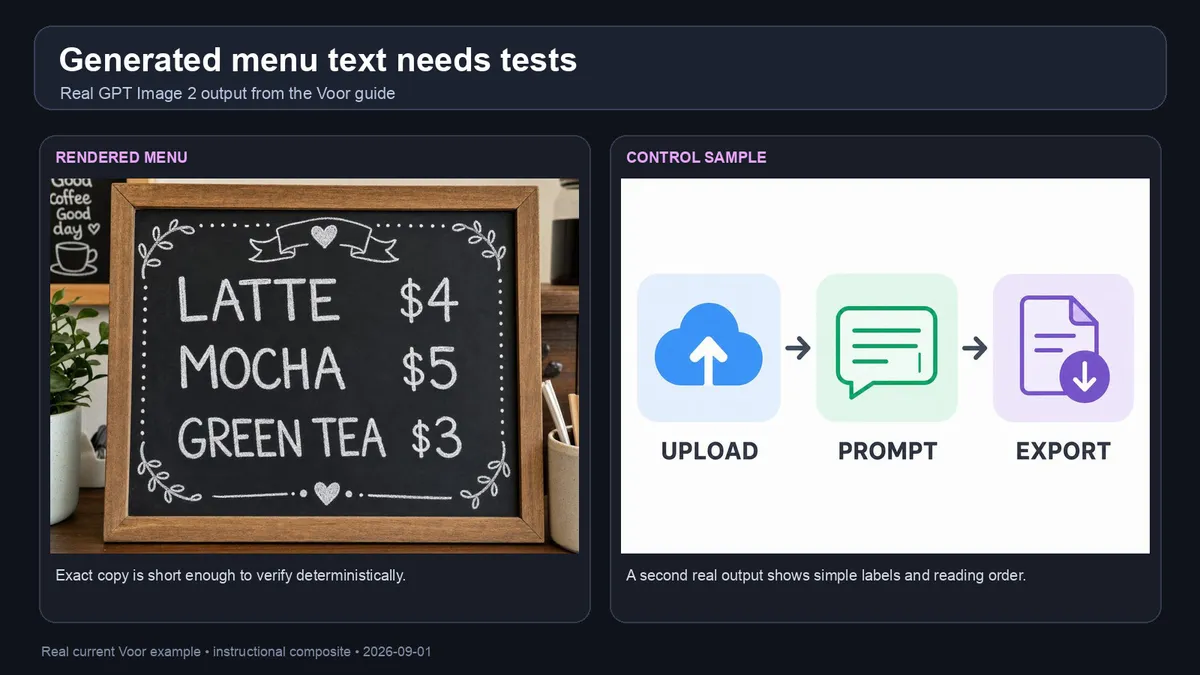
نویسهخوانی نوری (OCR) — شبیه به چشمک زدن سریع روی متن برای تبدیل عکس به حروف قابل تایپ — در سطح کل تصویر اغلب شکست میخورد، زیرا نشانههای پسزمینه و متنهای تزئینی را با ستونهای منو ترکیب میکند. راهکار پیشنهادی، رویکردی دقیقتر است:
- برش نرمالشده (Normalized Cropping): تعریف جعبههای برش به صورت کسری تا تستها با تغییر رزولوشن از بین نروند. با استفاده از کتابخانه PIL، میتوان نواحی عنوان، اقلام و فوتر را به صورت مختصات نسبی تعریف کرد.
- نرمالسازی محدود: تبدیل متن به حروف بزرگ و حذف فضاهای خالی با استفاده از regex، اما اجتناب از نگاشتهای «تقریبی» (مثل تبدیل 0 به O) که میتواند خطاهای قیمت را پنهان کند. برای قیمتها، سیستم باید توکنهای دقیق را به صورت مجزا تأیید کند.
- تأکیدات منفی (Negative Assertions): رد کردن صریح کلماتی مثل "LOREM" یا هر آیتمی که در دادههای منبع وجود ندارد. این شامل شمارش توکنهای ارز برای اطمینان از عدم تولید قیمتهای جعلی است.
- تست روابط: استفاده از تأکیدات ناحیهای برای اطمینان از اینکه هر قیمت با غذای درست جفت شده است، نه اینکه فقط جایی در صفحه ظاهر شده باشد.
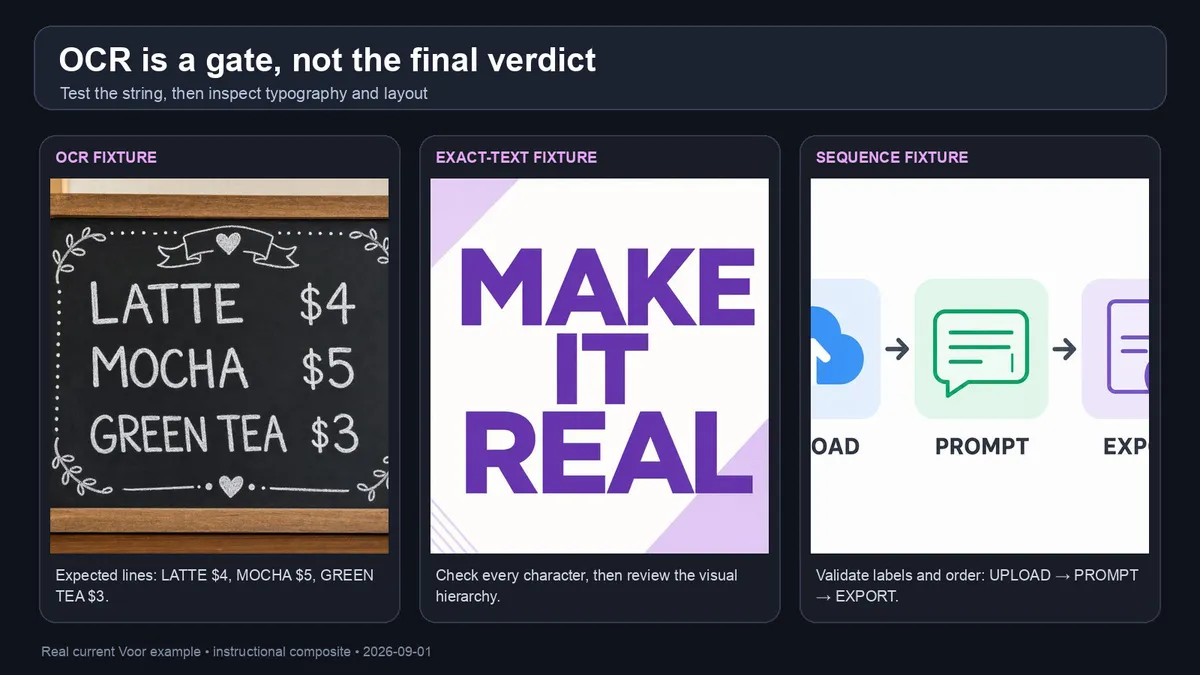
اعتبارسنجی باید هم در رزولوشن اصلی و هم در اندازه نهایی تحویل انجام شود. منویی که در ۲۰۴۸ پیکسل تأیید میشود، ممکن است در یک کارت ۶۰۰ پیکسلی غیرقابلخوان شود. این تغییر، فرض بنیادی تولید تصویر با هوش مصنوعی را از یک «عمل خلاقانه» به یک «وظیفه رندر داده» تبدیل میکند.
برای پشتیبانی از این روند، توسعهدهندگان باید گزارشهای شکست قابلبررسی بسازند. این گزارش باید تصویر اصلی، مستطیلهای برش، متن OCR هر ناحیه و تفاوتهای تأکید (Assertion Diffs) را برگرداند. گنجاندن تنظیمات مدل به عنوان متادیتا کمک میکند تا بفهمیم خطا از سمت مولد تصویر بوده، یا برش اشتباه بوده و یا موتور OCR دچار لغزش شده است.
با این حال، اتوماسیون محدودیتهایی دارد. OCR رشتههای متنی را تأیید میکند، نه تایپوگرافی، سلسلهمراتب بصری، کنتراست یا معنای فرهنگی را. یک بازبین انسانی همچنان آخرین گیت برای صحت تجاری و بصری است. قانون ساده است: متن تولیدشده، دادهای با نمایش بصری است، نه تزئینی که امیدوار باشیم درست باشد.
گام بعدی شما
- برای پروژههای تولید انبوه، یک فایل JSON به عنوان منبع حقیقت برای تمام متون بصری ایجاد کنید.
- از کتابخانه PIL برای تعریف نواحی برش نسبی (Fractional) استفاده کنید تا تستهای شما به رزولوشن وابسته نباشند.
- یک گزارش خطای بصری طراحی کنید که تصویر را با مستطیلهای قرمز (نواحی شکست OCR) به توسعهدهنده نشان دهد.
اما چالش اصلی در اینجا، مدیریت توکنهای بصری در مدلهای چندوجهی است — به تحلیل ما دربارهی مدلهای VLM مراجعه کنید.



گفتگو