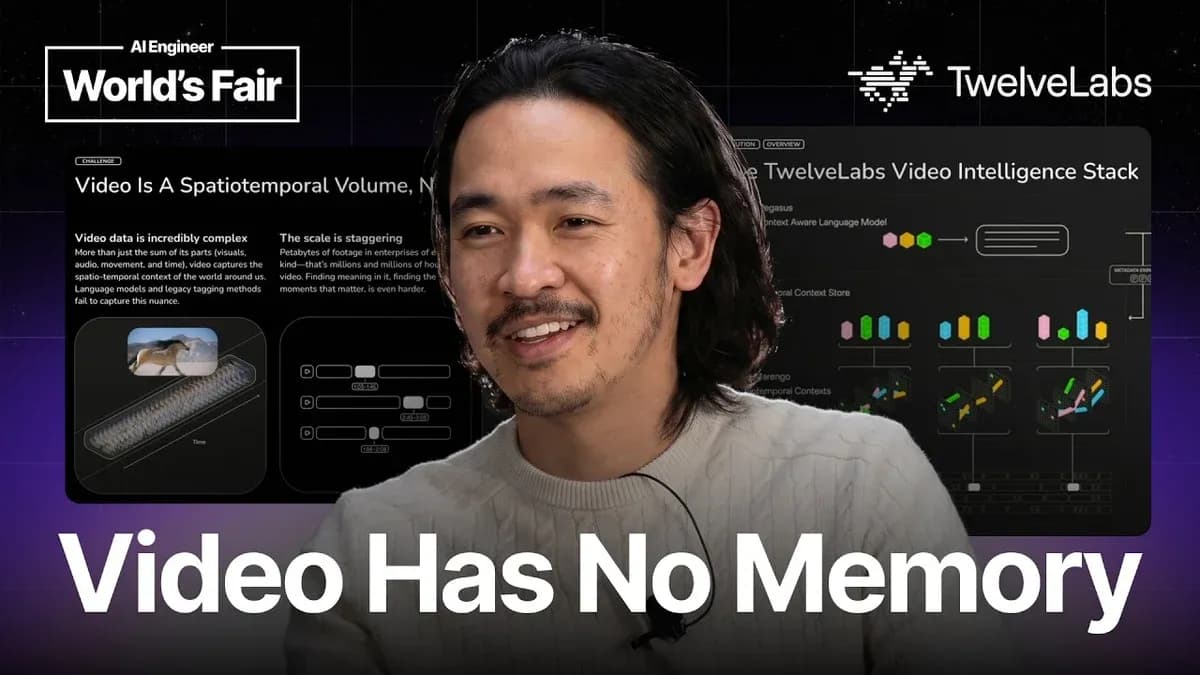
اکثر مدلهای فعلی در درک ویدیو شکست میخورند چون با آن مانند مجموعهای از عکسهای پراکنده یا یک متن ساده برخورد میکنند. جیمز لی (James Le) از شرکت TwelveLabs در نمایشگاه مهندسی هوش مصنوعی استدلال کرد که با حذف بستر مکانی-زمانی حیاتی، سیستمهای فعلی هوش مصنوعی ویدیو اساساً نسبت به ماهیت پیوسته زمان و مکان کور میمانند. این مسئله مانع از دست یافتن به درک واقعی میشود که برای این رسانه ضروری است.
شکست هوش مصنوعی فعلی در تحلیل ویدیو
بسیاری از معماریهای فعلی هوش مصنوعی بهاشتباه اصول مدلهای زبانی را روی ویدیو پیاده کردهاند. لی خاطرنشان کرد که ویدیو صرفاً مجموعهای از تصاویر نیست، بلکه یک «حجم مکانی-زمانی» (spatiotemporal volume) پویا است. این حجم شامل دادههای بصری، دیالوگها، صداها، حرکتها، نویسهخوانی نوری (OCR) و تغییرات زاویه دوربین است.
تداوم و روابط متقابل در این حجم برای درک واقعی ضروری است. با این حال، سیستمهای کنونی معمولاً این ابعاد به تکههای پراکنده یا متون ساده کاهش میدهند. لی این وضعیت را یک «کمبود سیستماتیک حافظه» مینامد. این نقص منجر به سه شکست ساختاری اصلی میشود:
- رویکرد کیسه فریمها (Bag of Frames): برخورد با ویدیو به عنوان توالی تصاویر ایستا یا نسخههای پیادهسازی شده از متن، که باعث نادیده گرفتن بستر حیاتی مکانی-زمانی میشود.
- اجبار متنی (Textual Forcing): تلاش برای گنجاندن ویدیو در توالیهای متنی، که منجر به دور انداختن تعاریف رویدادها و روابطی میشود که ذاتیِ رسانه بصری هستند.
- حافظه گذرا (Transient Memory): فقدان حافظه پایدار؛ به این معنا که سیستمها نمیتوانند اطلاعات را در بخشهای مختلف یک ویدیو حفظ کرده یا دوباره فراخوانی کنند. این موضوع توانایی سیستم را در انجام تحلیلهای پیچیده فلج میکند.
لی تأکید کرد که ایجاد حافظه مؤثر به دلیل ویژگیهای ذاتی ویدیو بسیار دشوار است. این ویژگیها شامل تراکم بالای دادهها، ابهام، هزینه بالای پردازش، چندوجهی بودن و وابستگیهای زمانی پیچیده است.

زیرساخت Jockey: یک لایه حافظه تخصصی
برای حل این محدودیتها، شرکت TwelveLabs یک زیرساخت شناختی جدید به نام Jockey توسعه داده است. باید توجه داشت که Jockey یک نرمافزار ویرایشی مستقل نیست، بلکه یک «زیرساخت شناختی» بنیادین است که برای ایجاد قابلیتهای پیشرفته از طریق یک API قدرتمند و فرآیندهای جذب (Ingestion) قابل پیکربندی طراحی شده است. این رویکرد در واقع تمرکزی بر توسعه لایههای زیرساختی است، مشابه بحثهایی که درباره سرمایه گذاری در زیرساختهای سختافزاری و نرمافزاری AI در مقابل برنامههای کاربردی صورت میگیرد.
به جای پردازشهای استاندارد، این سیستم از یک خط لوله (Pipeline) نوآورانه و خاص استفاده میکند:
- تکهبندی معنایی (Semantic Chunking): سیستم با پردازش ویدیو به «تکههای معنایی» شروع میکند که نشاندهنده واحدهای زمانی معنادار هستند.
- Morango: یک رمزگذار (Encoder) مکانی-زمانی تخصصی است که این تکههای معنایی را به بردارهای معنایی (Vector Embeddings) تبدیل میکند.
- ذخیرهساز بستر مکانی-زمانی (Spatiotemporal Context Store): یک مرکز حافظه مرکزی است که برای حفظ ساختارهای قابل استفاده مجدد، از جمله لحظات خاص، موجودیتها و متادیتاها طراحی شده است.
- Pegasus: یک مدل زبانی حساس به بستر ویدیو است که بهعنوان لایه استدلالی (Reasoning Layer) عمل میکند. این مدل به هوش مصنوعی اجازه میدهد تا اطلاعات ذخیره شده در مرکز بستر را تفسیر کرده و بر اساس آنها اقدام کند.
بر اساس تحلیلهای فنی، این ساختار «حافظه واقعی» را از جستوجوی ساده متمایز میکند. در حالی که جستوجو میتواند یک لحظه مرتبط را مکانیابی کند، حافظه واقعی معنای عمیقتر را حفظ میکند. این قابلیت به سیستم اجازه میدهد تا به سوالات پیچیدهای پاسخ دهد که نیازمند درک خط زمانی موجودیتها و شواهد بین-پیکرهای (inter-corpus) در حجم عظیمی از فیلمها است.
گراف بستر و اصول عملیاتی
جیمز لی برای فعالسازی درکی عمیقتر، پیشنهاد کرد که مجموعههای ویدئویی به عنوان یک «گراف بستر» (Context Graph) نمایش داده شوند. این یک نمایش پایدار و قابل پرسوجو (Queryable) است که لحظات، موجودیتها، ظهورها، روابط و بستر سطح پیکره را به هم متصل میکند. این گراف به برنامهها اجازه میدهد تا محتوای ویدئویی را از زوایای متعدد و در نقاط مختلف زمانی پیمایش کنند.
برای تضمین استواری این لایه حافظه، لی پنج اصل کلیدی را تعریف کرد:
- دسترسی به حافظه (Memory Access): کارایی در بازیابی و بهرهبرداری از اطلاعات ذخیره شده.
- برنامهریزی وظایف (Task Planning): توانایی سیستم در ایدهپردازی و برنامهریزی اقدامات خاص بر اساس آنچه در حافظهاش موجود است.
- بازیابی (Retrieval): دقت در بهدست آوردن تکههای خاصی از اطلاعات از ذخیرهساز حافظه.
- استفاده از ابزار (Tool Utilization): ادغام ابزارها یا توابع خارجی در صورت نیاز.
- پوششهای عملیاتی و قراردادهای خروجی (Operational Wrappers and Output Contracts): تعریف مرزهای عملیاتی و نتایجی که سیستم باید تحویل دهد.
در این پارادایم، مدلهای هوش مصنوعی بازیگران اصلی نیستند، بلکه تسهیلکننده «کارگران ویدئو» (Video Workers) هستند. این کارگران در سیستم فعالیت میکنند تا وظایف را برنامهریزی کنند، شواهد را بازیابی نمایند و نتایج را ترکیب کنند. با این روش، سیستم از حدسهای احتمالی فراتر رفته و به سمت «سنتز مبتنی بر شواهد» حرکت میکند.
باز کردن کاربردهای جدید صنعتی
سیستم Jockey در حال حاضر در وضعیت بتای خصوصی قرار دارد. این سیستم ذخیرهسازهای دانش و قابلیتهای مبتنی بر API را فراهم میکند که چندین مورد استفاده با تأثیر بالا را فعال میسازد:
۱. رسانه و سرگرمی: ارتقای کشف محتوا، تولید خلاصههای دقیق و ایجاد توصیههای بسیار شخصیسازی شده.
۲. امنیت عمومی و امنیت تجاری: فعالسازی تحلیل سریعتر حوادث، بازیابی بهینهتر شواهد و شناسایی پیشکنشانه تهدیدات.
۳. تبلیغات و اقتصاد سازندهها: تسهیل استفاده مجدد از محتوای موجود، تحلیل روندهای نوظهور و تولید خودکار هایلایتها و خلاصهها.
برای جامعه فنی، این یک چرخش بنیادین از «نمونهبرداری فریم» (Frame-sampling) به سمت «پردازش حجمی» (Volume-processing) است. با جداسازی لایه استدلالی (Pegasus) از ذخیرهساز حافظه، TwelveLabs هوش مصنوعی ویدئو را به تداوم زمانی انسان نزدیکتر میکند. این تغییر بخشی از تکامل گستردهتر هوش مصنوعی است که در آن مرزهای پردازش به حوزههای جدید و پیچیده گسترش مییابند.
توسعهدهندگانی که در حال ساخت گردشهای کاری سازماندهی یا اسمبل محتوا هستند، ممکن است بخواهند بتای خصوصی Jockey را زیر نظر بگیرند تا ببینند آیا این تغییر معماری از خطلولههای سنتی ویدئو مبتنی بر RAG عملکرد بهتری دارد یا خیر. در این راستا، بررسی چالشهای کیفیت داده در سیستمهای بازیابی اطلاعات، مانند جلوگیری از مسمومسازی دادهها در خطلولههای RAG، برای تضمین صحت خروجیهای Jockey ضروری است.
گام بعدی شما
- بررسی مستندات API شرکت TwelveLabs برای درک تفاوت پردازش حجمی با RAG سنتی.
- دنبال کردن وضعیت بتای خصوصی Jockey برای پیادهسازی در گردشهای کاری سازماندهی محتوا.
- تحلیل مقایسهای میان مدلهای VLM فعلی و رویکرد گراف بستر در بازیابی اطلاعات.
این تنها آغاز ماجراست؛ اثر موجگونهی این تصمیم بر استانداردها و هزینههای استنتاج ویدیو را در گزارش بعدی بررسی خواهیم کرد.



گفتگو