تصور کنید مهندسی در یک میدان نفتی باشد که بدون نیاز به اینترنت یا سرورهای ابری، مدلهای پیچیده پیشبینی خرابی را مستقیماً روی لپتاپ خود آموزش دهد. این دیگر یک سناریوی تخیلی نیست، بلکه قابلیت اصلی کنسول VIGÍA-ML است.
طبق گزارش فنی منتشر شده در ۳۱ اوت ۲۰۲۶، این سامانه میتواند مدلهای LSTM و خودرمزگذار (Autoencoder) — شبیه به فیلترهایی که دادههای حجیم را فشرده کرده و الگوهای پنهان را بیرون میکشند — را تنها در ۱۰ ثانیه و با استفاده از واحد پردازش گرافیکی (GPU) محلی کاربر در مرورگر آموزش دهد.
در حالی که اکثر دموهای هوش مصنوعی در مرورگر تنها به طبقهبندی ساده تصاویر میپردازند، VIGÍA-ML یک خط لوله صنعتی کامل برای نگهداری پیشبینانه پیاده کرده است. این سیستم بهجای تکیه بر نویزهای تصادفی، فیزیک پیچیدهای مانند «بارگذاری مایع» و «شکست سنسورها» را شبیهسازی میکند تا مدلها واقعاً یاد بگیرند.
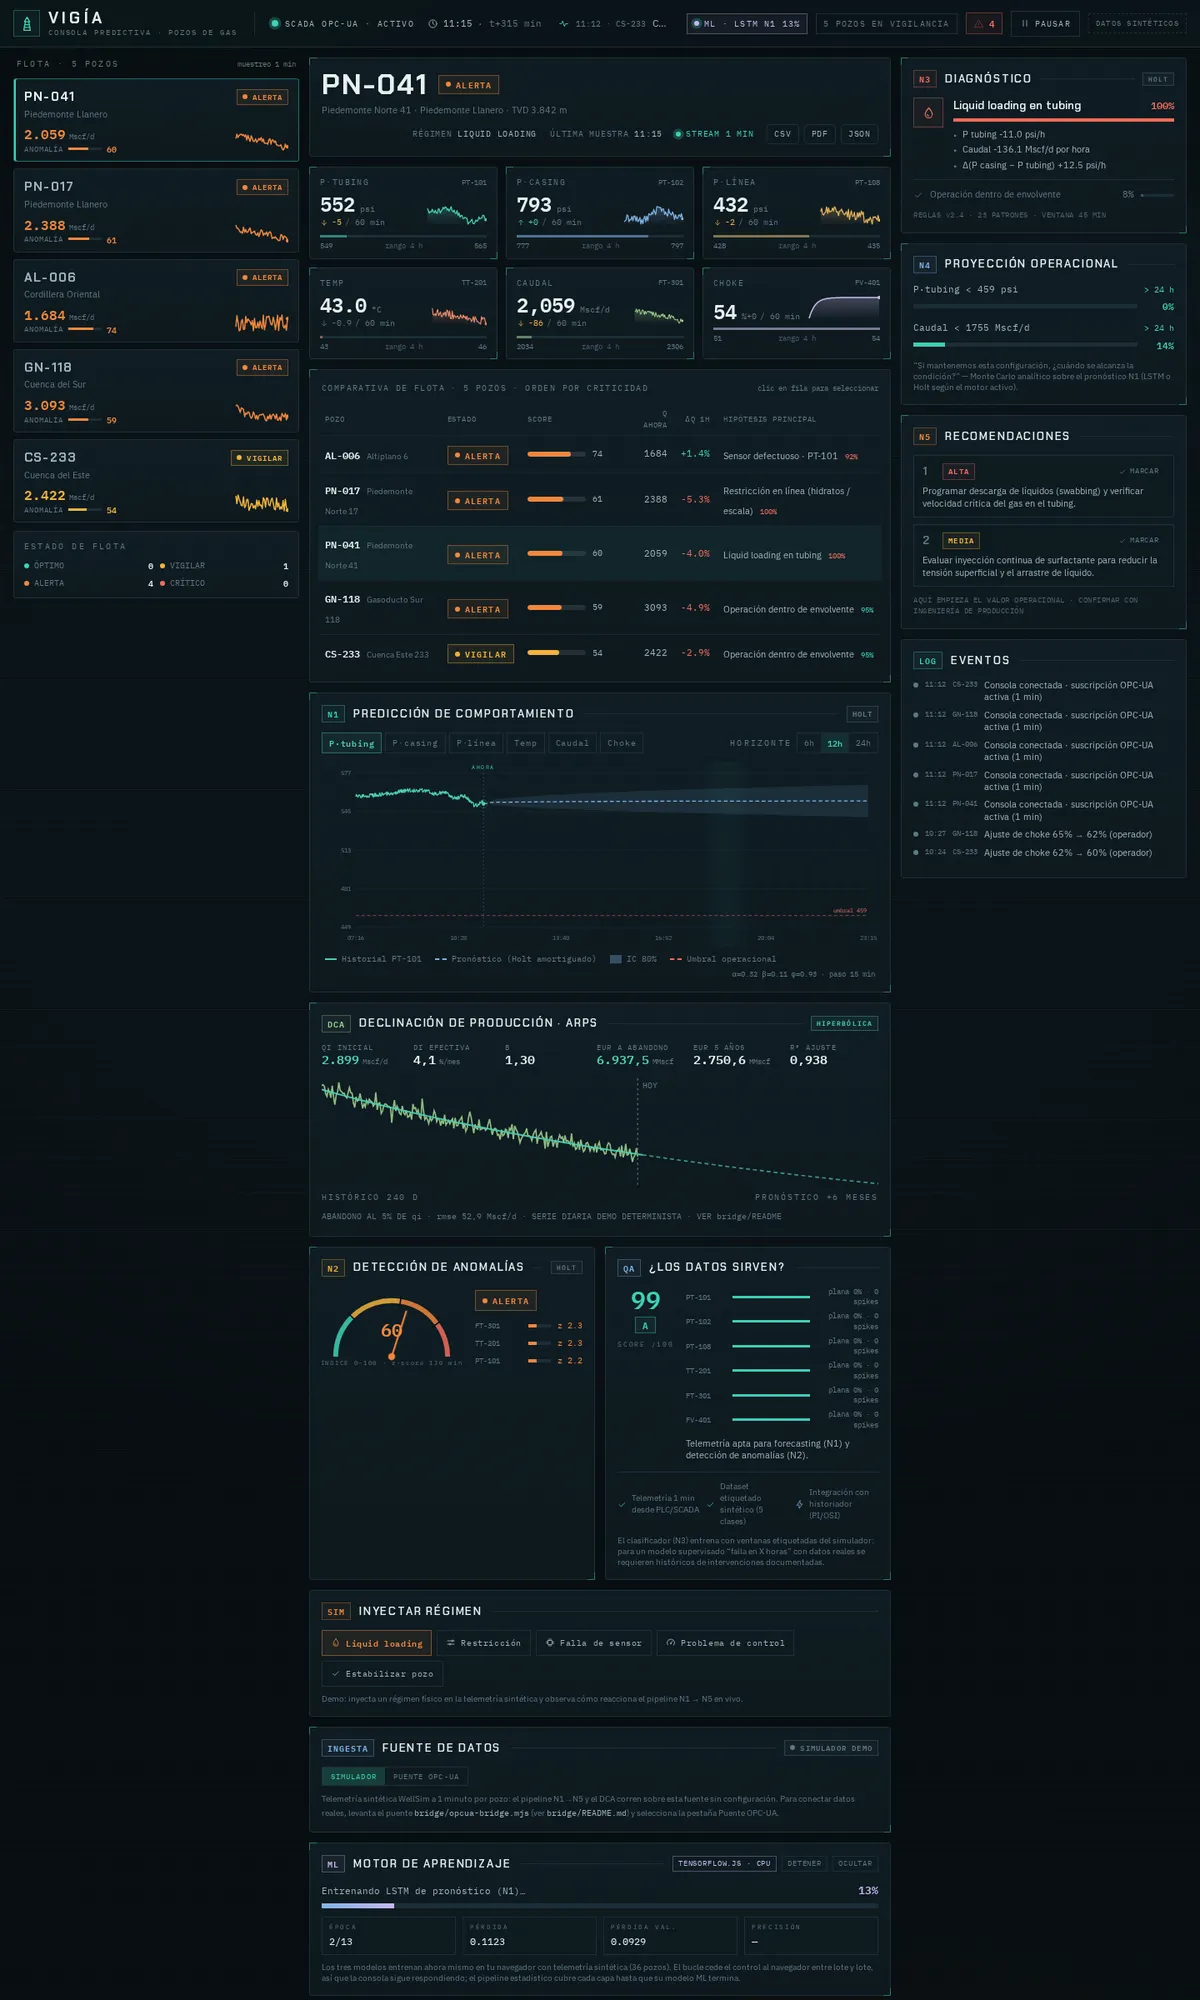
همانطور که در تحلیلهای پیشین ما دربارهی رایانش لبه اشاره کردیم، حذف واسطههای ابری کلید افزایش حریم خصوصی است. این رویکرد در حالی توسعه مییابد که برخی بنچمارکهای اخیر در پلتفرم Pipette، شکاف عملکردی قابلتوجهی را میان مدلهای محلی و ابری نشان دادهاند که بهینهسازیهای VIGÍA-ML سعی در کاهش آن دارد. معماری این سیستم از پنج لایه مجزا تشکیل شده که هر کدام یک «پشتیبان آماری» دارند تا در صورت شکست مدل، رابط کاربری هرگز خالی نماند:
- N1 (پیشبینی): استفاده از LSTM(28) برای پیشبینیهای ۶، ۱۲ و ۲۴ ساعته (پشتیبان: Damped Holt).
- N2 (شاخص ناهنجاری): بهکارگیری یک خودرمزگذار متراکم (۱۸۰→۷۲→۲۰→۷۲→۱۸۰) (پشتیبان: z-scores چندمتغیره).
- N3 (تشخیص): طبقهبندیکننده سافتمکس (Softmax) ۵ کلاسه (پشتیبان: موتور فیزیک ۲۳ قانونی).
- N4 (برآورد): شبیهسازیهای مونتکارلو برای احتمال عبور از آستانه.
- N5 (اقدامات): تلفیقی از لایه N3 و توصیههای مبتنی بر قانون.
به نقل از مستندات توسعهدهنده، برای جلوگیری از هنگ کردن مرورگر هنگام آموزش مدل، موتور پردازشی درون یک Web Worker اجرا میشود. این سیستم با استفاده از توابع trainOnBatch() و tf.nextFrame() نرخ ۶۰ فریم بر ثانیه را حفظ میکند و اگر آموزش مدل از سقف زمانی تعیینشده فراتر رود، سیستم بهطور خودکار توقف کرده و با وزنهای فعلی مدل را تحویل میدهد.
یکی از چالشهای فنی اصلی، نشت حافظه بود. توسعهدهنده متوجه شد که بازآموزی مدل، موتور قدیمی را متوقف میکند اما Worker آن را از حافظه پاک نمیکند؛ مشکلی که اکنون با یک توالی صریح «لغو و حذف» برطرف شده است. این چالش در مدیریت منابع، یادآور رویکردهای نوین مدیریت حافظه مجازی در کتابخانه vLLM است که برای افزایش بازدهی مدلهای زبانی به کار میرود. همچنین برای نمایش عدم قطعیت، سیستم بهجای مدلهای سنگین بیزی، از انحراف معیار باقیمانده روی دادههای اعتبارسنجی برای ایجاد بازه اطمینان ۸۰٪ استفاده میکند.
این رویکرد ثابت میکند که خط لولههای استنتاج چندمرحلهای و پیچیده میتوانند کاملاً روی لبه (Edge) زندگی کنند. برای کاربر، این یعنی تأخیر صفر در فراخوانی API و حریم خصوصی مطلق، زیرا دادههای تلهمتری هرگز دستگاه را ترک نمیکنند.
با این حال، توسعهدهنده هشدار میدهد که صحت ۹۵ درصدی گزارششده، حاصل دادههای شبیهساز است و استقرار واقعی نیازمند تاریخچه مداخلات مستند برای عبور از دادههای مصنوعی است.
گام بعدی شما
- اگر مهندس داده هستید، کد این پروژه را که تحت لایسنس AL-1.0 در گیتهاب منتشر شده بررسی کنید.
- شبیهساز داخلی را برای تست پایداری Web Workerها در پردازشهای سنگین به کار بگیرید.
- معماری «همزاد آماری» را برای جلوگیری از کرش کردن UI در پروژههای ML خود پیاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو