تصور کنید برای هر پیشنهاد سادهی هشتگ در شبکههای اجتماعی، چهار دلار هزینه پرداخت کنید؛ این همان فاجعهی مالی است که بسیاری از شرکتها با ارسال تمام پرامپتها به مدلهای پیشرو تجربه میکنند. در ۱۴ اکتبر ۲۰۲۶، یک راهنمای فنی در dev.to الگوی Waterfall Router (مسیریاب آبشاری) را معرفی کرد تا جلوی این اتلاف منابع را بگیرد.
بسیاری از تیمهای سازمانی چرخه تکراری و خطرناکی را طی میکنند: ابتدا با قدرتمندترین مدل موجود شروع میکنند، یک هفته عملکرد بینقصی را میبینند و سپس با یک صورتحساب فاجعهبار مواجه میشوند. اکنون صنعت به سمت معماری مسیریابی حرکت میکند که با محاسبات هوش مصنوعی زاینده (Generative AI) — شبیه به نحوه مدیریت ترافیک در شبکههای اینترنتی — برخورد میکند. در این سیستم، بهجای یک «مغز» واحد، یک سلسلهمراتب وجود دارد که در آن مدلهای ارزانقیمت، اولین خط دفاعی هستند.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی هزینههای استنتاج اشاره کردیم، این الگو از دههها تجربه مسیریابی در لبههای CDN و سرورهای اپلیکیشن الهام گرفته است. این رویکرد مشابه تجربهی سیستم Jev Router در کاهش هزینههای ابزارهای AI است که نشان داد میتوان بدون افت دقت، هزینهها را به شدت کاهش داد. منطق اصلی ساده است: ابتدا ارزانترین مسیر را امتحان کن، میزان اطمینان از نتیجه را بسنج و تنها زمانی که سیستم با یک محرک ابهام یا سیاست خاص مواجه شد، درخواست را به سطح بالاتر ارجاع بده. طبق این گزارش، بسیاری از اپلیکیشنهای سازمانی میتوانند ۷۰ تا ۸۵ درصد ترافیک خود را بدون افت کیفیت، روی مدلهای کوچک و سریع مدیریت کنند.
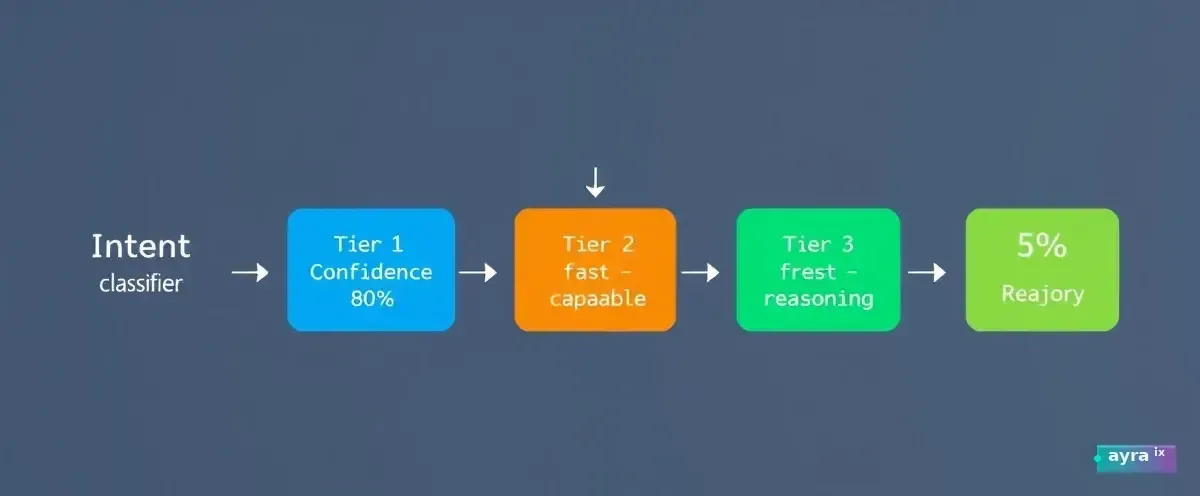
معماری سه لایه
برای ایجاد تعادل بین هزینه و عملکرد، یک مسیریابی موثر معمولاً به سه سطح هوش نیاز دارد:
- لایه ۱ (سریع): حدود ۸۰ درصد ترافیک را مدیریت میکند. اینها مدلهای زبانی کوچک (SLM) — مثل دستیاری که فقط کارهای روتین و تکراری را بلد است — با حدود ۸ میلیارد پارامتر هستند.
- لایه ۲ (توانمند): حدود ۱۵ درصد ترافیک را بر عهده دارد و کارهایی را انجام میدهد که به ظرافت بیشتری نسبت به لایه پایه نیاز دارند.
- لایه ۳ (استدلالی): برای ۵ درصد برتر درخواستها رزرو شده است؛ مواردی که به منطق عمیق یا دقت بسیار بالا نیاز دارند و توسط مدلهای استدلالی (Reasoning Model) — شبیه به شطرنجبازی که چند حرکت جلوتر را میبیند — پردازش میشوند.
ساخت مسیریاب
پیادهسازی این معماری نیازمند یک جریان مرجع داخلی است. فرآیند با طبقهبندی قصد کاربر (Intent) توسط یک مدل بسیار کوچک یا قوانین ساده شروع میشود تا از تحلیل بیش از حد در گام اول جلوگیری شود. پس از طبقهبندی، سیستم با استفاده از logprobs، یک مرحله خودارزیابی یا یک تاییدکننده ارزانقیمت، به نتیجه امتیاز اطمینان میدهد.
برای جلوگیری از هزینههای خارج از کنترل، مسیریاب باید با یک بودجه مشخص عمل کند و هزینه استنتاج در هر کاربر یا نشست را محدود نماید. در نهایت، هر اقدام باید ثبت شود. از آنجا که آستانههای پذیرش نیاز به تنظیم مداوم دارند، تیمها باید انتظار داشته باشند که در هفتههای اول استقرار، این تنظیمات را بهصورت هفتگی بازبینی کنند.
پیادهسازی امتیازدهی اطمینان
ساخت یک مسیریاب نیازمند مدرک دکترا در یادگیری ماشین نیست. این راهنما پیشنهاد میکند با روشهای سادهای مثل regex برای دستهبندی قصد کاربر، بررسی طول توکن یا محرکهای کلیدواژهای برای دستههای پرخطر (مانند «حقوقی»، «قرارداد» یا «حذف همه») شروع کنید.
برای رویکردی پویاتر، توسعهدهندگان میتوانند یک «مرحله خودارزیابی» را پیاده کنند. این کار شامل پرسیدن این سوال از مدل سریع است که «آیا به جواب خود اطمینان داری؟» پیش از آنکه توکنهای گرانقیمت لایه استدلالی مصرف شوند. هرگونه اختلاف نظر بین لایهها ثبت میشود و این دادهها به مجموعه آموزشی اصلی برای ساخت یک طبقهبندیکننده پیشرفتهتر در نسخه ۲ تبدیل میشوند.
حفاظهای تولیدی و تنظیمات
مسیریابی بیش از آنکه یک مسئله زیرساختی باشد، یک رفتار محصولی است. بر اساس مستندات، کاربران تأخیر (Latency) را بسیار زودتر از اینکه متوجه شوند کدام مدل در حال اجراست، حس میکنند. برای مدیریت این موضوع، چند مکانیسم ایمنی پیشنهاد شده است:
- مسیریابی چسبنده (Sticky Routing): گفتگوهای چندمرحلهای در همان لایهای که شروع شدهاند میمانند تا کاربر با تغییر ناگهانی سرعت پاسخها دچار سردرگمی نشود.
- بودجههای کاربر-محور: سقف هزینهکرد لایه پریمیوم برای هر نشست جهت جلوگیری از جهشهای قیمتی.
- جایگزینهای زمانبندی (Timeout Fallbacks): اگر مدل لایه ۳ متوقف شد، سیستم بهجای کرش کردن، با یک عذرخواهی ساده، کیفیت را کاهش میدهد. در این راستا، استفاده از روترهای جایگزین برای حذف نقاط شکست میتواند پایداری سیستمهای عاملمحور را در محیط تولید تضمین کند.
- حالت سایه (Shadow Mode): اجرای موازی لایه گرانقیمت در کنار لایه ارزان برای مقایسه نتایج بهصورت آفلاین پیش از تغییر نهایی.
موارد خاص و بحرانی در مسیریابی
همه مسیریابیها را نمیتوان به امتیازات اطمینان سپرد. برخی محرکها باید اولویت اول منطق مسیریابی باشند. تشخیص زبان، حضور اطلاعات حساس شخصی (PII) و کلیدواژههای نظارتی باید بلافاصله باعث ارجاع به لایههای بالاتر شوند.
دستههای پزشکی، حقوقی و ایمنی اغلب فارغ از میزان اطمینان مدل، نیاز به ارجاع اجباری دارند. این موارد باید در یک فایل پیکربندی ثبت شوند، نه اینکه به «دانش شفاهی پرامپتها» تکیه شود. همچنین، درخواستها باید با شناسههای تیم، ویژگی و مشتری برچسبگذاری شوند تا بحثهای بهینهسازی بر اساس داده باشد، نه حدس و گمان.
جلب حمایت سازمانی
مدیران اغلب مدلهای بزرگتر را رمانتیک میکنند، اما هدف واقعی بهینهسازی کیفیت به ازای هر دلار و کاهش تأخیر در ترافیک واقعی است. این راهنما توصیه میکند داشبوردهای هفتگی برای نمایش توزیع ترافیک در لایهها ایجاد شود. وقتی رهبران ببینند ۸۰ درصد کاربران از پاسخهای سریع راضی هستند، فرهنگ داخلی از «همیشه از قویترین مدل استفاده کن» به «ابزار مناسب برای کار مناسب» تغییر میکند.
توسعهدهندگان باید هر درخواست را با لایه، تأخیر، هزینه و بازخورد کاربر (لایک/دیسلایک) تجهیز کنند. این کار مسیریاب را به یک محصول زنده با شاخصهای کلیدی عملکرد (OKR) تبدیل میکند. موفقترین تیمها زمانی جشن میگیرند که ترافیک لایه ۱ رشد میکند، زیرا این یعنی منطق مسیریابی بهطور بهینه عمل میکند.
معیارهای حیاتی
برای نگهداری سیستم، تیمها باید این KPIها را رصد کنند:
- نرخ ارجاع (Escalation Rate): برای شناسایی تغییر رفتار طبقهبندیکننده.
- هزینه به ازای هر تسک موفق: معیاری برای مدیر مالی جهت سنجش بهرهوری.
- تأخیر p95 به تفکیک لایه: ضروری برای تضمین توافقنامه سطح خدمات (SLA).
- تخریب کیفیت پس از شکست ارجاع: اندازهگیری نحوه مدیریت خطاهای لایههای بالا.
استراتژی راهاندازی سرد
از آنجا که در روز اول هیچ لاگی وجود ندارد، راهنما توصیه میکند با قوانین خبرگان دامنه شروع کنید. مثلاً تصمیم بگیرید تمام پرسشهای حقوقی به لایه ۲ و تولید هشتگها در لایه ۱ بمانند. این قواعد باید در ویکی تیم با تاریخ آخرین تغییر و نام مالک ثبت شوند تا از «صورتحسابهای مرموز» جلوگیری شود.
با انباشت ترافیک، این قوانین دستی جای خود را به طبقهبندیکنندههای دادهمحور میدهند. کلید موفقیت این است که همین هفته یک مسیریاب کاربردی با قوانین ساده بسازید، بهجای اینکه یک فصل منتظر یک طبقهبندیکننده کامل یادگیری ماشین بمانید. تقسیمبندی ۸۰/۱۵/۵ تنها زمانی درست عمل میکند که تیم بهطور مداوم آن را تنظیم کند و ویژگیهایی را که ۴۰ درصد ترافیک را برای تنها ۲ درصد بهبود کیفیت ارجاع میدهند، حذف کند.
این تغییر رویکرد باعث میشود مسیریاب به اهرم اصلی کنترل سود و زیان (P&L) هوش مصنوعی تبدیل شود. با تحلیل ترافیک استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند و شبیه به خودِ آشپزی است، نه دورهی آموزش آشپز — تیمها میتوانند تشخیص دهند اگر مدل گرانترین آنها بیش از ۲۰ درصد درخواستها را مدیریت میکند، زمان پیادهسازی Waterfall Router فرا رسیده است.
برای کسانی که امروز شروع میکنند، پیشنهاد یک ساختار دو لایهای ساده است: هر پرامپت را از یک مدل سریع ۸ میلیاردی عبور دهید و تنها زمانی که امتیاز اطمینان به زیر ۰.۷ رسید، آن را به مدل ۷۰ میلیاردی ارجاع دهید. هزینه هر پاسخ صحیح را قبل و بعد از این تغییر اندازه بگیرید تا ارزش واقعی این روش ثابت شود.
گام بعدی شما
- ترافیک فعلی مدلهای خود را تحلیل کنید تا ببینید چند درصد درخواستها واقعاً به قدرت مدلهای Reasoning نیاز دارند.
- یک لایه طبقهبندی ساده بر اساس کلیدواژههای حساس (مانند Legal یا Security) برای ارجاع اجباری پیاده کنید.
- سیستم ثبت هزینه (Cost Attribution) را به تفکیک کاربر و ویژگی فعال کنید تا نقاط اتلاف بودجه را شناسایی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو