یک تغییر تکخطی در بخش ساخت بستر متن میتواند بهسادگی یک داور هوش مصنوعی را نسبت به تمام خطاهایی که برای شناساییشان طراحی شده، کور کند. اگر امروز از عاملهای کدنویس برای توسعه سیستمهای هوش مصنوعی استفاده میکنید، باید بدانید که سرعت بالای آنها میتواند منجر به «پسرفتهای خاموش» شود؛ یعنی کدی که از نظر فنی درست است اما هوش مدل را نابود میکند.
Zoroval این ریسک را در ۱۳ ژوئیه ۲۰۲۶ کشف کرد. در آن تاریخ، سیستم مدل زبانی بهمثابه داور (LLM-as-a-judge) — شبیه داوری که هزاران پرونده را خوانده و حالا بر اساس آن معیارها رای میدهد — چهار مورد شکست قطعی را در یک مجموعه داده مرجع نادیده گرفت، در حالی که تمام تستهای استاندارد کدنویسی را پاس کرده بود. طبق گزارش این شرکت، مدل و پرامپت تغییری نکرده بودند، اما کد مربوط به اسمبل کردن بستر متن (Context) تغییر کرده بود و باعث شد مدل اطلاعات حیاتی را نبیند و در نتیجه تریگرهای ارزیابی موجود را دور بزند.
مورد شکست: ۱۳ ژوئیه
محصول Zoroval از یک LLM-as-a-judge برای خواندن «ردپاها» (Traces) استفاده میکند. این ردپاها در واقع لاگهای گفتگوهای بین عامل هوش مصنوعی شرکت و کاربرانش هستند تا سیستم تصمیم بگیرد آیا یک حالت شکست (Failure Mode) نامگذاری شده در آن وجود دارد یا خیر. در ۱۳ ژوئیه، یک عملیات نظارتی ۱۱۳۸ فراخوانی داور را اجرا کرد. با وجود اینکه در مجموعه دادههای مرجع (Golden Dataset)، چهار مورد شکست وجود داشت که پیشتر توسط انسان تایید شده بود، داور برای هر چهار مورد پاسخ «خیر» داد.
این اجرا بدون حتی یک خطای سیستمی به پایان رسید. چون مدل و قالب پرامپت ثابت بودند، ارزیابیهای استاندارد فعال نشدند. علت ریشهای، «سازنده بستر متن» (Context Builder) بود؛ یعنی همان کدی که تعیین میکند مدل چه چیزی را ببیند. این اتفاق ثابت کرد که سازنده بستر متن درست به اندازه خودِ مدل در سیستمهای هوشمند حیاتی است. اگر در آن زمان، مجموعه داده مرجع پیش از یک اجرای بزرگ روی سازنده بستر متن تست میشد — که برای چهار فراخوانی هزینهای کمتر از یک دلار داشت — مشکل بلافاصله شناسایی میشد.
این مشکل یک شکاف عمیق در عملیات مدلهای زبانی (LLMOps) را نشان میدهد. تستهای سنتی CI فقط بررسی میکنند که آیا خروجی یک JSON معتبر با فیلدهای درست است یا خیر، اما نمیتوانند بفهمند آیا «قضاوت» مدل تغییر کرده است یا نه. این وضعیت یادآور بحران حجم کد در ابزارهای هوش مصنوعی است که در آن سرعت تولید کد، توانایی بازبینی انسانی را به شدت کاهش میدهد. با ظهور عاملهای کدنویسی مثل Claude Code و Codex، سرعت توسعه شتاب گرفته و انسانها دیگر نمیتوانند هر خط از یک Pull Request (PR) هزارخطی را بخوانند. طبق بررسیهای Zoroval، میانگین تغییرات در هر PR حدود ۱۳۳ خط است، اما حدود یک مورد از هر هشت تغییر، بیش از ۱۰۰۰ خط است. در نتیجه، بازبینها یا کد را سرسری میخوانند و تغییرات ظریف منطقی را از دست میدهند، یا PR را روزها متوقف میکنند و سرعت عاملهای کدنویس را خنثی میکنند.
مکانیسم گیت تغییرات هوشمند (Intelligence Change Gate)
برای حل این بحران، Zoroval سامانه «گیت تغییرات هوشمند» را ساخت. این بررسی در مرحله CI، فایلهای خاصی را که میتوانند رفتار مدل را تغییر دهند — مثل پرامپتها، سازندههای بستر متن و کدهای بازیابی (Retrieval) — شناسایی کرده و اجازه ادغام آنها را صرفاً با تستهای سبز نمیدهد، بلکه شواهد تجربی از کیفیت را میطلبد.
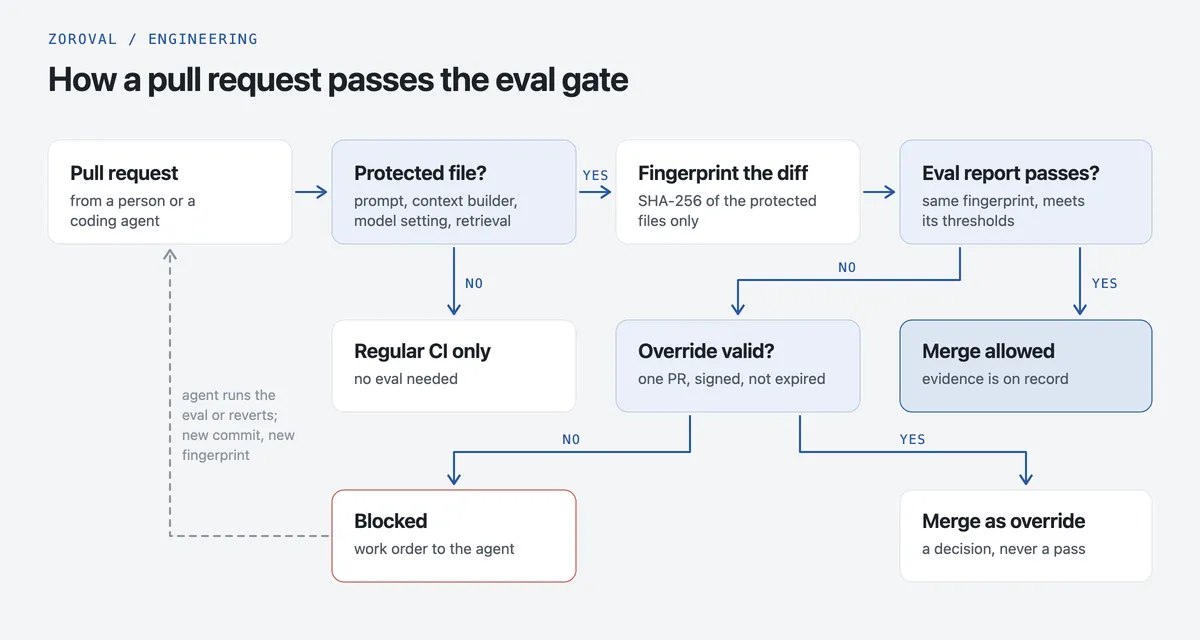
این فرآیند از پنج گام سختگیرانه پیروی میکند:
۱. اعلام مسیرهای حفاظتشده: یک فایل سیاست (Policy File)، تمام مسیرهایی که بر هوش سیستم اثر میگذارند را لیست میکند. این شامل نه تنها فایلهای پرامپت، بلکه کدهای پایتونی است (مانند src/monitor/context_builder.py یا src/monitor/judge.py) که دادهها را به مدل تغذیه میکنند. این سیاست، مسیرها را بر اساس «مراحل» (Stages) مانند نظارت گروهبندی میکند. همچنین از line_patterns برای فایلهای مشترک (مانند src/settings.py) استفاده میکند تا گیت فقط زمانی فعال شود که خطوط خاصی — مثل MONITOR_MODEL یا MONITOR_REASONING — تغییر کنند، نه تغییرات بیربط مثل تایماوت دیتابیس.
۲. انگشتنگاری دقیق تغییرات (Exact-Diff Fingerprinting): گیت فایلهای حفاظتشدهای که تغییر کردهاند را مییابد، Diff فقط آن فایلها را میگیرد و آن را به همراه مراحل و قوانین متأثر با استفاده از SHA-256 هش میکند. اگر یک توسعهدهنده کد را Rebase کند یا یک عامل کدنویس حتی یک کاراکتر به یک خط حفاظتشده اضافه کند، اثر انگشت تغییر کرده و شواهد قبلی باطل میشود. این امر عمدی است؛ کدی که اندازهگیری شده باید دقیقاً همان کدی باشد که ادغام میشود.
۳. گزارشهای ارزیابی اجباری: هر PR که به فایل حفاظتشده بزند، باید یک مانیفست JSON ارائه دهد. این گزارش، اثر انگشت کد را به یک مجموعه داده مرجع متصل کرده و یک خط پایه (Baseline) را با تغییر پیشنهادی مقایسه میکند. این گزارش شامل experiment_id و case_count (مثلاً ۵۰ مورد شامل ۲۰ مورد مثبت شناخته شده و ۳۰ مورد منفی شناخته شده) و نتایجی برای معیارهایی مثل verdict_agreement است. گیت به فیلد passed در JSON اعتماد نمیکند و وضعیت پاس/رد را از روی اعداد خام بازمحاسبه میکند. برای محافظت از دادههای مشتریان، دادههای خام خصوصی میمانند و فقط از طریق هش ارجاع داده میشوند.
۴. باطل شدن خودکار (Automatic Staling): چون تاییدیه به اثر انگشت کد گره خورده است، هر ویرایش بعدی توسط انسان یا عامل، گیت را بهطور خودکار رد میکند. تغییرات در مستندات یا تستها روی اثر انگشت اثر نمیگذارد و اجازه میدهد غلطهای تایپی بدون اجرای مجدد ارزیابیها اصلاح شوند. این کار از خطای رایج «اجرای ارزیابی روی نسخه A و ادغام نسخه B» جلوگیری میکند.
۵. جایگزینی تحت کنترل مالک (Owner-Controlled Overrides): وقتی تیم آگاهانه یک موازنه را میپذیرد — مثلاً اولویت دادن به Recall (بازیابی) بر Precision (دقت) — یک مهندس ارشد میتواند از گزینه «شکستن شیشه» (Break-glass) استفاده کند. این یک فایل مجزا برای آن شماره PR خاص است که اثر انگشت دقیق را نام میبرد و نیازمند یک دلیل و بیانیه ریسک است (مثلاً: «بازبینها هشدارهای کاذب بیشتری خواهند دید»). این overrideها هفت روز اعتبار دارند، باید توسط یک تاییدکننده لیستشده صادر شوند و در CI صراحتاً به عنوان owner_override برچسب میخورند و هرگز به عنوان «پاس» نمایش داده نمیشوند.
ادغام عاملها در چرخه (Integrating Agents into the Loop)
Zoroval خروجی CI را به عنوان یک «دستور کار» برای دور بعدی عامل در نظر میگیرد. وقتی گیت تغییرات هوشمند رد میشود، سیستم یک نتیجه مفصل شامل مراحل متأثر، قوانین تطبیقیافته و اثر انگشت تغییرات خاص را چاپ میکند. سیستم صراحتاً راه حل معمول را به عامل میگوید: «ارزیابی متأثر را اجرا کن و یک مانیفست متناظر را در مسیر evals/experiments/ ثبت کن».
این ساختار به عامل اجازه میدهد تا ارزیابیهای لازم را اجرا کرده و مانیفست را بدون دخالت انسان ثبت کند. در برخی موارد، عامل متوجه میشود که اصلاً قصد نداشته به یک فایل حفاظتشده دست بزند؛ در این صورت تغییر را برمیگرداند و گیت بدون نیاز به ارزیابی پاس میشود. این مکانیسم بهطور موثری «گسترش ناخواسته دامنه تغییرات» (Scope Creep) را شناسایی میکند.
برای جلوگیری از دور زدن این حفاظها توسط عاملها، شرکت از چندین لایه ساختاری استفاده میکند:
- AGENTS.md: فایلی در ریشه پروژه که قوانین مطلق را برای عاملها تعیین میکند؛ قوانینی مثل «هرگز از یک حفاظ شکستخورده عبور نکن»، «هرگز به شاخه main پوش نکن» و «شاخه develop محیط استیجینگ است». این فایل تصریح میکند که تغییرات در مدلها، پرامپتها و بازیابی (Retrieval) حفاظتشده هستند. این قوانین کوتاه و مطلق نگه داشته شدهاند چون عاملها آنها را قابلاعتمادتر از پاراگرافهای پیچیده دنبال میکنند.
- Git Worktrees: هر عامل در Worktree مخصوص به خود و روی شاخه خودش عمل میکند. این کار از بازنویسی کارهای یکدیگر توسط عاملهای موازی در یک Checkout جلوگیری کرده و تضمین میکند اشتباهات ایزوله بمانند.
- CODEOWNERS: اسکریپتهای گیت، فایلهای سیاست و پوشههای override توسط بازبینهای انسانی اجباری محافظت میشوند. برای اجرای این مورد در GitHub، Zoroval گزینه «Require review from Code Owners» را در قوانین حفاظت از شاخه فعال کرده و گیت را به عنوان یک بررسی وضعیت (Status Check) اجباری قرار داده است. چون گیتهاب اجازه نمیدهد نویسنده PR کار خودش را تایید کند، به عاملها حسابهای کاربری مجزا داده شده تا مانع کار مالک نشوند.
خط لوله تولید (The Production Pipeline)
فراتر از گیت PR، Zoroval از یک دفاع چهار لایه استفاده میکند: محلی (Local)، Pull Request، استیجینگ (Staging) و تولید (Production).
- محلی: عاملها میتوانند پیش از Push، گیت ارزیابی را روی لپتاپهای خود با دستور
python tools/validate_intelligence_change.py --base origin/develop --head HEADاجرا کنند. - Pull Request: هر PR، CI محصول را اجرا میکند. این شامل گیت ارزیابی و «ارزیابیهای پسرفت» (
python tools/run_evals.py --suite ci) است. ارزیابیهای پسرفت از موارد مصنوعی منجمد شده با ورودی/خروجیهای ثبتشده LLM استفاده میکنند تا تضمین کنند کد اطراف مدل هنوز همان رفتار قبلی را دارد، بدون اینکه فراخوانیهای جدیدی به مدل ارسال شود. این رویکرد برای مقابله با تستهای توخالی است که در آن عاملها تستهایی مینویسند که چراغ سبز میدهند اما در واقع هیچ منطق حیاتی را ارزیابی نمیکنند. - استیجینگ: ادغام در
developمنجر به استقرار در استیجینگ میشود. اینجا جایی است که اشتباهات پذیرفته میشوند و هزینه آنها یک Revert است نه یک حادثه عملیاتی. نکته حیاتی این است که ادغام در استیجینگ هرگز مجوز انتشار در تولید را نمیدهد؛developهرگز مستقیماً درmainادغام نمیشود. - تولید: این تنها جایی است که هر بار تصمیم انسانی الزامی است.
انتشارات تولید از طریق Squash Commitهای انتخابی مدیریت میشوند. مالک، PRهای دقیقی را که باید منتشر شوند نام میبرد و یک شاخه انتشار از main فعلی شروع میشود. تایید نهایی یک «LGTM» کلی نیست، بلکه کامنتی است که به یک SHA دقیق از کامیت متصل است (مثلاً: «تایید PR شماره ۵۰۲ در 1a6e515...»). یک گارد بررسی میکند که Head هنوز همان SHA باشد، بنابراین هر کامیت جدید، تاییدیه را باطل میکند.
علاوه بر این، هر انتشار باید اثر هزینه LLM خود را اعلام کند — در دستههای: بدون تغییر، کاهش، افزایش، یا مسیر پرداخت جدید. در سیستمهای LLM، هزینه به عنوان یکی از معیارهای اصلی صحت در نظر گرفته میشود؛ تغییری که صورتحساب را دو برابر کند، یک پسرفت (Regression) محسوب میشود.
محدودیتهای سیستم
طبق گزارش Zoroval، این گیت یک راهکار جادویی نیست و فقط به اندازه مجموعه داده مرجع قدرتمند است. برای مثال، یک بار مدلی را تست کردند که ۶ برابر ارزانتر بود. این مدل بررسی اول را پاس کرد چون مجموعه داده مرجع فقط نمونههای مثبت داشت (اندازهگیری Recall). اما در یک مقایسه گستردهتر، مدل مواردی خارج از محدوده را علامتگذاری کرد چون بخشی از تعریف را نادیده گرفته بود (شکست در Precision). مدل تنها پس از ارزیابی با هر دو مورد مثبت و منفی به تولید رسید و در نهایت هزینههای نظارت را ۸۳٪ کاهش داد.
گیت همچنین نمیتواند تایید کند که اعداد گزارش شده صادقانه هستند، زیرا CI فقط بررسی میکند که هشها درست شکل گرفته باشند. همچنین نمیتواند بررسی کند که آیا آستانهها (Thresholds) درست هستند یا مجموعه داده نماینده واقعی کاربران است. بازبینی انسانی برای امنیت، معماری و ارزیابی نهایی آستانههای گزارش همچنان اجباری است.
این تغییر در رویکرد، نقش انسان را از «بازبین خطوط کد» به «بازبین شواهد» تبدیل میکند. مهندس ارشد بهجای اسکن ۱۰۰۰ خط Diff، یک بسته تاییدیه تکصفحهای شامل SHA، اثر هزینه و نتایج ارزیابی را بررسی میکند. این تضمین میکند که در حالی که عاملها کد را مینویسند، انسانها مالک قوانین و تصمیم نهایی باشند.
گام بعدی شما
- اگر از عاملهای کدنویس استفاده میکنید، لیستی از «فایلهای حساس به هوش» (مانند پرامپتها و Context Builderها) تهیه کنید و آنها را از تغییرات خودکار بدون ارزیابی مصون دارید.
- یک مجموعه داده مرجع (Golden Dataset) کوچک اما متنوع (شامل موارد مثبت و منفی) برای حیاتیترین قابلیتهای مدل خود بسازید.
- هزینه استنتاج را به عنوان یک معیار فنی در CI تعریف کنید تا تغییرات کد که منجر به افزایش هزینه میشوند، بهطور خودکار شناسایی شوند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو