
اگر امروز یک فروشگاه سازمانی را مدیریت میکنید، احتمالاً ویجتهای «محصولات مرتبط» (Related Products) یا «مشتریان این محصول را خریدند» (Customers Also Bought) در حال هدر دادن درآمد شما هستند. اکثر پیکربندیهای Adobe Commerce بر قواعد دستی تکیه دارند — مثل «اگر کسی محصول X را خرید، محصول Y را نشان بده» — که با گسترش کاتالوگ و افزایش تعداد کالاها، دیگر پاسخگو نیستند. وقتی کاتالوگ محصولات و پایگاه مشتریان شما رشد میکند، این قواعد ثابت نمیتوانند پا به پای تغییرات پیش بروند.
این سیستمهای صلب نمیتوانند از رفتارهای جدید مشتریان درس بگیرند، پیشنهادات یکسانی را به همه نمایش میدهند و هنگام مواجهه با میلیونها محصول، اغلب کند شده یا به کلی از کار میافتند. نتیجه این وضعیت، نرخ تبدیل (Conversion Rate) ایستا و پایین است که باعث میشود فرصتهای فروش دستنیافته باقی بمانند. این چالشها در واقع بخشی از همان گسستهای تجربه کاربری هستند که ابزارهایی نظیر Boostora با تحلیل نقاط شکست در نرخ تبدیل سعی در شناسایی و بهینهسازی آنها دارند.
این شکاف عملکردی در روزهای ترافیک بسیار بالا، مانند رویدادهای جمعه سیاه (Black Friday)، به یک وضعیت بحرانی تبدیل میشود. طبق پژوهشی که در مجله Discover Computing منتشر شده است، موتورهای توصیهگر سنتی تک-سروری معمولاً تحت فشار زیاد فرو میپاشند. این تحقیق فاش میکند که سیستمهای توزیعشده (Distributed Systems) — که بار پردازشی را بین چندین سرور تقسیم میکنند — میتوانند ۱۵.۶ برابر دادههای بیشتر را مدیریت کنند، در حالی که زمان پردازش آنها تنها ۳.۵ برابر افزایش مییابد. این یک تفاوت عظیم در پایداری عملیاتی است که مانع از توقف فروش در پیک ترافیک میشود.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی هزینههای استنتاج در مقیاس گسترده اشاره کردیم، توزیع بار پردازشی کلید بقای سیستمهای تجاری است. برای حل این مشکل، معماران سیستمهای فروشگاهی اکنون به سمت یک موتور توصیهگر دو بخشی حرکت میکنند که منطق مبتنی بر رفتار (Behavior-based) و منطق مبتنی بر محصول (Product-based) را با هم ترکیب میکند.
بخش اول: مبتنی بر رفتار («مشتریان مشابه چه میخرند؟»)
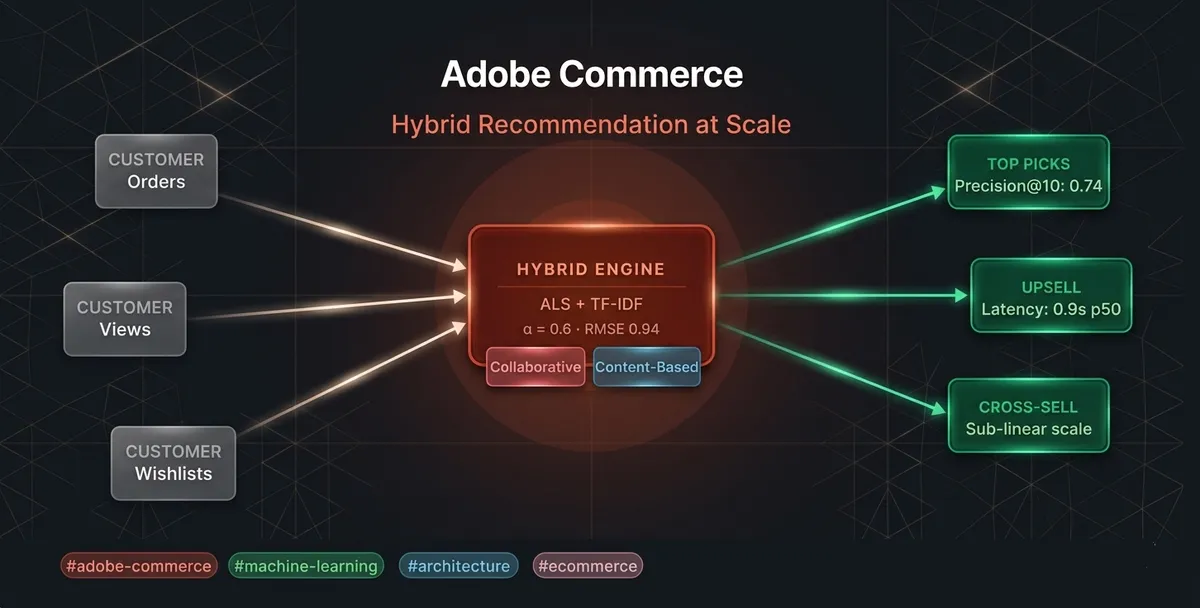
این بخش الگوهای موجود در دادههای مشتری را تحلیل میکند تا خریدارانی با سلیقههای مشابه را در گروههای یکسان قرار دهد. در واقع این مدل پیشبینی میکند که یک خریدار در گام بعدی چه میخواهد، حتی اگر آن کاربر هرگز پیش از این محصول خاص را ندیده باشد. در ساختار Adobe Commerce، این موتور از سیگنالهای رفتاری خاصی تغذیه میکند:
- سفارشات قبلی (که قویترین سیگنال برای پیشبینی است)
- بازدیدهای صفحه محصول (Product Page Views)
- افزودن به سبد خرید و بررسی سبدهای رها شده (Abandoned Carts)
- لیستهای علاقهمندی (Wishlists)
اما چالش اصلی اینجاست: این منطق تنها زمانی به درستی عمل میکند که یک مشتری حداقل ۵ اقدام (Action) در فروشگاه انجام داده باشد تا الگویی برای تحلیل شکل بگیرد. مشتریان کاملاً جدید هیچ سابقهای ندارند، به این معنی که این بخش از موتور در لحظه ورود آنها نمیتواند کمکی کند.
بخش دوم: مبتنی بر محصول («چه محصولاتی مشابه این هستند؟»)
این منطق بر ویژگیهای ذاتی خود محصولات تمرکز دارد و با خواندن اتریبیوتهای (Attributes) بومی محصول، تطابقهای واقعی را پیدا میکند. این روش به هیچ تاریخچهای از مشتری نیاز ندارد و درست در لحظهای که یک محصول جدید به کاتالوگ اضافه میشود، فعال میگردد. این سیستم موارد زیر را تحلیل میکند:
- نام و توضیحات محصول
- مسیرهای دستهبندی (Category Paths)
- ویژگیهای سفارشی (مانند اندازه، رنگ، متریال یا برند)
در حالی که این سازوکار تضمین میکند بازدیدکنندگان جدید فوراً پیشنهادات مرتبط ببینند، نقطه ضعف آن این است که ترجیحات شخصی و سلیقه فردی هر مشتری را نمیشناسد و فقط میداند چه کالاهایی از نظر فیزیکی یا توصیفی به هم شبیه هستند.
قدرت امتیاز ترکیبی (Hybrid Score)
قدرت واقعی زمانی ظاهر میشود که این دو سیگنال در قالب یک امتیاز وزنی تأییدشده ترکیب شوند: امتیاز نهایی = ۶۰٪ سیگنال رفتاری + ۴۰٪ شباهت محصول.
بر اساس نتایج این پژوهش، رویکرد ترکیبی به دقت (Precision) بسیار بالاتری نسبت به سیستمهای تک-مدلی دست مییابد. دادهها نتایج زیر را در زمینه صحت (Accuracy) — که در آن عدد پایینتر نشاندهنده عملکرد بهتر است — و دقت (Precision) نشان میدهند:
- فقط مبتنی بر رفتار: امتیاز صحت ۱.۰۲ | دقت ۶۴٪
- فقط شباهت محصول: (در لیست نتایج ذکر نشده) | دقت ۶۴٪
- ترکیبی (Hybrid): امتیاز صحت ۰.۹۴ | دقت ۷۴٪
دقت ۷۴٪ به این معناست که از هر ۱۰ محصول پیشنهادی، حدود ۷ یا ۸ مورد واقعاً برای کاربر مرتبط هستند. این دقیقاً همان متریکی است که باعث افزایش اعداد «افزودن به سبد خرید از طریق پیشنهاد» (Add to cart from recommendation) میشود.
مدیریت کاربران و محصولات جدید
معماران تجارت الکترونیک اغلب نگران مشکل «راهاندازی سرد» (Cold Start) هستند؛ وضعیتی که در آن سیستم برای کاربر یا محصولی که تازه وارد شده، دادهای ندارد. رویکرد ترکیبی این مشکل را بدون نیاز به قواعد دستی و به صورت خودکار حل میکند:
- برای بازدیدکننده جدید: سیستم بلافاصله محصولاتی را نشان میدهد که مشابه محصولی است که کاربر در حال حاضر در حال مشاهده آن است. اگر کاربر در صفحه اصلی باشد، محصولاتی که به طور جهانی محبوب یا ترند (Trending) هستند نمایش داده میشوند. به محض اینکه کاربر ۵ اقدام یا بیشتر انجام دهد، سیستم به طور خودکار به سمت پیشنهادات شخصیسازیشده رفتاری تغییر وضعیت میدهد.
- برای محصول جدید: شباهت محصول بلافاصله با خواندن ویژگیها فعال میشود و محصول در پیشنهادات ظاهر میگردد. پس از اینکه محصول به ۱۰ خرید اول رسید، موتور مبتنی بر رفتار شروع به شناسایی آن میکند و آن را برای سایر کاربران مشابه پیشنهاد میدهد.
مقیاسپذیری با معماری توزیعشده
برای جلوگیری از کراشهای سیستم در مقیاس وسیع، باید از معماری تک-سرور فاصله گرفت. محققان یک چیدمان ساده سه-سروری (شامل یک سرور هماهنگکننده و دو سرور کارگر، که هر کدام دارای ۲ پردازنده و ۸ گیگابایت رم بودند) را برای سنجش بهرهوری آموزش مدل آزمایش کردند. نتایج زمان آموزش به شرح زیر بود:
- ۶۰٬۰۰۰ محصول: ۱۲.۸ ثانیه برای آموزش
- ۱۶۰٬۰۰۰ محصول: ۱۸.۵ ثانیه
- ۳۶۰٬۰۰۰ محصول: ۳۲.۳ ثانیه
- ۹۴۵٬۰۰۰ محصول: ۴۵.۴ ثانیه
در این آزمایش، حجم دادهها از ۶۰ هزار به ۹۴۵ هزار محصول (تقریباً ۱۶ برابر) افزایش یافت، اما زمان آموزش تنها ۳.۵ برابر بیشتر شد. این رویکرد توزیعشده همچنین افزونگی (Redundancy) حیاتی ایجاد میکند. مطالعه نشان داد که اگر یک سرور در میانه فرآیند پردازش خاموش شود، دو سرور دیگر کپیهای کافی از دادهها را دارند تا کار را به پایان برسانند. زمانی که سرور سوم دوباره آنلاین شود، سیستم خودبهخود بازیابی میشود؛ این ویژگی برای محیطهای حساس مانند جمعه سیاه ضروری است.
گردش کار پیادهسازی (Implementation Workflow)
یکپارچهسازی این سیستم در Adobe Commerce در سه مرحله مجزا انجام میشود و به عنوان یک سرویس مستقل در کنار فروشگاه عمل میکند:
مرحله ۱: جمعآوری دادهها
دادههای تعاملی از پایگاه داده MySQL به یک ذخیرهساز داده مجزا اکسپورت میشوند، زیرا MySQL برای تحلیلهای حجیم در مقیاس بالا طراحی نشده است. هر تعامل به عنوان یک رکورد ساده ثبت میشود که شامل: شناسه مشتری (Customer ID)، شناسه محصول (Product ID) و شدت سیگنال است (به طوری که «خرید» قویترین و «بازدید» ضعیفترین سیگنال است). این نیاز به استانداردسازی دادهها برای تغذیه مدلهای هوشمند، یادآور اهمیت یکپارچهسازی APIها برای افزایش کارایی عاملهای هوشمند در تجارت است تا جریان دادهها بدون شکستگی منتقل شود.
مرحله ۲: آموزش مدلها
مدلها یک یا دو بار در روز در پسزمینه (Background) آموزش میبینند. این فرآیند دادههای تعاملی را میخواند و لیستهای برتر پیشنهادات را برای هر مشتری تولید میکند، بدون اینکه هیچ تأثیری بر تجربه کاربر در لحظه خرید (Live Experience) داشته باشد.
مرحله ۳: سرویسدهی سریع
لیستهای تولید شده در Redis ذخیره میشوند؛ همان حافظه سریع (In-memory cache) که در اکثر استکهای تولیدی Adobe Commerce استفاده میشود. استورفرانت برای دریافت لیست، یک API ساده را فراخوانی میکند. زمان پاسخدهی (Response Time) میانگین ۰.۹ ثانیه اندازهبرداری شده است و در صدک ۹۵ام (95th percentile) این عدد ۱.۲ ثانیه است.
این پیشنهادات معمولاً در چهار ناحیه کلیدی ظاهر میشوند:
- صفحات جزئیات محصول («شاید اینها را هم دوست داشته باشید»)
- صفحات سبد خرید (برای استراتژیهای Upsell و Cross-sell)
- صفحه اصلی (بخش شخصیسازیشده «برای شما»)
- ایمیلهای پس از خرید و یادآوری سبدهای رها شده
مقایسه عملکرد
در مقایسه با قواعد داخلی یا افزونههای استاندارد شخص ثالث (Third-party)، روش ترکیبی مزایای متمایزی ارائه میدهد:
| ویژگی | قواعد داخلی | افزونههای Third-party | رویکرد ترکیبی |
|---|---|---|---|
| مقیاس | خیر | جزئی | بله (میلیونها کاربر/محصول) |
| مشتریان جدید | فقط قواعد دستی | محدود | بله (از طریق شباهت محصول) |
| شخصیسازی | خیر | جزئی | بله (کامل) |
| بهروزرسانیها | خیر | متغیر | بله (جریانی/روزانه) |
| خرابی سرور | خیر (تک-نقطه) | خیر | بله (پشتیبان توزیعشده) |
| دقت ۱ از ۱۰ | ۴۰–۵۰٪ | ۵۵–۶۵٪ | ۷۴٪ تأیید شده |
| سرعت پاسخ | < ۰.۱ ثانیه (کش شده) | متغیر | ۰.۹ ثانیه |
اگرچه قواعد داخلی از نظر فنی سریعتر هستند چون یک لیست یکسان را به همه میدهند، اما تأخیر ۰.۹ ثانیهای برای دریافت یک لیست کاملاً شخصیسازیشده، به طور کامل در محدوده پذیرفتهشده برای زمان بارگذاری صفحه قرار دارد.
گام بعدی شما: اجرای سه مرحلهای
برای کسانی که به دنبال پیادهسازی این سیستم هستند، یک مدل استقرار مرحلهبندی شده برای مدیریت پیچیدگیها توصیه میشود:
- فاز ۱: فقط شباهت محصول. ویجتهای «محصولات مرتبط» را با پیشنهادات مبتنی بر شباهت (که بر اساس توضیحات و اتریبیوتهاست) جایگزین کنید. این یک برد سریع (Quick Win) با پیچیدگی بسیار پایین است.
- فاز ۲: افزودن شخصیسازی. تاریخچه سفارشات ۱ تا ۲ سال اخیر را استخراج کرده و مدل رفتاری را آموزش دهید. نتایج شخصیسازیشده را به کاربران وارد شده (Logged-in) نشان دهید و برای کاربران مهمان، از شباهت محصول به عنوان جایگزین (Fallback) استفاده کنید.
- فاز ۳: ترکیب کامل و خودکارسازی. هر دو سیگنال را با امتیاز وزنی ۶۰/۴۰ ترکیب کنید. بازآموزی شبانه خودکار را فعال کرده و سیستم رهگیری (Tracking) را پیاده کنید تا متوجه شوید کدام پیشنهادات نرخ تبدیل بیشتری دارند.
این تغییر مسیر، موتور توصیهگر را از یک وظیفه اداری و استاتیک به یک خط لوله (Pipeline) پویای علوم داده تبدیل میکند. این رویکرد نیاز به نوشتن دستی قواعد را از بین میبرد و اجازه میدهد رشد ارگانیک کاتالوگ، منطق کشف محصولات را خودش پیش ببرد. اما بهینهسازی لایهی ذخیرهسازی برای کاهش بیشتر تأخیر استنتاج، گام بعدی این تکامل است — به تحلیل ما دربارهی Redis و حافظههای سریع مراجعه کنید.



گفتگو