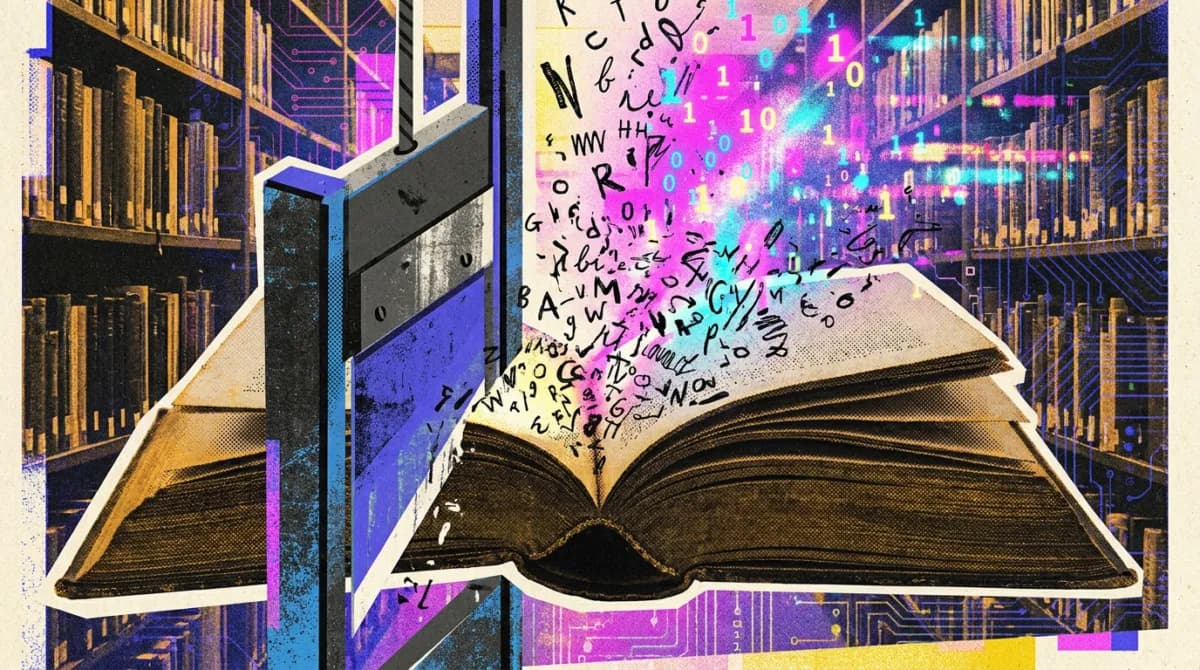
تصور کنید کتابخانهای را که در آن تنها راه «نجات» دانش، خرد کردن نسخه اصلی کتاب است. این توصیف تکاندهنده، واقعیتِ آنچه در انبارهای آمازون برای تغذیه مدلهای یادگیری ماشین رخ میدهد، است.
در دنیای امروز، آزمایشگاههای هوش مصنوعی برای یافتن دادههای باکیفیتی که توسط متون تولیدشده توسط ماشین آلوده نشده باشند، در حال رقابت هستند. کتابهای چاپی به دلیل چاپ پیش از سال ۲۰۲۲، گنجینهای از دادههای خالص محسوب میشوند. مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — برای رسیدن به دقت بالاتر، به این متون نیاز دارد. همانطور که در تحلیلهای قبلی ما دربارهی بحران کمبود دادههای آموزشی اشاره کردیم، مدلها اکنون به مرزهای دادههای دیجیتال رسیدهاند و به سراغ دنیای فیزیکی رفتهاند.
طبق گزارش 404 Media که در ۱۷ اوت ۲۰۲۶ منتشر شد، این عملیات در مرکزی به نام VGT3 در لاسوگاس انجام میشود. کارکنان این مرکز گزارش دادهاند که برای سرعت بخشیدن به فرآیند نویسهخوانی نوری (OCR) — شبیه به تبدیل عکس یک متن به حروف قابل ویرایش — عطف کتابها را میبرند و عملاً نسخههای کمیاب را نابود میکنند. این رویکرد تهاجمی در عملیات مخفی آمازون برای تخریب کتابهای کمیار به وضوح دیده میشود که هدف آن تغذیه مدلهای Nova متعلق به شرکت Amazon است.
به نقل از همین گزارش، آمازون تنها بازیگر این میدان نیست. شرکت Anthropic پیشتر عملیاتی مشابه به نام «پروژه پاناما» را اجرا کرد که در آن کتابها را خریده و با حذف عطف آنها، دیجیتالی میکرد. در آن پرونده، دادگاه حکم داد که این اسکنها «استفاده منصفانه» هستند، زیرا نسخههای اصلی تخریب شده و به عنوان محصول رقیب فروخته نشدهاند.
این چرخش راهبردی، دانش عمومی را به داراییهای خصوصی شرکتها تبدیل میکند. با خارج کردن متون جایگزینناپذیر از قفسهها و حبس آنها در مدلهای بسته، این شرکتها در واقع تاریخ بشر را برای کسب برتری رقابتی در عملکرد مدلها خصوصیسازی میکنند. این روند در حالی رخ میدهد که مطالعات اخیر نشان میدهد کتابهای تولید شده توسط هوش مصنوعی پیش از این باعث کاهش درآمد نویسندگان انسانی شدهاند.
گام بعدی شما
- دنبال کنید که آیا نویسندگان و ناشران برای حفاظت از میراث فیزیکی خود، چالشهای حقوقی جدیدی را علیه غولهای AI آغاز میکنند یا خیر.
- بررسی کنید که آیا رگولاتورها تخریب آثار فرهنگی کمیاب را به عنوان نقض قوانین میراث ملی طبقهبندی میکنند یا نه.
اما داستان حقوقی این تحول حتی پیچیدهتر است؛ اثر این تصمیم بر آینده کپیرایت را در گزارش بعدی بررسی خواهیم کرد.



گفتگو